Что это вообще за штука
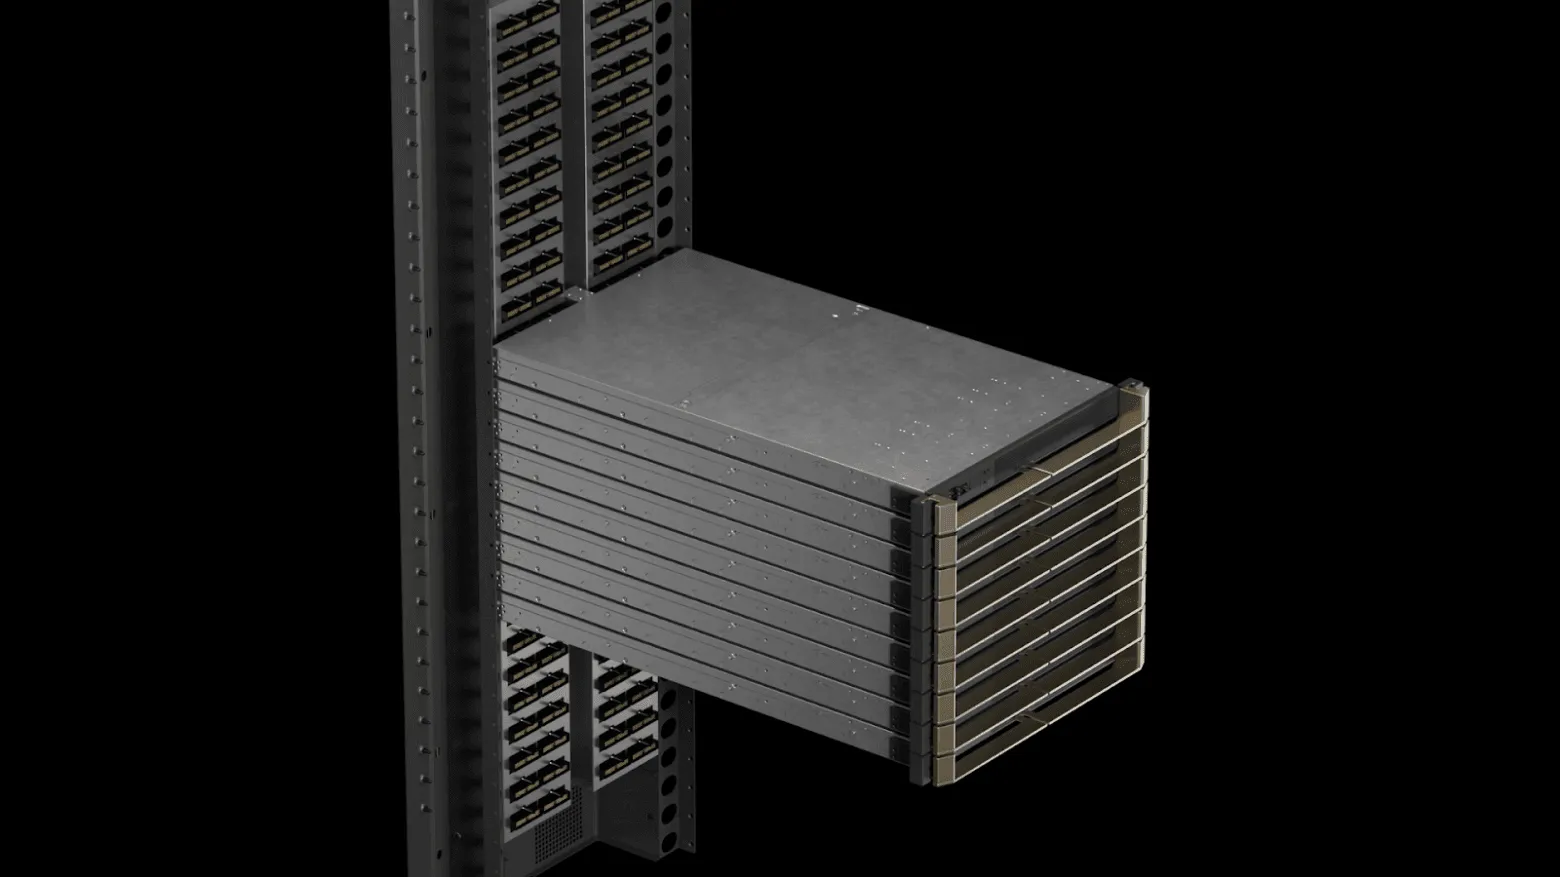
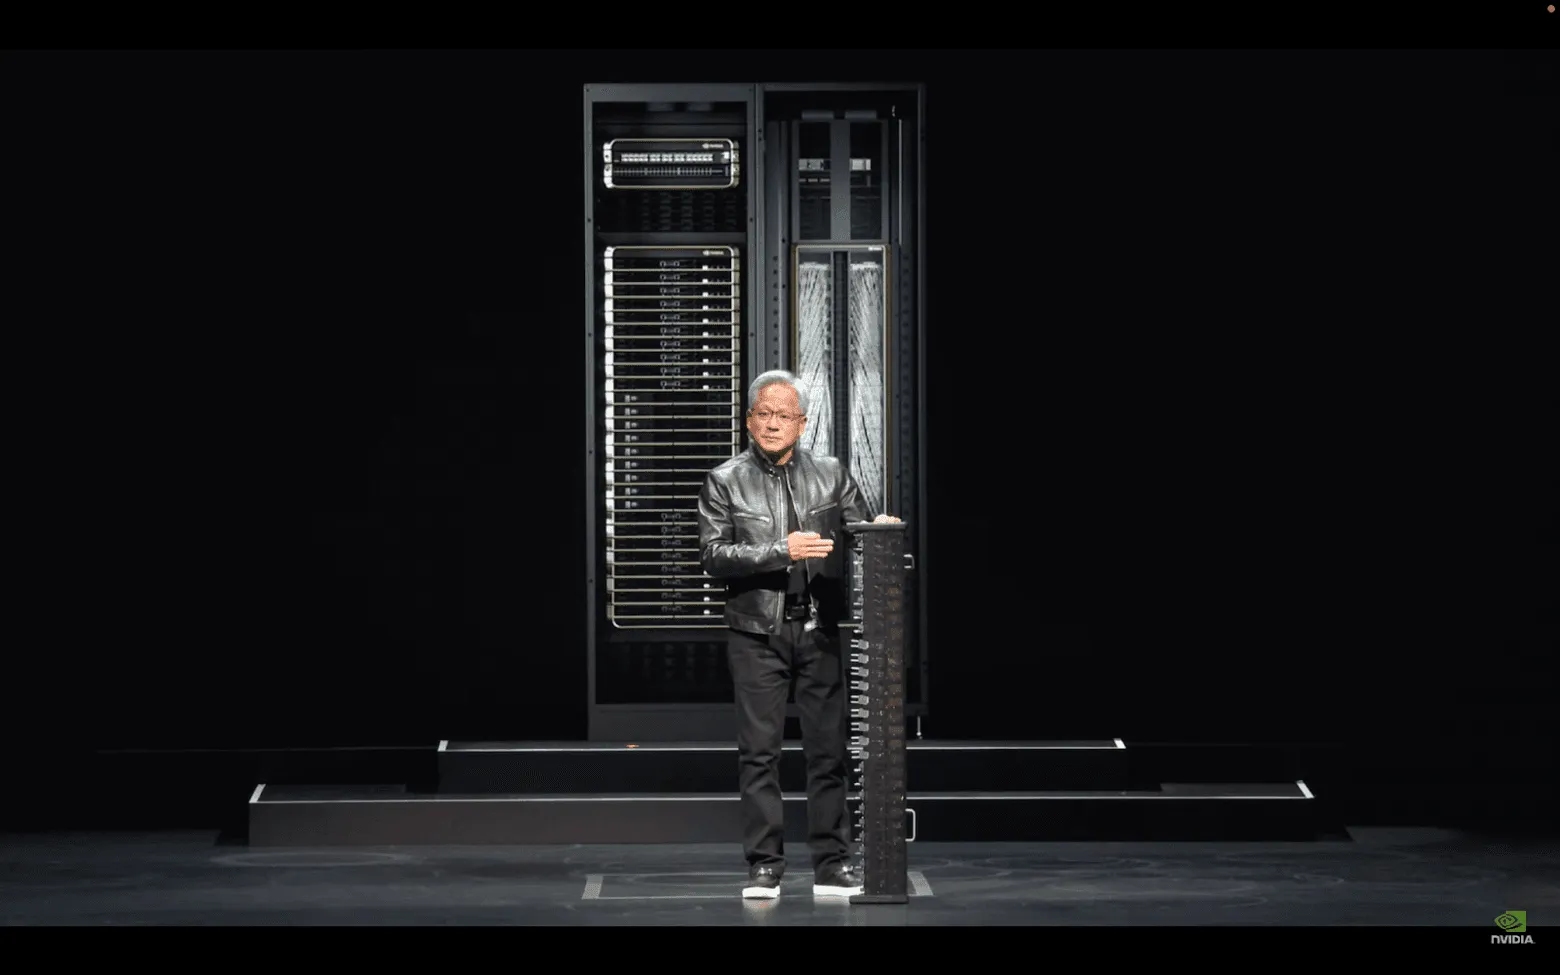
Один из самых свежих примеров — сервер уровня NVL72.
NVL72 — это конфигурация суперсервера от Nvidia, в которой 72 графических процессора (GPU) объединены в одну систему и работают как единый вычислительный блок. Это не сервер в классическом смысле, а готовый модуль для сборки AI-кластера:
-
72 GPU (видеокарты, но для ИИ);
-
36 CPU (обычные процессоры);
-
жидкостное охлаждение (как радиатор у машины, только сложнее).
Важный момент: это не 72 отдельных компьютера. Они работают как единый суперчип.
Почему ИИ требует таких монстров
Современные модели ИИ — это не просто большие программы, а системы с сотнями миллиардов параметров. Эти параметры нужно постоянно пересчитывать и обновлять — причём не один раз, а миллиарды раз в процессе обучения. Один GPU с этим не справляется — ни по памяти, ни по скорости. Поэтому модель разбивают на части и распределяют по десяткам или сотням GPU.
Но дальше возникает главная сложность. Каждый шаг обучения состоит из двух фаз:
1. Вычисления (GPU считает свою часть модели).
2. Синхронизация (все GPU обмениваются результатами).
И вот вторая часть часто оказывается медленнее первой.
После каждого шага GPU должны:
-
обменяться градиентами (результатами вычислений);
-
обновить общие веса модели;
-
синхронизироваться, чтобы двигаться дальше одновременно.
Объёмы данных при этом огромные: речь идёт о гигабайтах и даже терабайтах информации, которые нужно передавать между GPU на каждом шаге. Если эта передача занимает слишком много времени — GPU простаивают.
Именно поэтому ключевая технология здесь — не сами вычисления, а связь между GPU. В обычных системах обмен идёт через центральный процессор и ограниченные каналы. В AI-серверах используется другая архитектура: GPU соединяются напрямую через NVLink и объединяются коммутаторами NVSwitch.