Поздравляем! Вы уже изучили все темы образовательного блока и сейчас подходите к заключительному заданию.
Эта задача похожа на те, что решают Python-разработчики на практике. Она поможет вам повторить пройденный материал и применить полученные знания.
Задача состоит из нескольких блоков:
Контекст. В реальной жизни задача не существует сама по себе, а возникает из определённого бизнес-контекста. Поэтому мы добавили небольшое описание трансформации задачи от первого запроса до её финального вида.
Подсказки. Помощь в решении, если зайдёте в тупик. Комментарии к ключевым моментам решения задачи в формате FAQ.
Разбор. Подробный разбор задачи от автора, специалиста из Яндекса: от составления алгоритма решения до реализации и пояснения каждого блока кода.
Важно: это задача со звёздочкой. Она посложнее предыдущих. Если не справитесь — ничего страшного: в программировании редко что-то получается с первого раза. Сделайте паузу, перечитайте теорию и возвращайтесь с новыми силами и хорошим настроением.
Повторите:
Строки, кортежи, списки.
Словари.
Работу с текстовыми файлами, формат JSON.
Изучите дополнительно:
Работу с текстовыми файлами в формате CSV.
Работу с датами и временем с использованием типа данных datetime.
Базу данных. Основы устройства.
И ещё один совет напоследок: рекомендуем работать с задачей последовательно:
Изучите контекст.
Ознакомьтесь с условием задачи и пожеланиями.
Попробуйте решить её самостоятельно в Яндекс Контесте.
Если понадобится помощь — обратитесь к подсказкам. Если совсем тяжко — изучите разбор и попробуйте после самостоятельно решить.
Когда решите задачу, сравните свой вариант с решением специалиста.
Желаем удачи!
Чтобы добавить в заметки выделенный текст, нажмите Ctrl + E
Я Максим, разработчик в Яндекс Учебнике. Ниже мы с вами создадим симуляцию простого веб-приложения, задача которого — помочь учителю увидеть статус решения учениками тестов по конкретному предмету. Вы примете запрос, обработаете его, запросите необходимые данные из базы данных и вернёте обратно ответ в формате JSON. Удачи!
Взаимодействие между фронтендом и бэкендом
Вы уже прошли базовые конструкции в виде циклов, списков/кортежей, множеств. Этих знаний достаточно, чтобы собрать часть веб-приложения — ту, что отвечает за обработку запросов. Ниже мы разберём, каким образом его собрать и в чём заключается роль бэкенд-разработчика.
Итак, мы разрабатываем сервис для подготовки к ЕГЭ. В нём учителя смогут набирать себе группы, раздавать тесты, проводить занятия. А ученики — изучать материал, решать тесты, посещать занятия.
Чтобы учитель мог удобнее работать, у него есть личный кабинет. Это раздел, в котором можно получать всю необходимую информацию, — дашборд.
Давайте посмотрим на примере этой одной конкретной фичи, как устроены веб-приложения. В общем виде схема выглядит так:
Такую схему ещё называют «трёхуровневая архитектура веб-приложения». Она самая распространённая. В ней каждая часть отвечает за свою конкретную задачу:
интерфейс/клиент — за взаимодействие с пользователем;
веб-сервер — за бизнес-логику работы приложения;
базы данных — за хранение данных.
Видов архитектур веб-приложений много, у них разные плюсы и минусы, подробно останавливаться на них сейчас не будем: выбором архитектуры занимаются разработчики уровня senior и выше. Так что эта информация для общего контекста и расширения кругозора — чтобы вы знали, какие вещи стоит прокачивать в будущем.
Далее разберём на нашем примере, как пошагово работает наше приложение.
Когда учитель открывает кабинет, браузер сразу рисует красивую «витрину»: кнопки, таблицы, графики. То, что видит пользователь на экране и с чем может взаимодействовать, называется фронтенд-частью веб-приложения. Ещё её называют «интерфейс», «клиент», UI и так далее. Разработкой этой части, как нетрудно догадаться, занимаются фронтенд-разработчики.
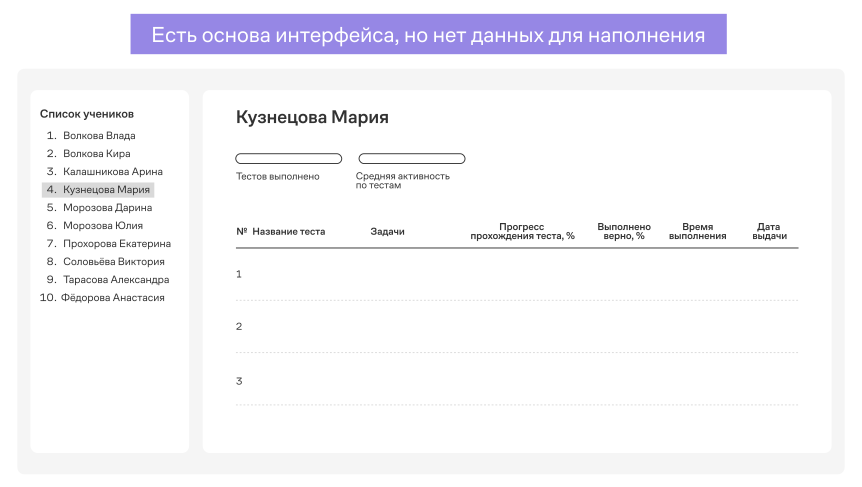
Как только странице требуются данные — например, список учеников или список выданных ученикам тестов, — она отправляет текстовое сообщение на сервер и ждёт ответа. В этот момент страница может выглядеть так:
Часть веб-приложения, которая получает и обрабатывает запрос, называется бэкенд-частью. Обычно бэкенд состоит из веб-сервера (обработчика запроса) и базы данных (из которой собираются данные).
На Python вы напишете веб-сервер для обработки запроса. Сначала он примет его и разберёт, что именно просит пользователь и какие поля из базы данных нужно вернуть, в каком виде их удобнее отдать. Разобравшись, ваш веб-сервер формирует запрос к базе данных.
База данных — структурированное хранилище данных и связей между ними, позволяющее быстро найти нужные данные. Сама база данных может выглядеть по-разному. Чаще всего это привычные SQL-таблицы — надёжные, быстрые, с богатым языком запросов. Но иногда хватает книги Excel или CSV-файла, если данных мало и их нужно легко открыть вручную.
В других случаях удобнее хранить целые документы в формате JSON или использовать хранилище пар «ключ — значение». Важно лишь, что Python-программа умеет обратиться к любому из этих источников и вытащить ровно то, что попросил интерфейс.
Получив записи, сервер при необходимости сразу делает расчёты — скажем, подсчитывает средний балл по тесту — и упаковывает результат в ответ. Чаще всего используется JSON: его одинаково хорошо читают и человек, и браузер. Но для простых таблиц сгодится CSV. Выбор зависит от того, что проще для интерфейса и быстрее для сервера.
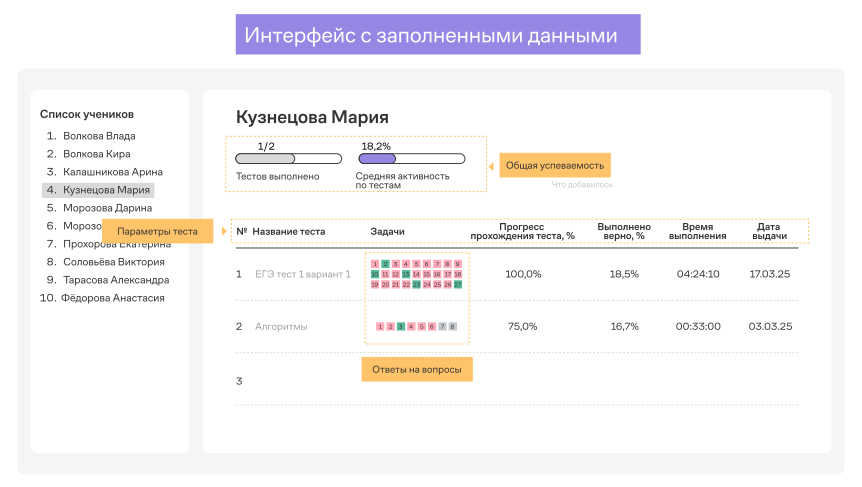
Затем интерфейс забирает данные и выводит их пользователю:
Как видите, получается реализованная цепочка: интерфейс → сервер → база данных → сервер → интерфейс. При этом сервер может обращаться к разным базам данных, и тогда цепочка взаимодействия удлинится.
Эту цепочку вы и реализуете в рамках задачи: примете запрос, решите, какие данные нужны и в каком виде, достанете из базы, посчитаете необходимые параметры и вернёте аккуратный JSON. После этого интерфейс наполнится реальными цифрами, а вы увидите, как ваш код становится частью живого веб-приложения.
Не переживайте, если формулировка кажется сложной: для решения задачи будет достаточно текущих знаний. А если зайдёте в тупик, мы подготовили подсказки — они направят вас в нужную сторону.
Формулировка задачи
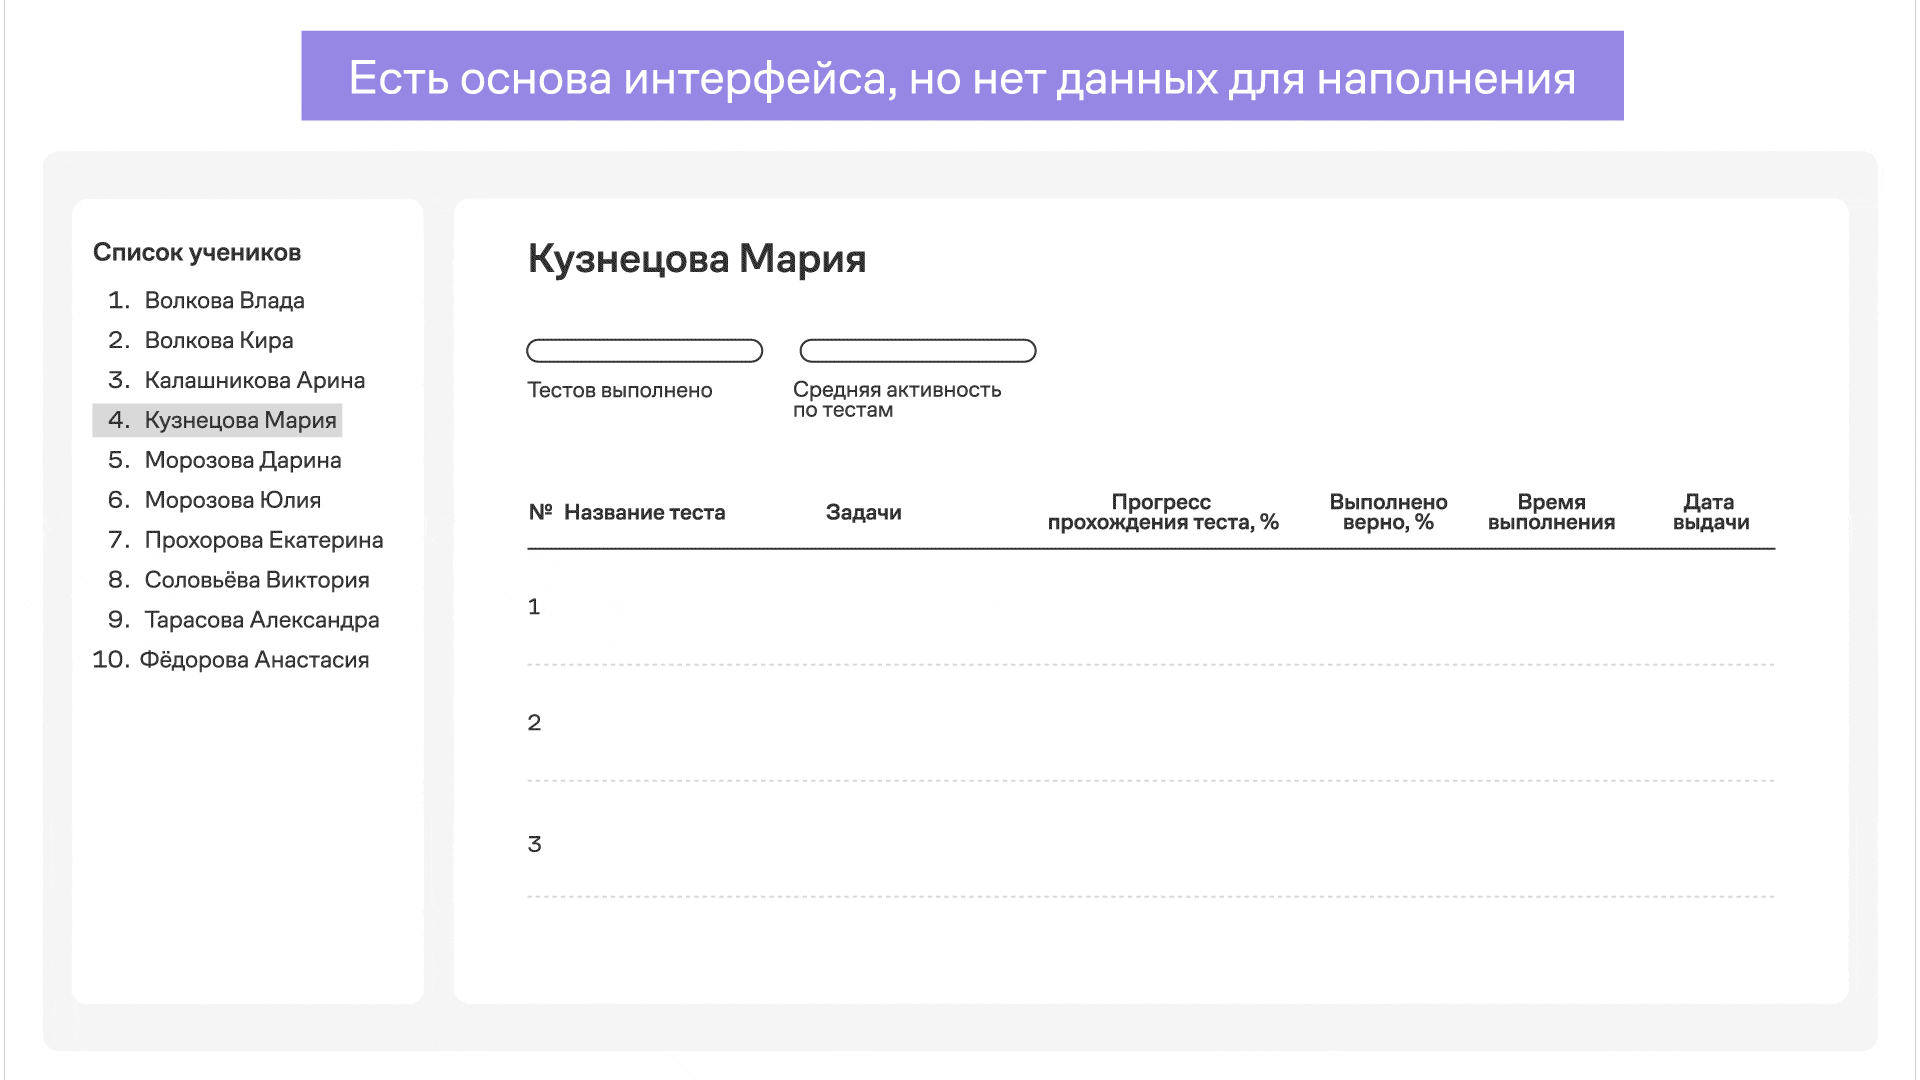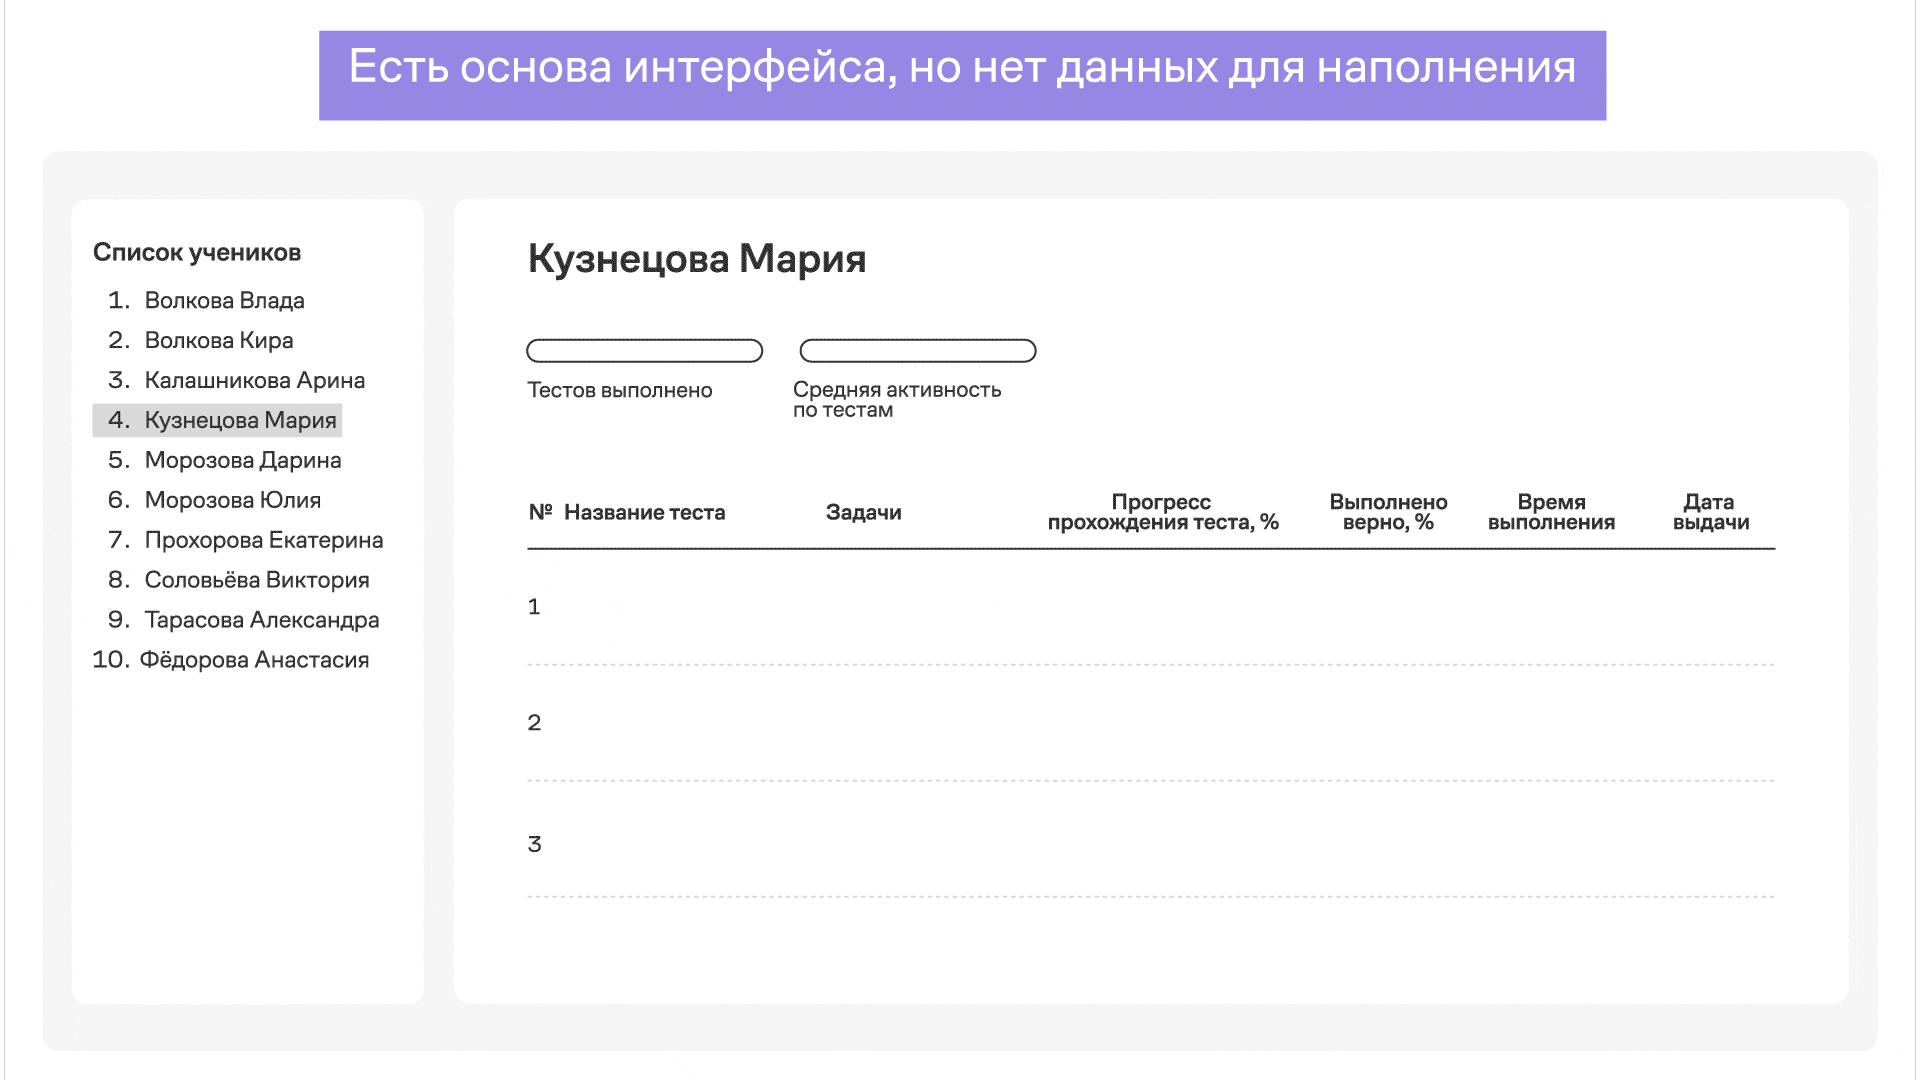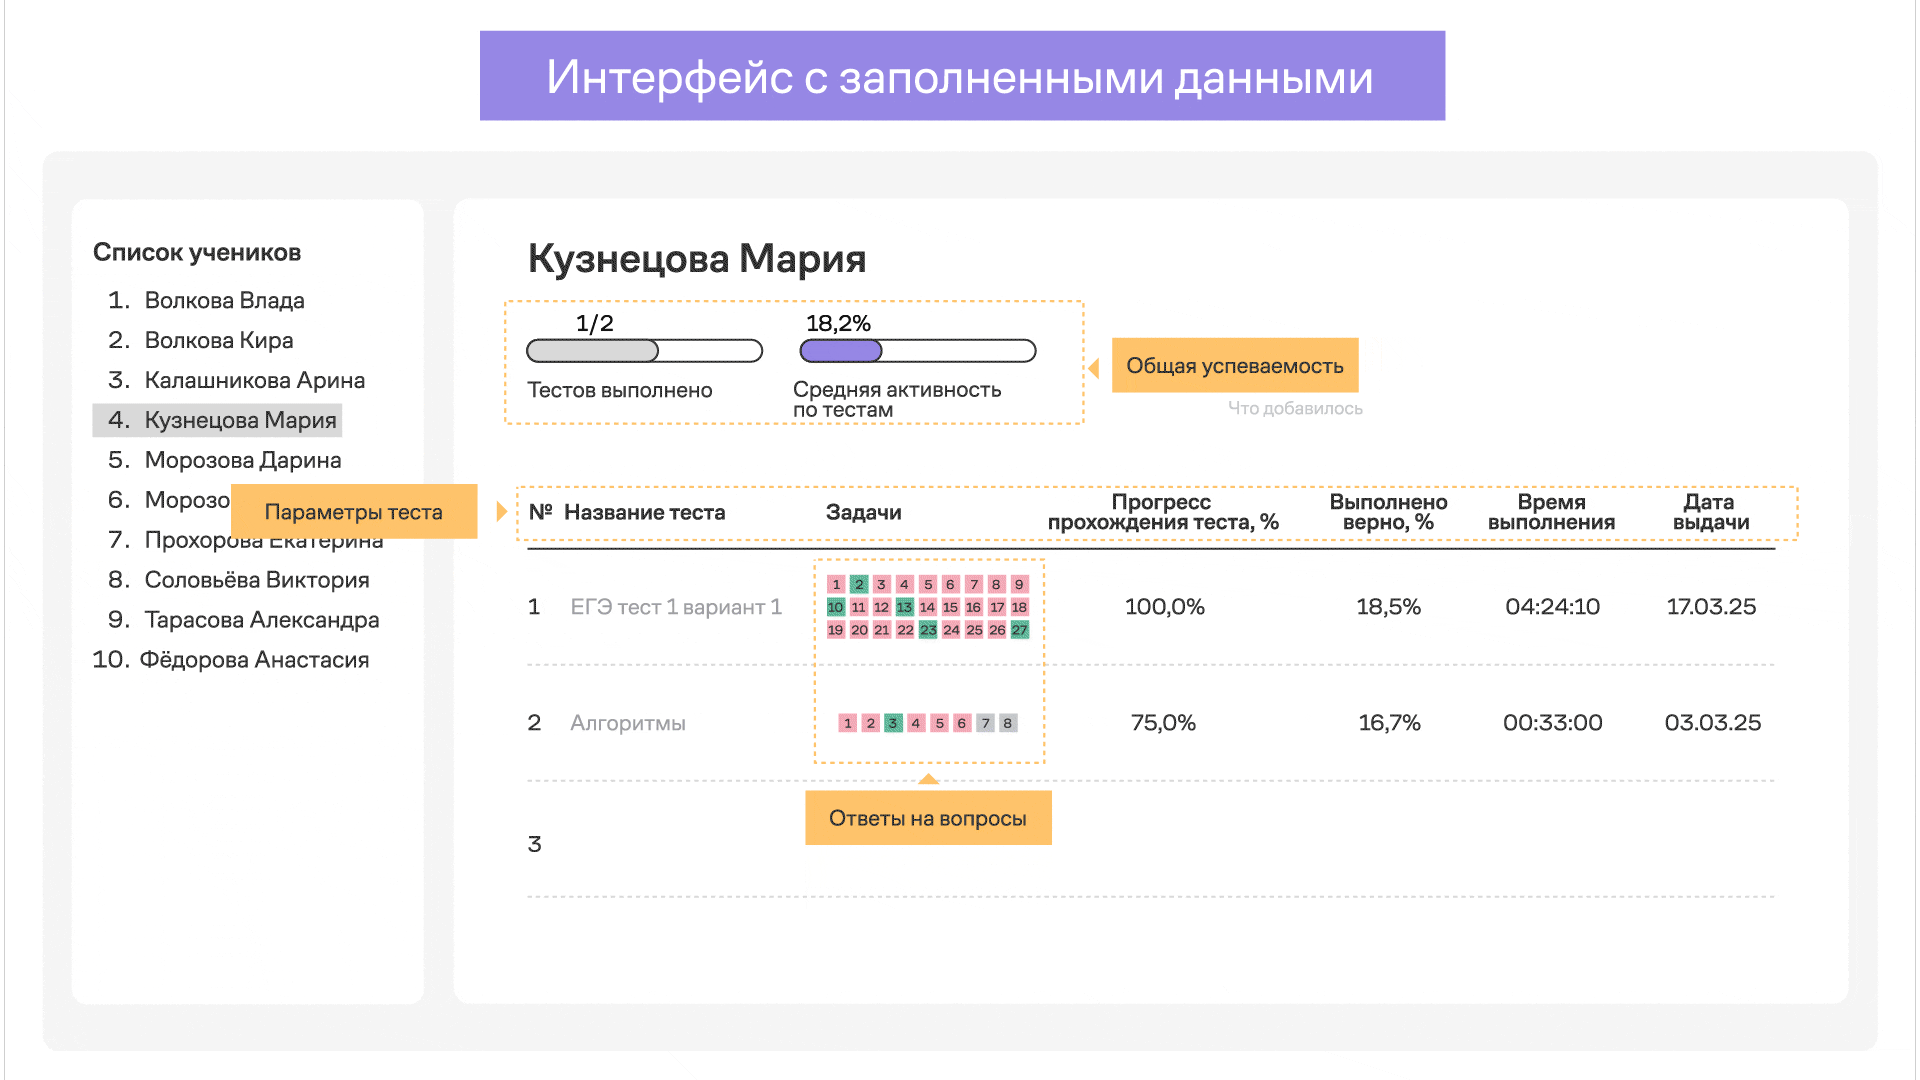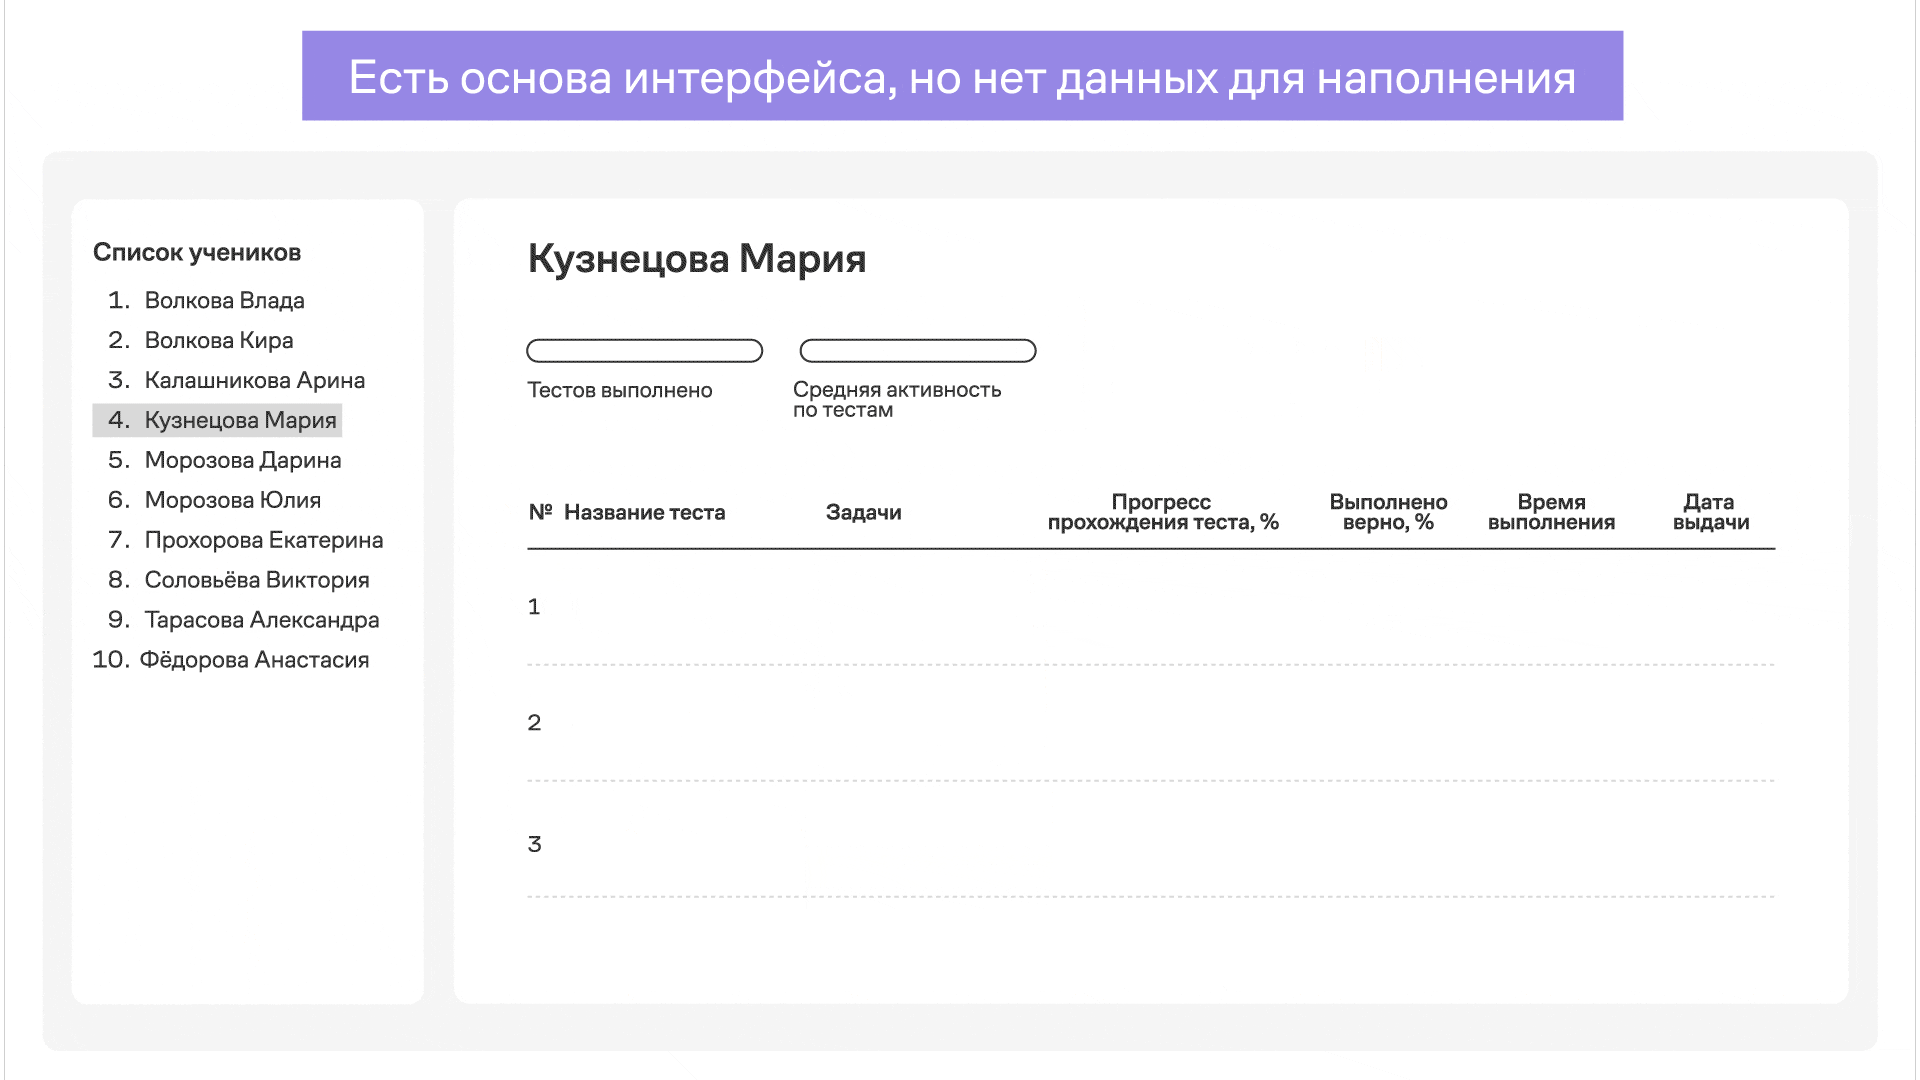
К вам пришёл продакт-менеджер и поставил задачу: подготовить обработку запросов от фронтенда для кабинета учителя. А конкретно — для экрана, представленного ниже.
Учитель выбирает ученика из класса, и на экран подтягивается статистика по всем выданным и пройденным тестам и результатам их прохождения. В формате запроса вы получаете параметры ученика, а на выходе возвращаете JSON со всеми необходимыми данными. Данные хранятся в небольшой базе данных, собранной из девяти CSV-файлов.
Чтобы не заниматься сразу большой задачей, мы разбили её на несколько последовательных подготовительных задач. Благодаря этому вы шаг за шагом придёте к финальному решению основной задачи, используя наработки.
Ниже мы собрали более подробную информацию об устройстве базы данных и несколько новых небольших инструментов, которые помогут справиться с задачей.
Структура базы данных
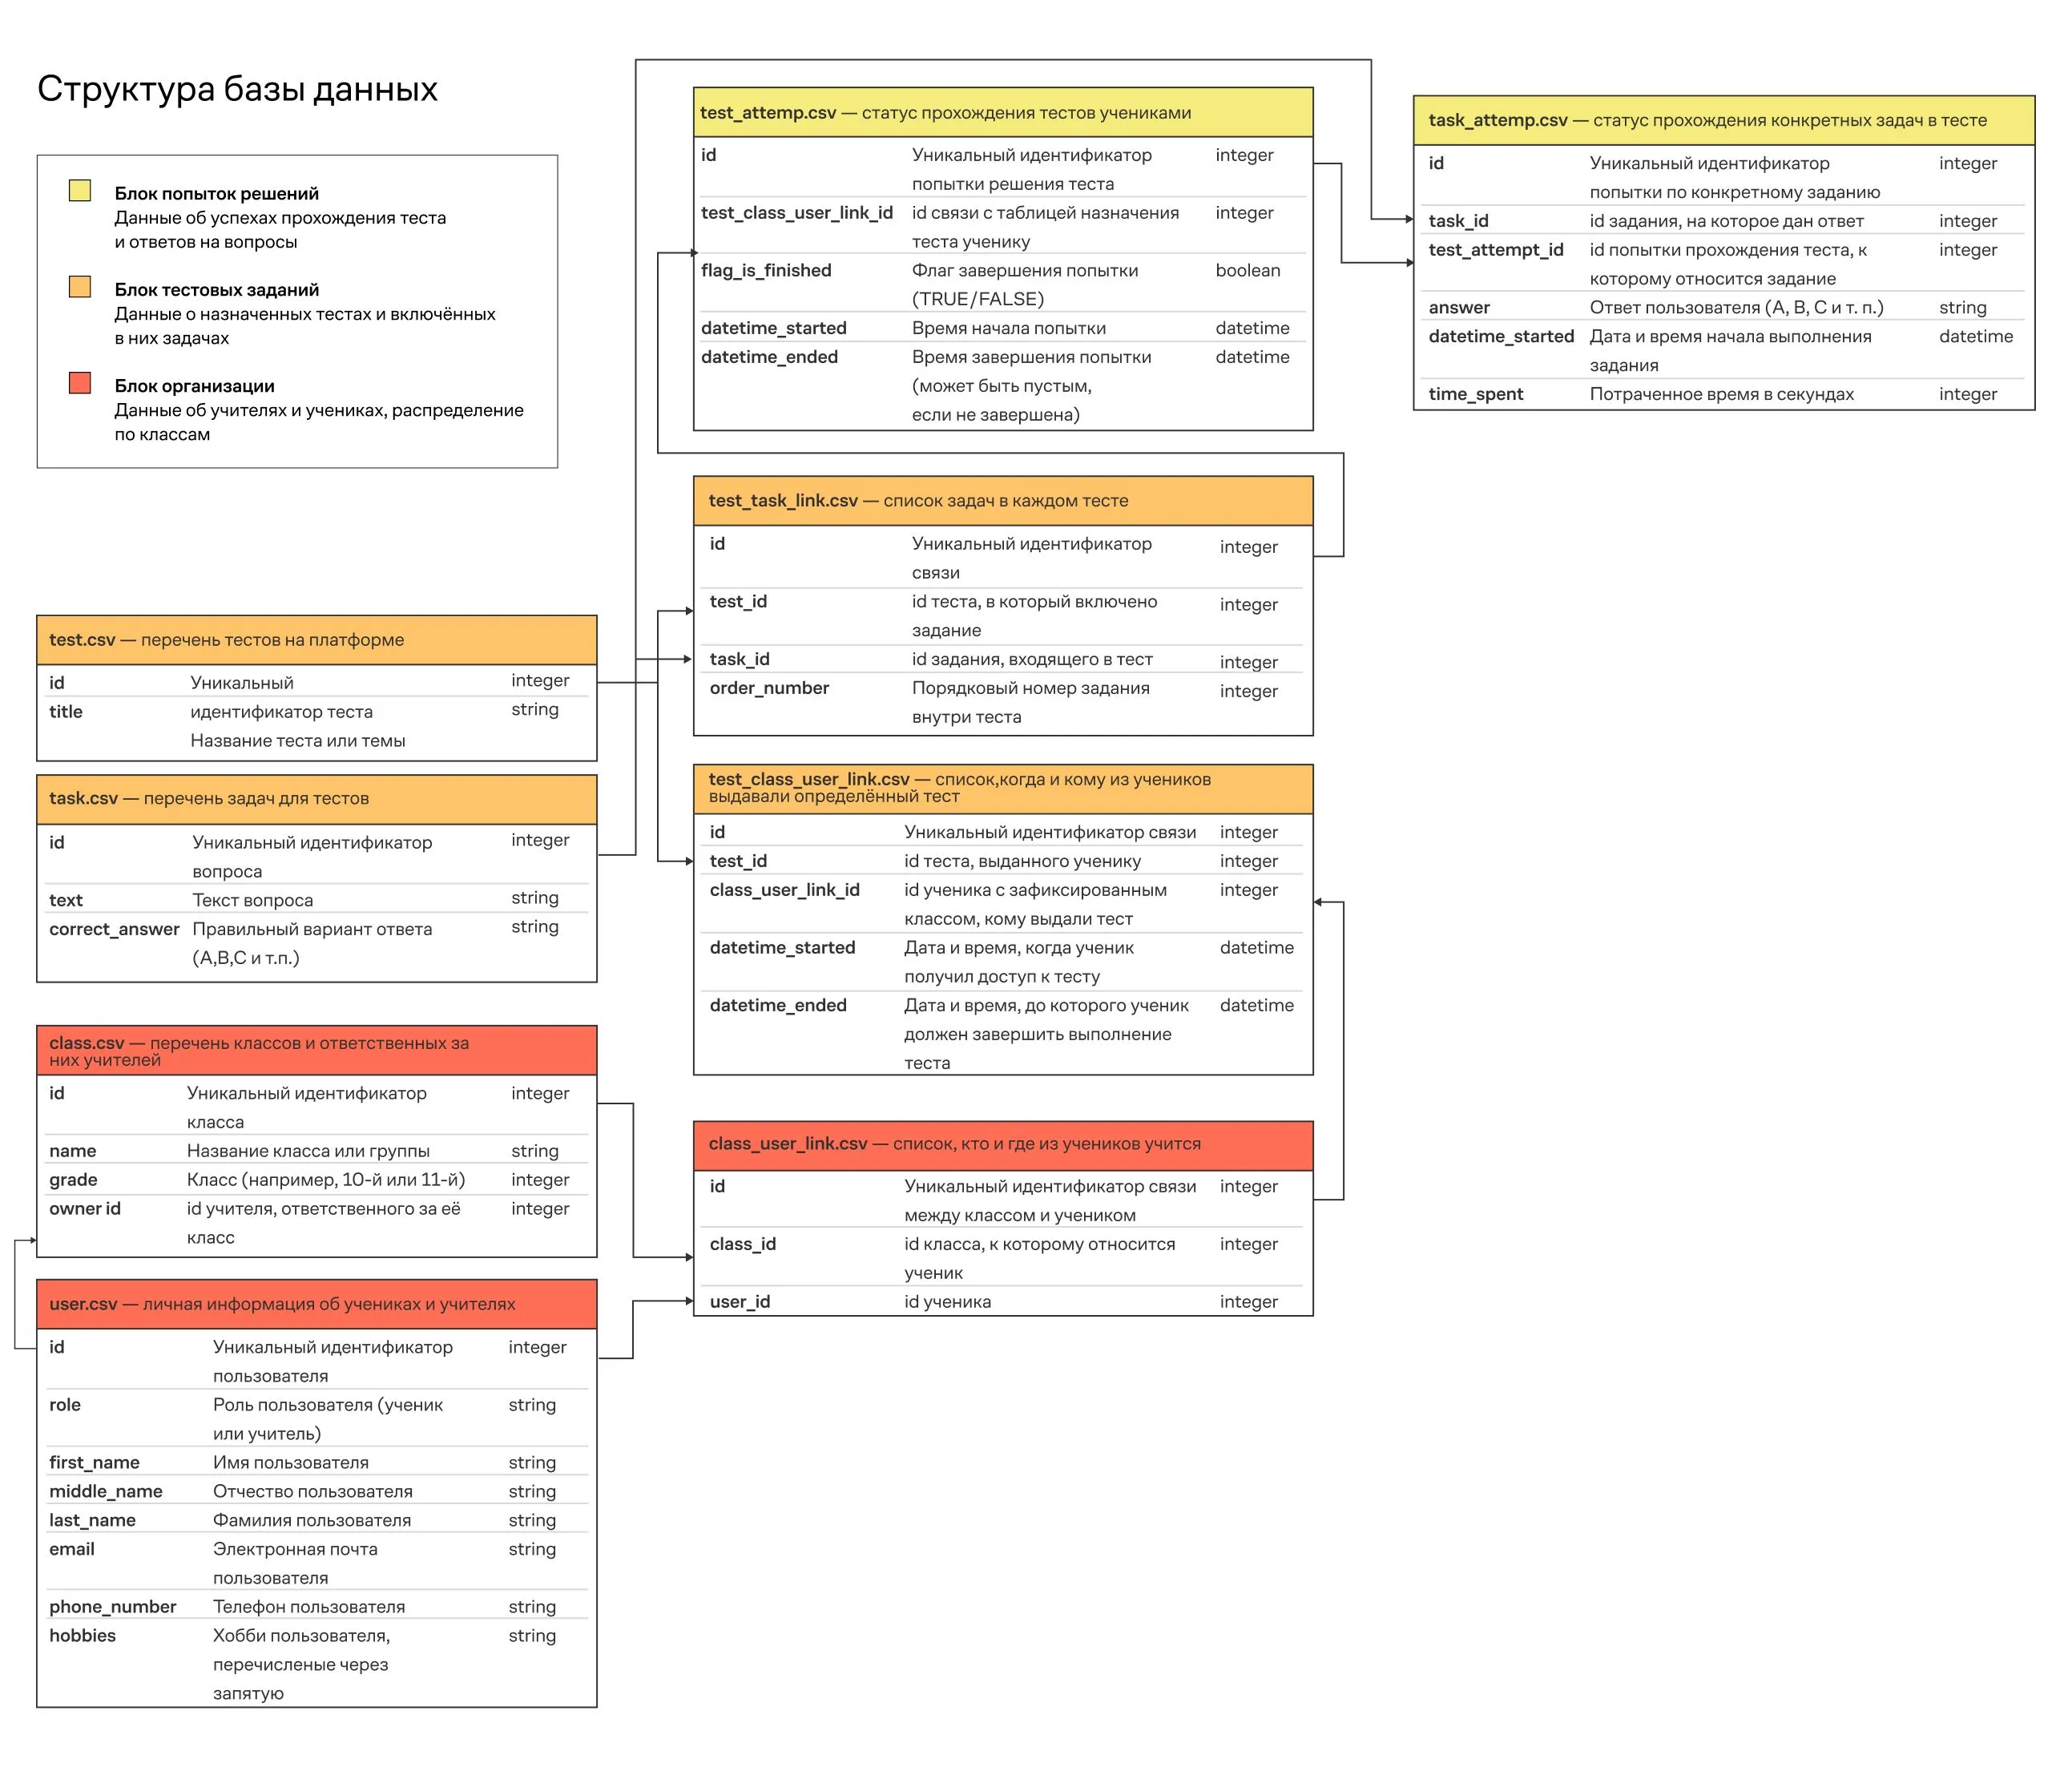
База данных — это структурированное хранилище информации, в котором можно быстро найти всё необходимое, и связей между данными. Как мы сказали выше, информация в рамках задачи лежит в базе данных, состоящей из девяти файлов формата CSV.
CSV-файл — это обычный текстовый файл, в котором данные хранятся в виде таблицы, но не как таблица в Excel, а в виде строк текста, где значения разделяются запятыми (или другими символами), например:
Данные выглядят как таблица, но это просто текст. Если вы откроете такой файл в блокноте, вы увидите именно это.
Структура файла следующая:
Каждая строка — это одна строка таблицы.
Каждое значение в строке — это ячейка, отделённая запятой.
Первая строка обычно содержит заголовки столбцов (названия).
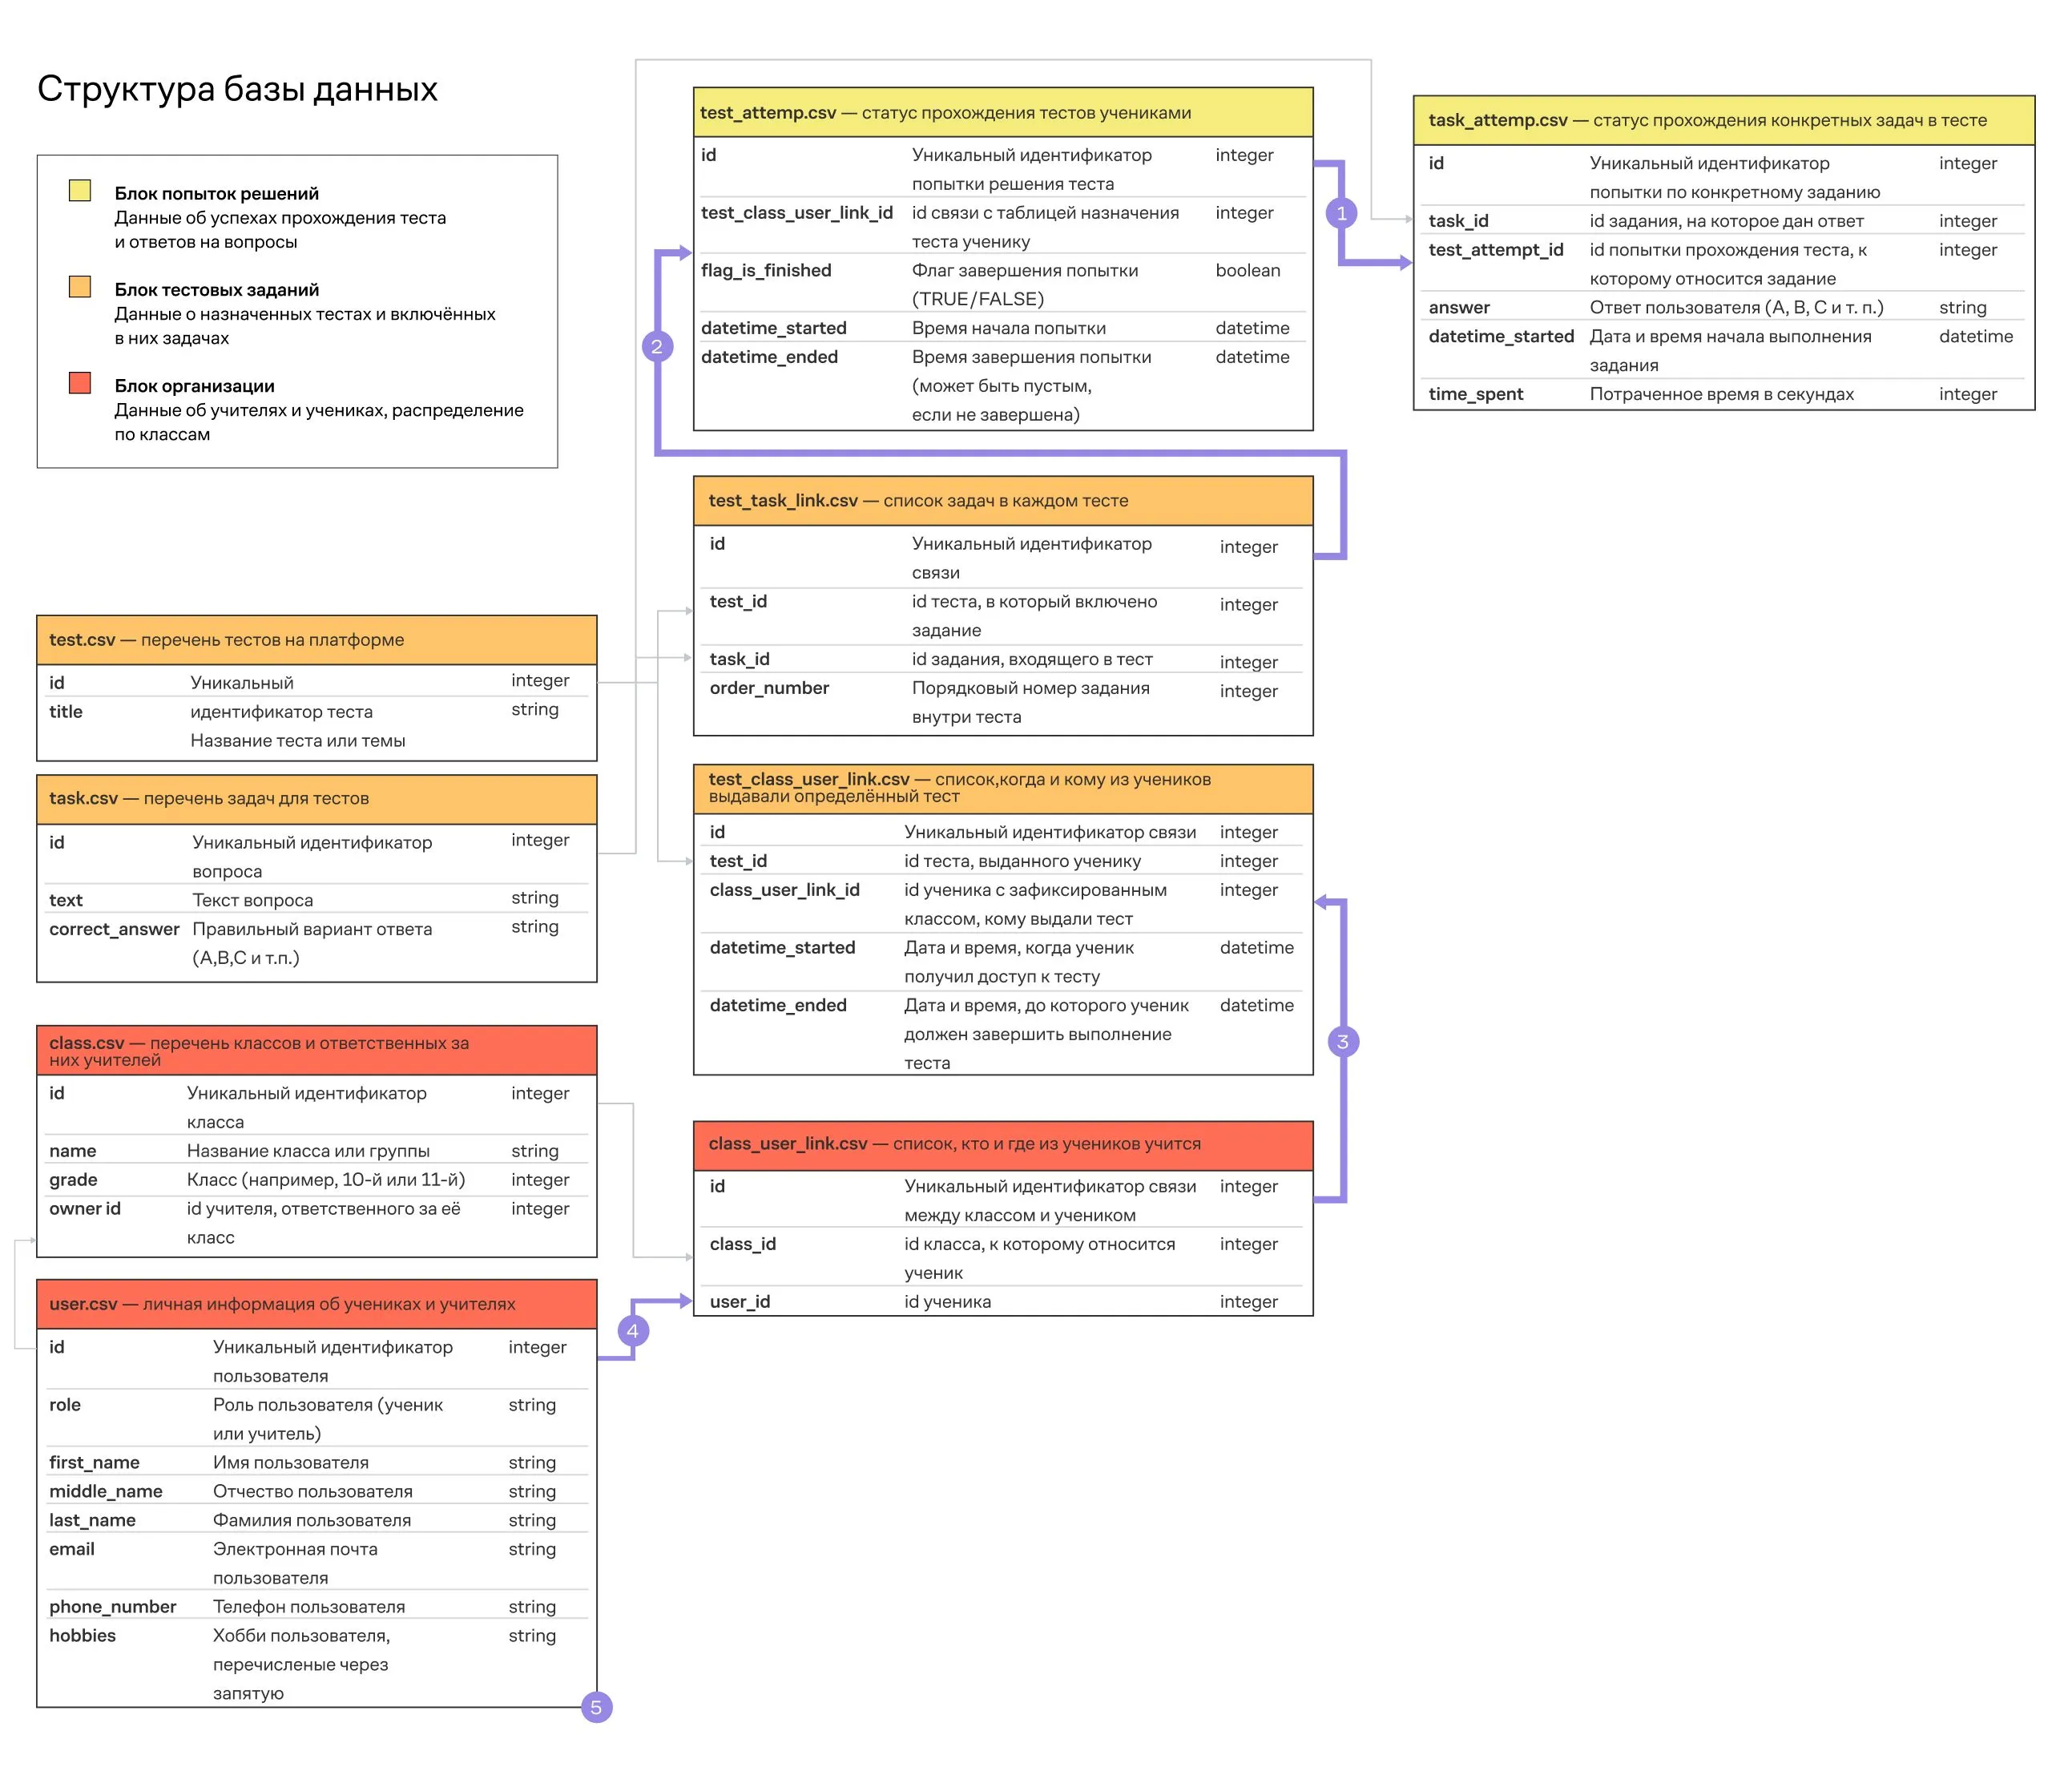
Содержимое и форматы данных (изначально все данные в строковом формате, но при желании их можно перевести) в каждой из девяти таблиц описаны на картинке ниже. Здесь можно скачать картинку в полном разрешении.
Организационный блок (информация о пользователях и их связи):
user.csv — личная информация об учениках и учителях
class.csv — перечень классов и ответственных за них учителей
class_user_link.csv — список, кто и где из учеников учится
Блок тестовых заданий (тесты, задачи, назначение задач конкретным классам):
task.csv — перечень задач для тестов
test.csv — перечень тестов на платформе
test_task_link.csv — список задач в каждом тесте
test_class_user_link.csv — список, когда и кому из учеников выдали определённый тест
Попытки (успехи учеников в прохождении тестов и конкретных задач):
test_attempt.csv — статус прохождения тестов учениками
task_attempt.csv — статус прохождения конкретных задач в тесте
Давайте разберёмся, что обозначают конкретные данные в таблицах и что это за стрелочки.
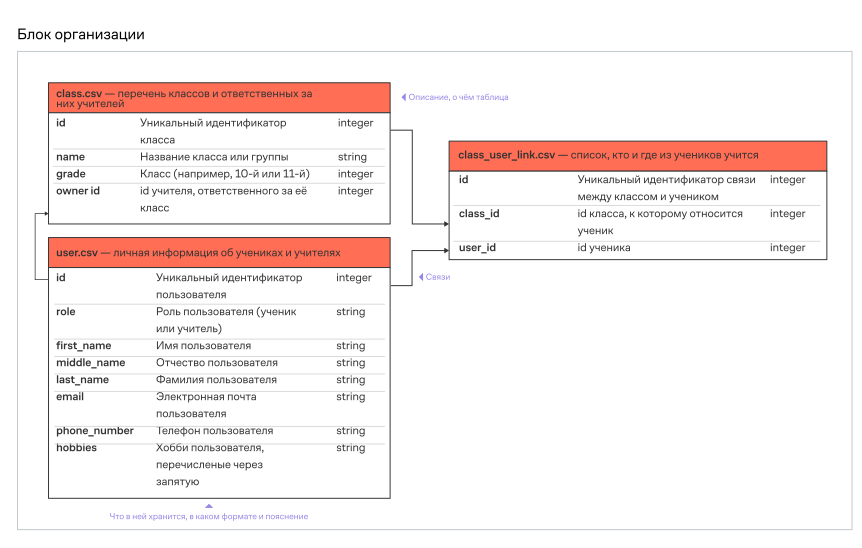
Для примера возьмём оранжево-красный блок базы, посвящённый организации, и изучим подробнее таблицу user.csv.
В каждой таблице:
Есть описание, что в ней лежит. В user.csv лежит личная информация об учениках и учителях на платформе.
Есть два типа хранимых данных:id (уникальный номер строчки для этой таблицы) и данные для этого уникального номера. В нашем файле лежат: роль пользователя, Ф. И. О., электронная почта, номер телефона, хобби, дата создания записи и дата последнего обновления.
Для каждого вида данных есть пояснение.
Если открыть файл user.csv в текстовом редакторе, то он будет выглядеть следующим образом. Каждая строчка отдельно посвящена уникальному ученику или учителю. А через запятую будут раскрываться все данные. При этом если какой-то параметр пустой, то он всё равно будет отделяться запятыми, вот так: «... ,, ...».
Note title
Посмотрите, какие данные с картинки выше лежат в таблице user.csv, и соотнесите с данными в блоке ниже. Убедитесь, что все данные представлены.
Ещё между таблицами есть различные стрелки. Они отображают связи. Давайте посмотрим на таблицу class.csv. К owner_id идёт стрелочка из id таблицы user.csv. Это значит, что данные в owner_id содержат конкретные id из user.csv.
Разберём на конкретном примере. Откроем файл class.csv и посмотрим значение owner_id у первой строчки с данными. Оно будет равно 96. Это значит, что если мы хотим посмотреть, кто является ответственным за класс, то нужно будет сходить в таблицу user.csv и найти строчку с полем id, равным 96. Это и будет наш учитель, ответственный за этот класс.
id,name,grade,owner_id 1,Новички 1,10,96
2,Базовая группа 1,11,97
3,Продвинутая группа 1,10,98
4,Новички 2,10,99
5,Базовая группа 2,11,100
6,Продвинутая группа 2,11,96
7,Новички 3,11,97
8,Базовая группа 3,11,98
9,Продвинутая группа 3,10,99
10,Новички 4,11,100
11,Новички 5,10,196
12,Базовая группа 4,11,197
13,Продвинутая группа 4,10,198
14,Новички 6,10,199
15,Базовая группа 5,11,200
16,Продвинутая группа 5,11,196
17,Новички 7,11,197
18,Базовая группа 6,11,198
19,Продвинутая группа 6,10,199
20,Новички 8,11,200
Пользователь с id, равным 96, — это учитель Екатерина Сергеевна Лебедева. Она и является ответственной за класс с id, равным 1, в таблице class.csv.
Тут у вас может возникнуть вопрос: почему бы не схлопнуть все данные просто в одну большую таблицу и не работать с ней?
В пользу разделения на отдельные структуры есть два аргумента:
Дублирование данных. В одной большой таблице будет большое количество дублирования одних и тех же данных. А если какого-то блока информации у части данных пока нет, то приличная часть данных будет ещё и просто пустой.
Нам не потребуются все данные. Для поиска нужных данных не надо просматривать их все, а лишь определенную таблицу или несколько таблиц. Это ускорит процесс.
Теперь давайте попробуем проделать маленькое упражнение на закрепление. Какие Ф. И. О. у ученика, который в task_attempt.csv делал попытку под id со значением 100?
Ответ (не открывайте сразу, сначала подумайте сами!)
Для этого по этой схеме мы собираем цепочку, которая ведёт от task_attempt_id к user_id и его данным. Получается следующий путь (выделен на картинке синим цветом):
Смотрим test_attempt_id в task_attempt.csv и ищем такой же в test_attempt.csv.
Смотрим test_class_user_link_id в test_attempt.csv и ищем такой же в test_class_user_link.csv.
Смотрим class_user_link_id в test_class_user_link.csv и ищем такой же в class_user_link.csv.
Смотрим user_id в class_user_link.csv и ищем такой же в user.csv.
По user_id находим нужные нам first_name, middle_name, last_name (элементы Ф. И. О.).
Если переводить это движение в череду вопросов, на которые мы ищем ответы, то получилось бы:
А к какой попытке теста принадлежит решение конкретного задания?
А к какой выдаче теста ученику принадлежит текущая попытка?
А какому ученику и в каком классе выдали тест?
А как зовут ученика?
Видите — это своеобразная иерархия, по которой от точечной попытки решения конкретного задания мы поднялись до уровня конкретных студентов.
Таким образом, с помощью схемы выше вы можете быстро изучить, где что лежит, и подтянуть необходимые данные для решения задачи. Разбираться в структурах данных и принципах работы с ними — это повседневная задача разработчика, так что потренируетесь.
Считывание данных из файла CSV
Так как данные из CSV имеют конкретную структуру, то, по идее, должен существовать метод, который позволил бы при считывании данных это учитывать. Иначе вам придётся считывать их как обычный TXT-файл, разделять каждую строчку на элементы, вычленять их.
Note title
В целом если вам кажется, что что-то можно упростить, то, скорее всего, это уже изобрели. Как минимум для старта можно оттолкнуться от документации Python.
Чтобы не делать дополнительную работу, в Python существует специальный метод обработки CSV-файлов. Он позволяет считать содержимое файлов как список списков.
Сейчас расскажем, как это сделать. Для примера возьмём следующий CSV-файл students.csv:
1import csv
23withopen("students.csv", "r", encoding="utf-8") as f:
4 reader = csv.reader(f)
5next (reader) # Пропускаем заголовок6 data = list (reader)
78print(data)
Разберём строка за строкой, что здесь происходит.
1import csv
Это подключение стандартной библиотеки csv, которая позволяет работать с CSV-файлами. Вы как бы говорите: «Я хочу использовать инструменты для работы с CSV».
1withopen("students.csv", "r", encoding="utf-8") as f:
Эта строка открывает файл students.csv на чтение.
with open(...) — удобная конструкция: файл откроется, поработаешь с ним, и он автоматически закроется, даже если будет ошибка.
”students.csv” — имя файла, который читаем. В таком виде учитываем, что файл лежит вместе с исполняемой программой. Иначе к файлу нужно будет подкорректировать путь. Фактически при решении задачи будет видоизменяться только этот кусочек.
"r" — означает read (открыт на чтение).
encoding="utf-8" — говорит: «Файл в кодировке UTF-8» (универсальной и безопасной для русского текста).
1reader = csv.reader(file)
Здесь мы создаём читалку (reader). Она читает файл построчно, разделяя значения по запятой (или если указать — по разделителю 😉. Она будет возвращать по одной строке из CSV в виде списка.
1next (reader)
Пропускаем первую строчку с заголовками. В ней обычно не содержатся данные, которые нужны для решения задачи.
1data = list(reader)
Считываем все строки как список списков. В итоге переменная data содержит все строки CSV-файла, кроме заголовков.
И теперь мы можем обращаться к элементам следующим образом. Например, мы хотим узнать возраст Алисы. Тогда нам нужно обратиться к элементу data [1][1]. Так как к конкретному свойству мы обращаемся через определённый индекс ([0] — имя, [1] — возраст и тому подобное), то заголовки мы не используем.
Если вы хотите считывать данные как словари, то можете дополнительно изучить этот блок тут. Считывать данные в словари посложнее, но удобнее в использовании. Ниже краткая выжимка.
Код, реализующий считывание в виде словаря, выглядит следующим образом:
1import csv
23withopen("students.csv", "r", encoding="utf-8") as f:
4 reader = csv.DictReader(f)
5 data = list (reader)
67print(data)
Если посмотрите на данные дат или времени в файлах, то заметите, что они хранятся в следующем формате:
2025-05-23 15:45:02.123456
Это формат называется datetime, потому что он содержит одновременно и дату, и время. Давайте достанем из него отдельно год, месяц, день, час, минуту, секунду, микросекунду.
Таким образом, можем доставать конкретный кусочек даты или времени из datetime.
Так как при считывании данных из формата CSV получаем данные в виде строк, нужно каким-то образом научиться переводить строки типа «2025-05-23 15:45:02.123456» в datetime.
Для этого можно воспользоваться методом .strptime().