

Может показаться, что для получения рабочей системы нужно просто сделать каждый компонент хорошо. Затем запустить все компоненты вместе, отправить данные в полученный пайплайн, и на этом работа закончена. Активности по сборке модулей выглядят эфемерными, и обсуждение часто заканчивается словами «да что там делать».
В этом параграфе мы предлагаем развеять этот миф через работу над свойствами новой системы. В качестве примера рассмотрим реактивность и надёжность, затем проследим за дальнейшим развитием системы и сделаем выводы.
Робот — это не просто совокупность модулей
На практике подход «соедини имеющиеся компоненты очевидным образом» приводит к таким же последствиям, как в известной басне «Лебедь, рак и щука».
Каждый компонент живёт собственной жизнью. В лучшем случае никто не мешает друг другу, а о помощи и слаженной работе лучше и не говорить. При этом работающие по отдельности компоненты вполне могут перестать работать вместе: конфликтовать за системные ресурсы, несогласованно менять интерфейсы и договорённости.
На старте разработки крупных классических пайплайнов, основы традиционной робототехники, рассогласованная работа компонентов — типичная ситуация.
Задача правильной системной инженерии заключается в том, чтобы сформировать концепцию робота и подобрать компоненты для его реализации. Только так можно достичь значимых результатов, в отличие от простого соединения функциональных элементов, ведь 1 + 1 в правильной системе равно 3, а не 0,5.
Чтобы оценить пайплайн как систему, недостаточно спросить, работает ли каждый модуль по отдельности. Нужно смотреть на свойства, которые проявляются только при совместной работе компонентов:
- надёжность — процент случаев, в которых система справляется с задачей внутри своей области применения;
- реактивность — как быстро система реагирует на кратковременные изменения в среде;
- производительность — количество ценности, которое способна приносить система в единицу времени;
- предсказуемость — можем ли мы заранее описать, в каких условиях система будет работать безопасно и предсказуемо;
- робастность — насколько система сохраняет приемлемое поведение при шуме, ошибках сенсоров, неточных входных данных;
- обобщаемость — насколько система способна сама адаптироваться к новым объектам и ситуациям;
- информационная безопасность — устойчивость системы к внешнему воздействию со стороны злоумышленников;
- кросс-исполняемость — возможность работы системы на разных роботах, сенсорах, актуаторах и т. д.;
- портируемость — простота модификации системы под нового робота, сенсоры, актуаторы и т. д.;
- расширяемость — простота модификации системы при возникновении новых требований;
- поддерживаемость — сколько требуется усилий, чтобы система продолжала функционировать и приносить ценность;
- наблюдаемость — насколько понятно происходящее в системе по внешним сигналам;
- управляемость во внештатных ситуациях — способность менять поведение системы в случае возникновения проблем и ненормального поведения.
В этом параграфе мы не будем одинаково подробно разбирать все элементы этого списка. Сначала посмотрим на реактивность и надёжность как на самые наглядные системные свойства, а затем покажем, как при росте требований классический пайплайн сталкивается с композиционной сложностью.
Реактивность — основа успешности робота
Благодаря научной фантастике мы привыкли воспринимать роботов как механизмы, способные заменить человека в любых условиях: помыть полы, пообщаться с другими людьми, поиграть в теннис.
Реакция на окружающую среду — основа основ для всех живых существ. В целом мы сейчас близки к появлению подобных роботов. Но так было не всегда.
Первые манипуляторы, получившие распространение во второй половине ХХ века, были абсолютно нереактивными: они двигались по фиксированным траекториям с высокой повторяемостью движений.
Их продолжают использовать и сейчас, например при сборке автомобилей. Закрытый цех. Много автомобильных кузовов. Гигантские роборуки. И полное отсутствие людей. К этим роботам не пускают людей, так как они не способны на них реагировать. Несмотря на препятствия, они продолжают двигаться по заданным траекториям.
Если робот коллаборативный, то есть работающий в одной среде с людьми, то он просто не может следовать стратегии промышленного аналога «есть план, не вижу препятствий».
Для реакции на окружающую среду в пайплайне робота появляются детекторы объектов и цепочка модулей, учитывающих в принятии решения новый сигнал.
У этого сигнала есть важный показатель — время реакции, промежуток времени, за который робот начинает менять своё поведение после появления объекта в реальном мире. При этом новые модули не располагаются в пайплайне изолированно. Они могут использовать данные от оставшейся части системы. Например, детектор может опираться на информацию о карте или на локализацию.
Для того чтобы посчитать время реакции, нужно найти критический путь в графе выполнения модулей от данных сенсоров до формирования управляющего сигнала.
Критический путь
Это самый долгий путь в графе исполнения, который выполняет все блоки, необходимые для того, чтобы сформировать выход.
Вот типичный пример добавления учёта динамических объектов в пайплайн робота. Уже имеющиеся блоки показаны синим цветом, а добавляемые — жёлтым. Ожидание данных от новых модулей растягивает время обработки в старых модулях, приводя к более редким показаниям.
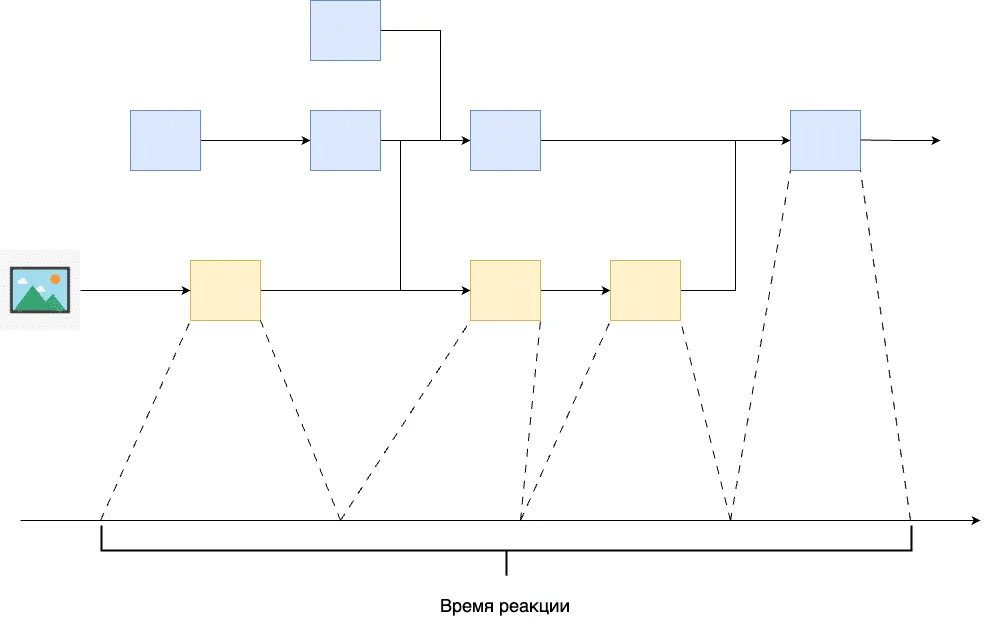
Время реакции влияет на то, в какой среде и с какими ограничениями может работать робот. Если время реакции равно бесконечности (сколько ни жди — реакции не произойдёт), как в случае манипуляторов в сборочном цеху, то нельзя находиться рядом с таким роботом, когда он во включённом состоянии.
Чем меньше время реакции, тем робот безопаснее, а значит, требует меньше специальных средств (касок, ботинок с железными носами и т. д.) при работе с ним.
Только реактивности для безопасности недостаточно
Наверное, вы уже догадались, что нужно быть осторожным даже с роботом, у которого время реакции близко к нулю. Робот должен увидеть и отправить сигнал на двигатели. Но есть и физическая инерция, не препятствующая моментальному изменению траектории.
При разработке роботов мы можем учесть опыт сосуществования с другими массовыми механизмами повышенной опасности — автомобилями. Для них люди построили специальные дороги, к которым закрыли доступ для пешеходов. Но даже опытные водители-профессионалы с быстрой реакцией не могут выйти из любой сложной ситуации.
Роботы часто ассоциируются с нарушением привычных ограничений, источником чудес с ноткой магии. В 2016 году во время тестирования автономных такси компании nuTonomy в Сингапуре их создатели жаловались, что люди пытались убедиться в сверхчеловеческих способностях автомобилей. Пассажиры дёргали за руль во время поездок, а прохожие тестировали алгоритмы на прочность, умышленно создавая помехи. Ведь робот лучше человека во всём, значит он сможет увернуться от любого препятствия. Автомобили не всегда успевали справиться с такими тестами из-за разрешающей способности сенсоров и слепых зон. А в тех случаях, когда видели, им не хватало времени реакции, чтобы принять решение о перестроении. Благо за рулём были водители-испытатели, которые успевали вывернуть руль в последний момент. Зрелище не для слабонервных!
- долгое время работы компонентов;
- обязательные точки синхронизации.
Рассмотрим их подробнее.
Долгое время работы компонентов
Если для какого-то из компонентов на критическом пути нужно много времени, то критический путь естественным образом удлиняется. Наша задача — сократить это время.
Для оптимизации времени работы компонентов могут использоваться подходы из различных областей, начиная от уменьшения вычислительной сложности внутренних алгоритмов, заканчивая низкоуровневым профилированием и оптимизацией под конкретное железо.
Из специфичных подходов к оптимизации, используемых в традиционной робототехнике, можно выделить:
- переход от долгих и сложных алгоритмов к более быстрым и упрощённым;
- использование локальных методов в противовес глобальным;
- AnyTime-подходы;
- аппроксимация сложных точных методов их более быстрыми аналогами.
Переход от долгих и сложных алгоритмов к более быстрым и упрощённым
Благодаря такому переходу алгоритмы начинают обрабатывать больше данных, компенсируя простоту. Этот метод часто встречается в алгоритмах локализации, например в фильтре Калмана, где для построения решения на коротких горизонтах используются только данные одометрии, а на более длинных — GPS и другие глобальные источники.
Использование локальных методов в противовес глобальным
Вместо того чтобы считать решение с нуля, используется начальное приближение, которое затем только доуточняется. При ограниченных изменениях этот метод значительно сокращает время обработки. Этот подход лёг в основу самого известного алгоритма для сопоставления облаков — ICP (англ. Iterated Closest Point). Также он нашёл своё место в подходах к управлению на базе CBF-CLF (англ. Control Barrier Functions, Control Lyapunov Function).
AnyTime-подходы
Основное преимущество этих методов строится вокруг неравномерности утилизации ресурсов в системе. В моменты низкой загрузки системы алгоритм получает более точное решение, а в другое время довольствуется более грубым. RRT (англ. Rapidly-exploring Random Tree) — это отличный пример алгоритма планирования, который относится к этой категории. Вместе с кешированием прошлых вычислений он способен разменять произвольное количество вычислений на более высокое качество.
Аппроксимация сложных точных методов их более быстрыми аналогами
Нейросети считаются одним из самых мощных инструментов аппроксимации, поэтому их часто используют вместо сложных математических оптимизаций. В результате мы получаем достаточное качество при значительном ускорении. Примером таких подходов является VGGT, заменяющий Байесовскую оптимизацию для построения карты. Другой пример — работа ExtremControl, где RL-контроллер заменяет решения задачи инверсной кинематики, основного метода для управления манипуляторами.
Перечисленные методы пытались ускорить решение исходной задачи при сохранении качества. Если система уже была хорошо оптимизирована, то это может стать непосильной задачей. Как ещё можно уменьшить задержки в системе?
Если выйти за пределы метрик компонентов и посмотреть на метрики всей системы, то оказывается, что можно немного разменять точность детекции на скорость. Например, добавление простого трекера динамики сокращает время реакции на машины и пешеходов. Успешность похожего подхода показали исследователи из ArgoAI на конференции CVPR-2021.
Ничего не делать с задержками компонента, но при этом победить проблему — это самый необычный способ борьбы с высокими задержками, который доступен только в робототехнике. Так как робот — это активная система, то можно подойти с другой стороны и попросить оставшиеся компоненты подстроиться так, чтобы снизить требования к задержкам компонента.
Например, если модуль планирования обычно работает долго, но на прямых участках автострад эта задержка нас устраивает, то при подъезде к критическим разворотам на магистрали, машина может замедлиться, снизив требования к времени реакции всей системы и, следовательно, увеличив временной лимит на работу долгого компонента.
Различие между задержками и частотой работы системы
Важно не путать задержку с частотой работы компонента. Частота показывает, сколько раз в секунду компонент выдаёт результат, а задержка — сколько времени проходит между поступлением данных на вход и появлением результата на выходе. Компонент может работать с высокой частотой, например 30 раз в секунду, но при этом иметь задержку в 100 миллисекунд, если внутри используется конвейер из нескольких стадий.
Представьте, что в ресторане повар выдаёт блюда каждую минуту. Это частота. Но от момента заказа до появления именно вашего блюда проходит полчаса — это задержка. Конвейер на кухне позволяет обслуживать много клиентов одновременно, повышая частоту, но каждый отдельный заказ всё равно готовится долго.
Так и в робототехнике: высокая частота работы модулей не гарантирует быструю реакцию на новое событие — для этого нужна низкая задержка на критическом пути.
Обязательные точки синхронизации
Ожидание из-за синхронизации потоков данных — это ещё одна причина, из-за которой компоненты могут долго формировать результаты.
Стороннему наблюдателю сложно понять, работает компонент или чего-то ждёт: поступил вход, а затем (через продолжительное время) сформировался выход. Но всё же важно различать эти ситуации, чтобы выбрать подходящее решение.
Синхронизация может происходить как в рамках одного сенсора, например лидара, так и между разными сенсорами или произвольными входами компонента.
В случае работы с лидарными облаками обычно дожидаются полного оборота вокруг своей оси, чтобы сформировать полный слепок окружающего пространства. При этом драйвер лидара чаще всего передаёт лидарные пакеты в потоковом режиме по мере вращения двигателя. Полную сборку осуществляют ради экономии вычислительных ресурсов или упрощения работы с этим сенсором. Например, в алгоритмах, работающих на потоковой обработке, нужно заморачиваться с обработкой граничных эффектов.
Синхронизация нескольких сенсоров тоже распространённое явление. Например, при разработке детекторов, использующих данные с двух сенсоров, камеры и лидара. Данные приходят в разное время и с разной частотой, поэтому приходится ждать свежих показаний от обоих сенсоров.
Для того чтобы избавиться от задержек при синхронизации данных от одного сенсора, достаточно научиться адаптировать алгоритмы к работе с произвольными порциями данных.
Например, модуль локализации, работающий на данных от лидара, можно перевести на потоковую обработку, отказавшись от формирования полного облака.
Более радикальный способ избавиться от ожидания — поменять сенсор на другой, с более коротким временем сборки. Если наш главный сенсор — лидар, то можно перейти на камеры, твёрдотельные узконаправленные лидары или лидары с необычными паттернами сканирования, позволяющие жертвовать плотностью облака ради сокращения задержек.
Если у нас несколько сенсоров, то с каждым можно поработать по отдельности вышеперечисленными методами. В дополнение к этому открываются новые варианты. Например, можно использовать предсказания вместо данных с сенсора. Ошибку предсказания можно скорректировать после поступления реальных данных.
Также можно устранить зависимость от части сенсоров — например, не использовать изображения с нескольких камер для расчёта глубины, а использовать нейросети для предсказания глубины с одной камеры.
Последовательная работа над задержками позволяет выжать максимум из ключевых компонентов. При этом сложно заранее предугадать, на чём стоит сконцентрировать своё внимание. На практике может оказаться, что ожидание данных от лидара длится дольше, чем работа самого детектора, использующего эти данные. Поэтому оптимизации должны всегда сопровождаться предварительными измерениями.
Задержки в принятии решений приводят к системным сбоям и отказам. Но не только задержки могут ухудшить продуктовые свойства нашего робота. Давайте взглянем на другие причины отказов.
Продолжаем улучшать надёжность
Самое важное потребительское свойство робота, как и любой системы, — способность справляться с поставленной задачей. Если система не может справиться с задачей, то происходит отказ, пользователь не получает планируемую ценность.
Здесь важно провести чёткую границу между ожидаемыми и неожидаемыми отказами. В случае ожидаемых отказов пользователь явно понимает, что робот не справится с его задачей. Например, не пойдёт открывать дверь, если такая функция не реализована.
Создать надёжного робота — значит очертить зону ODD (англ. Operational Design Domain — «область функционирования системы»), где робот предсказуемо работает, и минимизировать отказы в этой области.
Надёжность всей системы складывается из надёжности компонентов. Поэтому работает очевидная стратегия повышения надёжности: нужно растить надёжность компонентов ради роста надёжности системы. Но это не самый эффективный способ. Поэтому давайте обсудим альтернативы.
Когда мы оптимизировали задержки в системе, то фокусировались на поиске критического пути и сокращении задержек компонентов на этом пути.
Найти компоненты, сильнее всех влияющие на надёжность, можно похожим образом. Достаточно протестировать на типовых сценариях исходную систему или её модель. Затем собрать полученные отказы, приписать каждому из отказов проблемные компоненты, повлёкшие отказ, и сфокусироваться на улучшении этих компонентов.
Знание ODD даёт нам ещё одно средство для работы с надёжностью. Можно не устранять отказы полностью, а перевести неожидаемые отказы в категорию ожидаемых. Это полезно по нескольким причинам.
Во-первых, не стоит забывать, что мы оптимизируем работу не компонента, а целой системы. И в этом случае правильно задетектированный сбой в одном из модулей может быть компенсирован в другом месте.
Во-вторых, это пересекается с концептом функциональной безопасности, о котором мы расскажем в параграфе 6.2: предсказуемые сбои с подстеленной соломкой обходятся намного дешевле, чем непредсказуемые.
Какая бы ни была причина, подталкивающая к реализации этой логики, если попытаться сформулировать рекомендацию, то она будет звучать следующим образом: все редкие пути в компоненте, связанные с обработкой отказов, должны быть обработаны — возможно, не самым продуктовым способом.
Согласно этому концепту робот при поломке одной из камер не должен продолжать выполнять свои обязанности на 100%, но должен сообщить пользователю о своей поломке или ограничениях в работе. И уж точно ни при каких обстоятельствах он не должен действовать, как будто ничего не случилось, и вредить людям.
Если продолжить предыдущий подход, увеличивая полезность реакции при деградациях, то следующий шаг в развитии компонента должен вести к расширению зоны ответственности.
Для повышения надёжности системы компоненты должны уметь компенсировать неправильную работу других модулей. Этого можно добиться как на уровне предобработки входных сигналов, так и создавая специализированные подсистемы для аварийных режимов работы. Помните пример с замедлением перед важными развилками на дороге?
Главное — соблюдать баланс между дублированием функциональности и дополнительной надёжностью, которую мы получаем от этого усложнения. Иначе мы получим систему, которую сложно поддерживать из-за однотипной функциональности, размазанной по всем модулям.
Если продвинуться ещё чуть дальше в сторону развития надёжности, то мы придём к похожим концептам из параграфа 7.2 о функциональной безопасности, где подсистемы, выполняющие одну и ту же функцию, дублируются. При реализации такого подхода функциональность перестаёт работать только тогда, когда отказывают все дублирующие модули. Это отличный способ радикального повышения надёжности. Данную концепцию принято называть отсутствием единой точки отказа.
После улучшения надёжности робот становится всё меньше и меньше похож на кучку разрозненных модулей. Мы разобрались с базовыми принципами разработки пайплайна с опорой на системные свойства и готовы проследить за его дальнейшим развитием.
Закономерности развития пайплайна
Надеемся, вы уже осознали, что разработка робота всё же строится на разработке компонентов. Все знания из параграфа 3.1 остаются актуальными. Разница между подходом «просто соедини все компоненты вместе» (см. начало параграфа) и новым подходом заключается лишь в направлении развития и ограничениях.
После добавления в пайплайн новый компонент обычно проходит следующие этапы:
- создание MVP;
- универсализация;
- превращение в нишевого эксперта.
Создание MVP
На этой стадии становится очевидно, что нужен новый компонент, понятна его роль в пайплайне и основная функция. Часто компонент сфокусирован только на этой функции и не делает ничего больше. Покрыты только успешные сценарии, а неуспешные просто вываливают ошибки и проблемы дальше в пайплайн. Во многих случаях поведение топорное и неестественное, в том числе из-за того, что функции реализованы не до конца, самым простым способом.
Универсализация
Далее в компоненте решаются проблемы с отказами: он начинает адекватно обрабатывать большинство типичных ошибок соседей по пайплайну, уменьшается количество допущений относительно входных данных, их порядка, качества и т. д. В этот момент компонент дозревает до хорошего состояния и легко может быть портирован в большинство других похожих пайплайнов. Это самое удачное время в жизни компонента для открытия исходного кода и начало параллельной жизни в нескольких проектах.
Превращение в нишевого эксперта
Если требования к целевой системе не очень высокие, то до этого этапа компоненты даже не добираются. Если желаемые требования не достигнуты, то мы переходим к оптимизации под конкретную систему, соседние компоненты и специализированное железо. И чем выше планка качества и меньше доступных ресурсов, тем сильнее начинает проявляться взаимосвязь компонентов. Постепенно компонент превращается из универсального элемента любого робота в хорошо обточенный кубик, который без проблем может встать только в одну конкретную систему, чтобы выжать из неё максимум. Он требует много вспомогательных компонентов, часть из которых создана специально под этот кубик. Он может работать только с определёнными, оптимизированными форматами данных. Чаще всего в этот момент модуль теряет концептуальную простоту, присущую второму этапу.
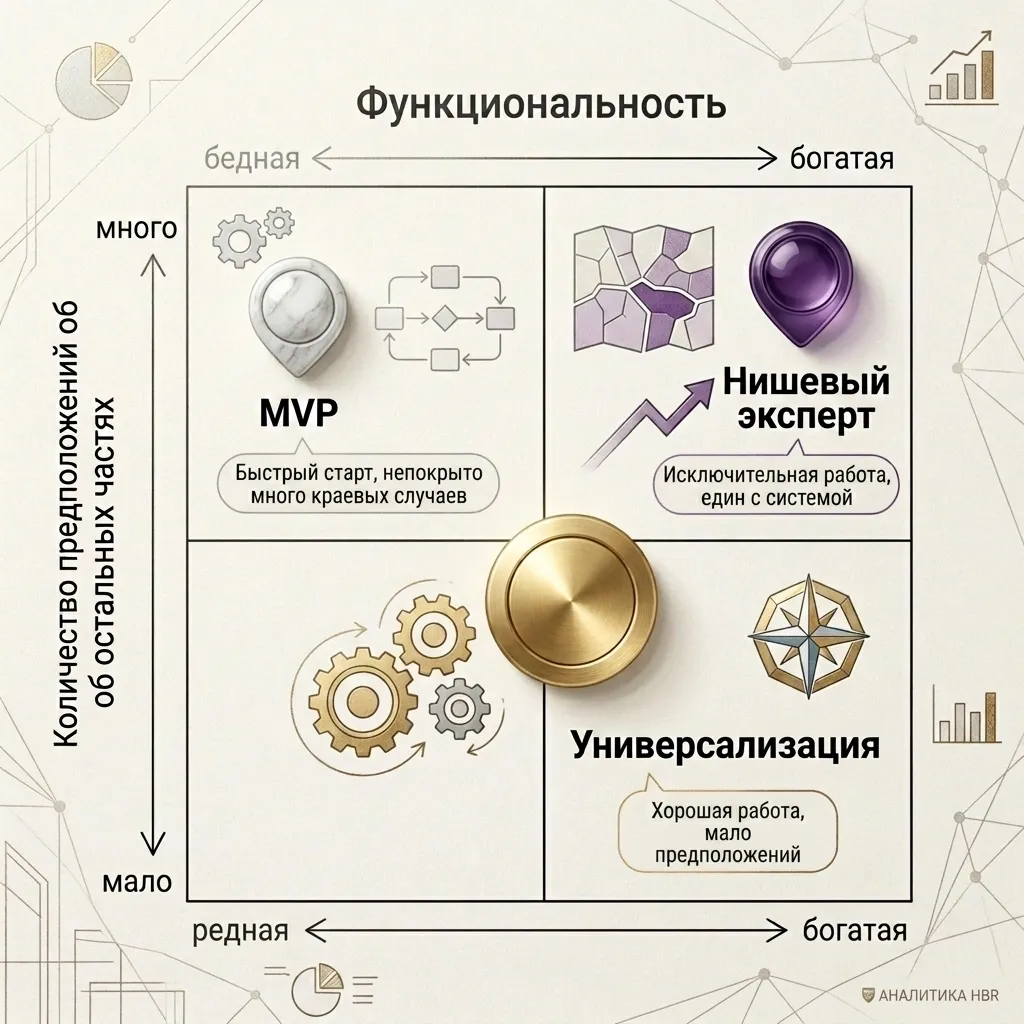
Если в системе появилось несколько модулей-экспертов, но целевые требования ещё не достигнуты, то в попытке избавиться от избыточной сложности создаются вспомогательные модули, решающие определённые подзадачи.
Например, легко представить в такой системе модуль, который создан для решения проблем с пешеходами, двигающимися непредсказуемым образом, либо моделирующий толпы людей.
Сразу после появления такого модуля ощущается облегчение: не нужно придумывать, как увязать две совершенно разные логики в одном месте, не нужно завязывать циклы обучения моделей — можно собрать отдельные датасеты и учить модели независимо.
Но если такая ситуация повторяется вновь и вновь, то, избежав повышенной внутренней сложности компонентов, разработчик начинает платить налог на композиционную сложность пайплайна. Компонентов становится настолько много, что сложно удержать их в голове, а также правильно распределить требования при расползающихся зонах ответственности. Скорость разработки падает.
В концепции классического пайплайна при разработке зашкаливающе сложной системы не существует серебряной пули — решения, позволяющего добиться нужного качества при сохранении приемлемой сложности. Именно поэтому в 2010-х при разработке сложных систем стал активно развиваться новый подход на основе больших нейронных сетей и e2e-обучения. Более подробно рассмотрим его в параграфе 3.3.
Но сначала давайте соберём опыт, полученный при проектировании классического пайплайна по-новому.
Осмысленный переход на системный уровень
Смещение фокуса на свойства системы позволило нам иначе взглянуть на дизайн компонентов и заставило задуматься об их совместной организации.
Оказывается, что после закрытия базовой функциональности жизнь компонентов в системе только начинается, а сборка компонентов — это отдельная большая активность со своей собственной логикой. Давайте сделаем более конкретные выводы о разработке компонентов, являющихся частью системы, и о развитии робота на системном уровне.
Основные выводы о разработке компонентов
- Многие дилеммы, которые мешают роботу доставлять максимальную ценность, просто не видны при разработке компонентов в нецелевом окружении.
- Не стоит заниматься преждевременной оптимизацией — это чаще всего время, выброшенное на ветер.
- Будьте готовы к появлению компонентов, которых не было в изначальном плане.
- При разработке компонента нужно обеспечить базовую обработку неуспешных сценариев.
- Типичный путь развития компонента: уникальная некомпетентность → мастер-середнячок, но на все руки → уникальный эксперт.
Основные выводы о системном развитии
- Ценность для пользователя появляется благодаря работе всей системы, а не отдельных компонентов.
- Улучшать показатели компонентов без привязки к целевой системе почти всегда бесперспективно.
- Размены параметров компонентов возможны только на уровне целевой системы.
- Путь работы с проблемными ситуациями и отказами системы: неожидаемые → ожидаемые → улучшение реакции → бесшовное решение.
- Чем выше требования к системе и меньше доступных ресурсов для решения, тем более связанной получается система.
- Сложность разработки через пайплайн можно размазать по разным частям только до определённого уровня, дальше разработка стагнирует.
В этом параграфе мы не представили новую точку зрения (относительно параграфа 3.1), как это могло показаться. Мы расширили взгляд на системы, сделали его более полным и дали перспективу.
Теперь вы знаете, что детектор препятствий нужен не только для того, чтобы найти камень на дороге. Он нужен и для того, чтобы вернуть результат не дольше, чем за 50 мс, — тогда модуль управления сможет среагировать. А ещё этот модуль должен предсказывать положение препятствия в течение трёх тактов пайплайна, чтобы обрабатывать ситуацию, когда объект пропадает из поле зрения робота.
Мы дошли до деталей разработки сложных систем на основе классического пайплайна и столкнулись с ключевой проблемой: сложность зашкаливает, проблемы не решены, как двигаться дальше — непонятно.
Именно в этот момент появляется Physical AI. Чем он может нам помочь — узнаем в следующем параграфе.