

Мы только что рассмотрели классический робототехнический пайплайн: из каких компонентов он состоит, как компоненты соединяются друг с другом, а также взглянули на его ключевые свойства.
На первый взгляд кажется, что из классического пайплайна робота сделать пайплайн Physical AI довольно просто: достаточно по очереди заменить модули из параграфа 3.1 (восприятие, планирование, управление) на нейросеть. Но это заблуждение.
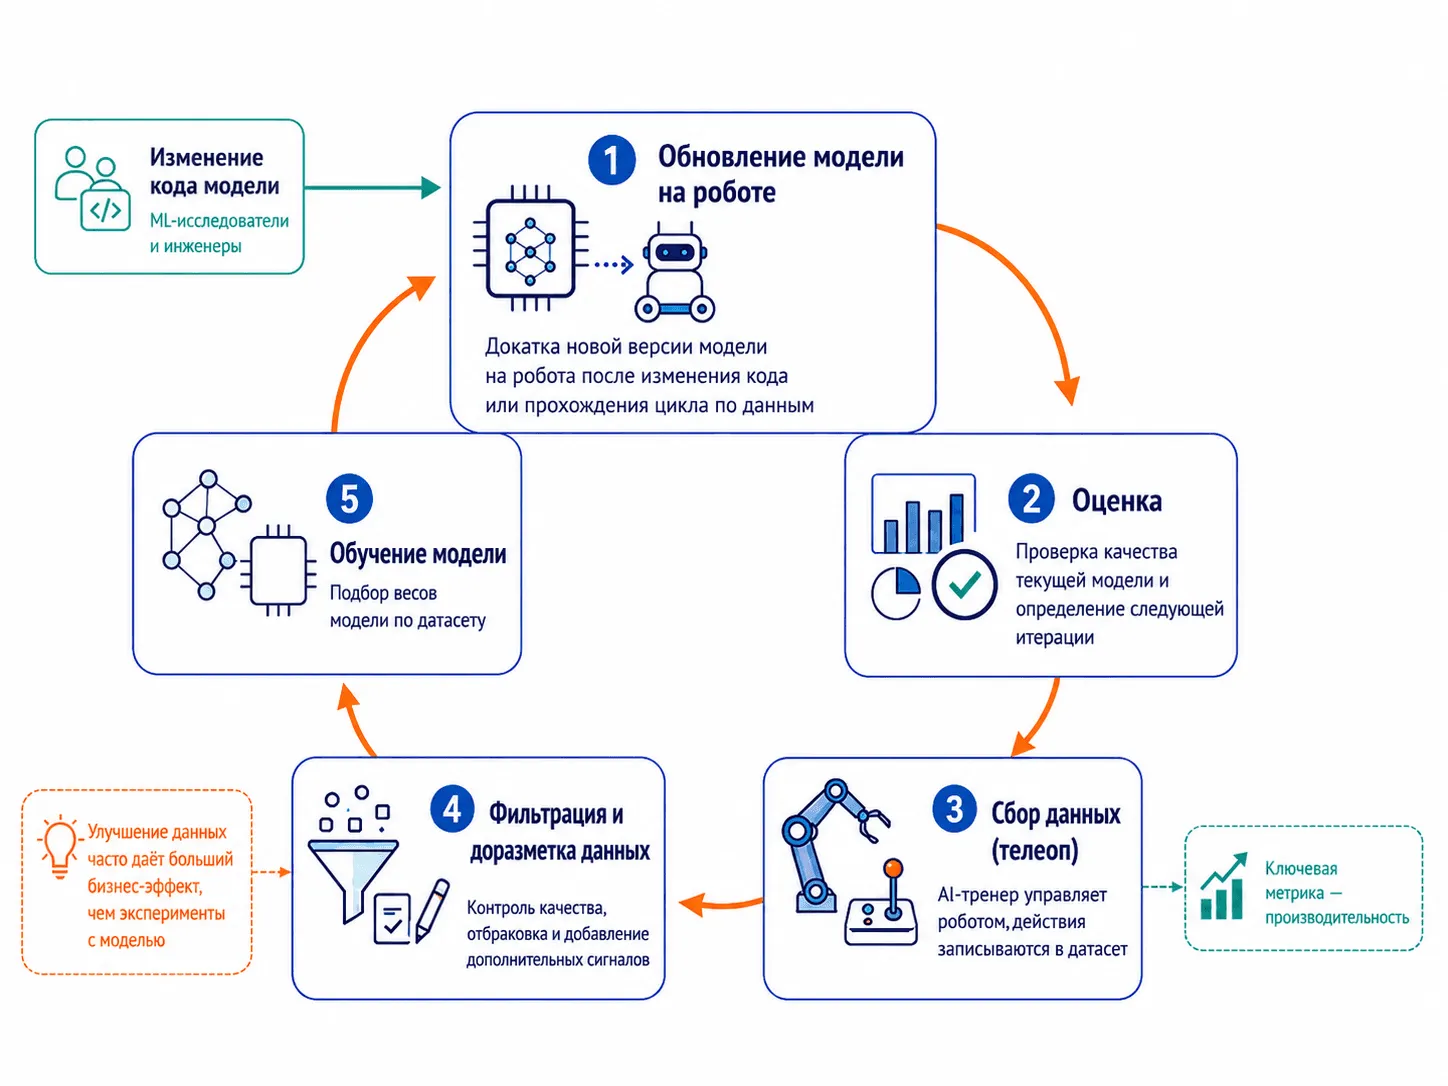
Далее в этом параграфе вы сами увидите, что Physical AI в первую очередь — это переход к новому цикличному режиму работы над данными и моделью. Причём большая часть активностей проходит за пределами робота.
Наш разговор будет устроен так:
- вначале расскажем про устройство пайплайна Physical AI — на роботе и в облаке;
- затем обсудим, какие нужны профессии для работы этого пайплайна;
- наконец, подведём итог открывшимся перспективам.
Приступим!
Пайплайн Physical AI на роботе
Благодаря параграфам 3.1 и 3.2 мы уже поняли, что классический пайплайн робототехники состоит из крупных функциональных блоков.
Есть блоки для решения задачи планирования, восприятия и т. д. В Physical AI система строится на других принципах. В основе построения лежит ключевая идея AI-революции — e2e-подход.
На место развесистой кипе компонентов приходит монолитная модель, решающая всё и сразу. Здесь нет очерченных модулей восприятия и обработки данных, и ML-инженеры могут только догадываться, за что отвечает каждый слой.
Для запуска такой модели на роботе необходим обвязочный код, читающий данные с сенсоров, преобразующий выходы сети в напряжения на двигателях, а также инфраструктурный код для работы модели, например, KV-кеши трансформеров.
В классическом пайплайне тоже есть модули, отвечающие за поток данных от сенсоров и актуаторов. Разница лишь в том, что обработка входов и выходов занимала меньше 5% всей кодовой базы классического пайплайна. В пайплайне Physical AI этот код составляет большую часть системы.
Что такое KV-кеш
KV-кеш (Key-Value кеш) — это механизм оптимизации инференса трансформеров.
В режиме авторегрессивной генерации каждый новый токен должен посмотреть на все предыдущие токены через слой внимания. Внутри слой внимания вычисляет ключи и значения для каждого токена.
Без кеша модели пришлось бы повторять эти расточительные вычисления каждый раз для всей последовательности. KV-кеш сохраняет уже вычисленные ключи (Keys) и значения (Values) предыдущих шагов, позволяя на каждом новом шаге считать только то, что действительно ново.
Цена за это — память: чем длиннее последовательность, тем больше кеш разрастается, и на роботе с ограниченными вычислительными ресурсами это становится отдельной головной болью для инженеров.
В сердце системы находится VLA-модель. Рассмотрим её подробнее.
VLA-модель
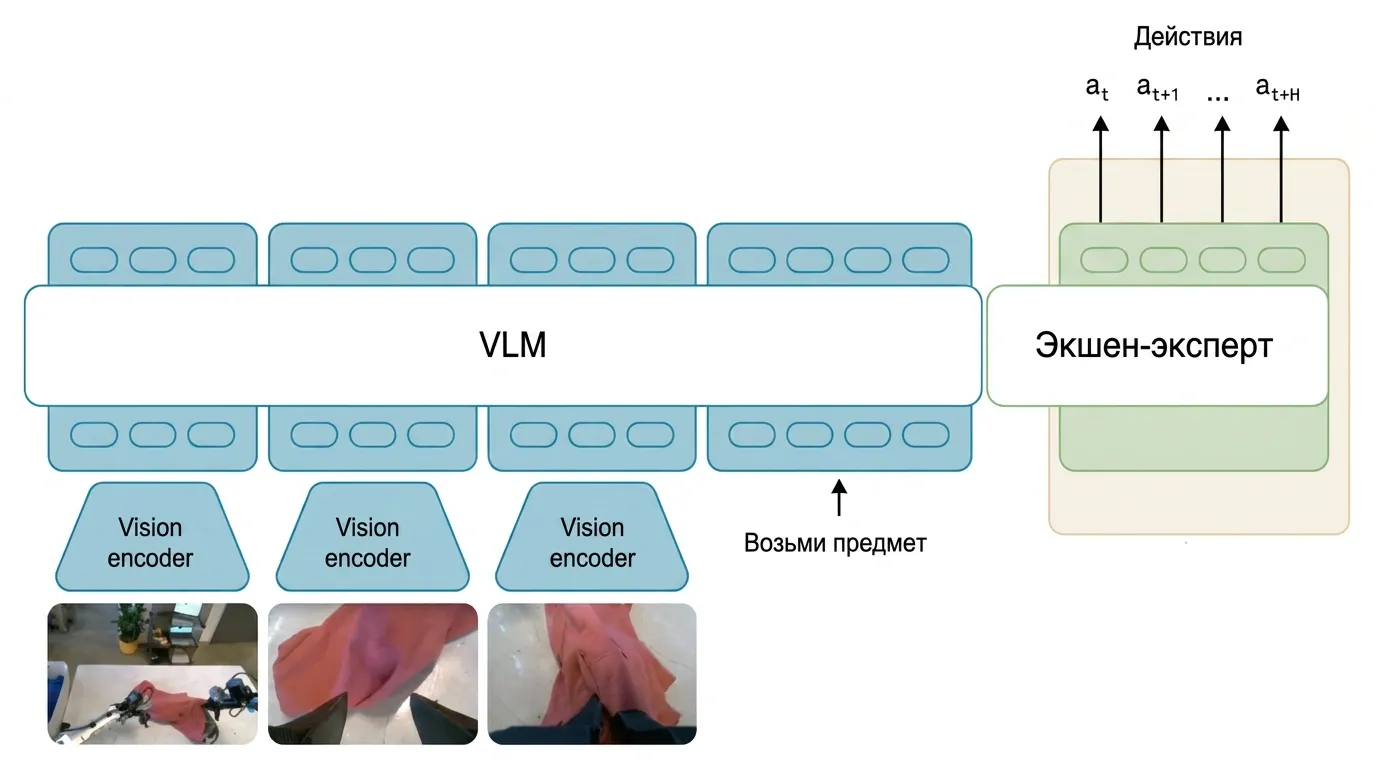
VLA-модель (англ. Visual Language Action) — это большой трансформер, который на вход принимает изображения с камер, текстовое описание задачи (промпт), а на выход возвращает последовательность управляющих воздействий.
Типичная VLA-модель состоит из двух важных компонентов: VLM и экшен-эксперта. Рассмотрим их подробнее.
VLM
VLM (англ. Visual Language Model) — это большая языковая модель, которая, в отличие от LLM, способна принимать на вход не только текст, но изображения.
Задача VLM — понять этот мир через поток изображений и превратить его в набор многомерных векторов. Причём для фокусировки на конкретной задаче VLM используется текстовый промпт, ведь хватать кружку и наливать в неё воду нужно по разным правилам.
Обычно за основу берётся уже готовая VLM-модель и доучивается под конкретные навыки. В отличие от современных VLM, в которых количество параметров составляет сотни миллиардов, а то и триллионы параметров, типичный размер VLM для робототехники — сотни миллионов или несколько миллиардов параметров.
Большие модели портят движения, делая их дёргаными и отрывистыми. Всему виной — задержки, возникающие из-за исполнения больших моделей.
От задержек больше всего страдают сложные навыки, для которых важна не только точность перемещений, но и следование динамике движений. Например, складывание футболок или завязывание шнурков.
Экшен-эксперт
Экшен-эксперт — это дополнительная надстройка над VLM, задача которой — выдавать действия в модуль управления.
В отличие от VLM, эта часть учится с нуля, так как не существует доступных готовых вариантов для такой задачи. Задача экшен-эксперта — выдавать действия роботу с высокой периодичностью, как минимум 10 Гц.
Чтобы этого добиться, часто делят систему на два контура.
Медленный контур строит долгосрочные качественные решения, в то время как быстрый обеспечивает реакцию в реальном времени, опираясь на результаты первого. Можно рассматривать это разбиение как типичный инженерный приём, в ходе которого неподъёмный объём вычислений разбивается на две кучки.
Есть и другой способ добиться высокой частоты выполнения команд.
Для этого нужно заменить авторегрессионные предсказания действий в трансформере на какую-нибудь разновидность диффузии. Чтобы прочувствовать суть идеи, нужно всего лишь заметить, что действия робота — это не просто подёргивания двигателей, а скорее взмахи кисти художника.
Предсказание взмахов, а не подёргиваний, решает сразу две проблемы:
- Иногда взмахи предсказываются сильно проще, так как в них есть начало и конец.
- Предсказание непрерывного взмаха на следующую секунду высвобождает много времени, чтобы перейти к расчёту следующего.
Если собрать обе части VLA-модели вместе, то получается следующая картина:
RL-контроллер
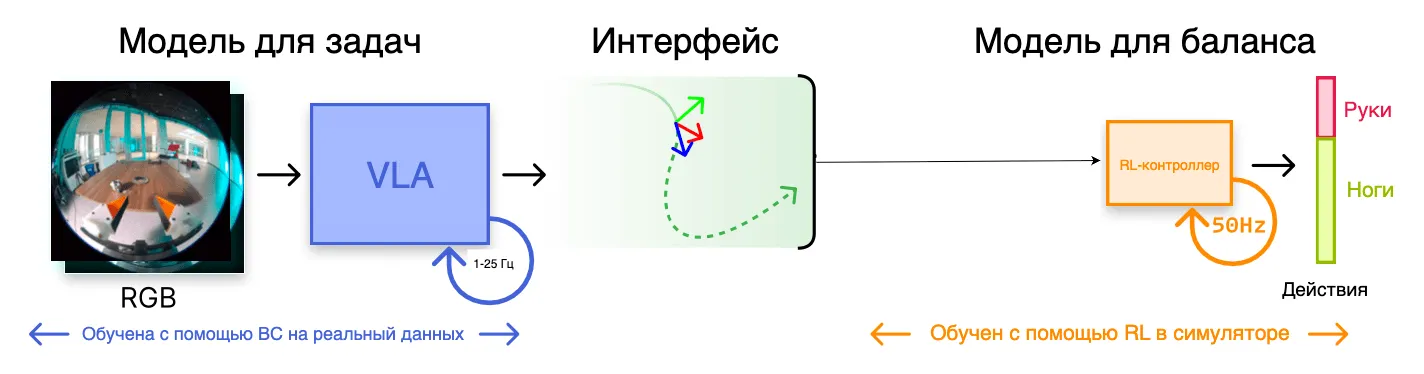
При работе с более динамичными роботами, например, гуманоидами, возникает новый класс проблем. Для того чтобы удержать роборуку в одном положении, достаточно подавать ток на двигатели каждого сустава, фиксирующие конструкцию в заданном положении.
Если же мы будем держать двигатели робота-гуманоида в одном положении, то с большой вероятностью робот упадёт. Стоячее положение для гуманоида очень неустойчиво. Баланс в таком положении динамический: иногда сделать несколько перетаптываний либо пару лёгких колебаний в коленях просто необходимо.
Динамичное управление требует высокой скорости реакции, которую сложно получить существующими подходами к разработке VLA-моделей. Представьте, что робот запнулся, а модель среагировала через 0.5–2 секунды. Хочется исправить ситуацию, но робот уже валяется на полу.
Обучение VLA-моделей строится на запоминании действий AI-тренеров, которые они демонстрируют с помощью телеоперации (сокр. телеоп). Верхняя планка того, что может достигнуть модель, — навыки самого лучшего AI-тренера. В случае с обучением хождению повторять просто не за кем: телеопа для задачи хождения просто не существует.
Все эти проблемы решаются отдельным контроллером робота, который учится в симуляции методом обучения с подкреплением (англ. reinforcement learning, RL). Минимальная частота, с которой должен выдавать положение двигателей RL-контроллер, — 50 Гц.
Поэтому для контроллера используются нейронные сети с числом параметров не более 100 миллионов. Это примерно на порядок меньше, чем в VLA. Контроллер учится действиям на собственном опыте в симуляции, а не основе датасетов, как в имитационном обучении (англ. imitation learning). После сотен падений робот начинает понимать правильные действия.
Что такое «обучение с подкреплением»
Обучение с подкреплением (англ. reinforcement learning, RL) — это разновидность обучения, когда модель учится не просто повторять последовательность, как в imitation learning, а старается заработать максимальную награду.
Конструирование развивающей награды для любого состояния среды — отдельная сложная задача.
Мы посмотрели на все основные компоненты пайплайна Physical AI на роботе. И этих компонентов достаточно, чтобы заменить классический пайплайн.
Но если для работы классического пайплайна разработчику достаточно написать код и запустить его на роботе, то в пайплайне Physical AI написание кода — лишь малая доля усилий, которые необходимы для оживления робота. Помимо кода, важно разобраться с данными и инфраструктурой для обучения моделей.
Пайплайн Physical AI в облаке
Для того чтобы появилась модель на роботе, необходимо собрать данные и пройти через этап обучения. В ходе обучения с помощью алгоритма градиентного спуска подбираются веса модели таким образом, чтобы она могла самостоятельно повторить действия AI-тренера из датасета.
Таким образом, триггером для обновления модели служит либо обновление кода модели разработчиком (поменяли слой, изменили функцию потерь), либо появление новых данных. В зрелой разработке полезно разделять эти два триггера: за один чаще всего отвечают ML-исследователи и инженеры, за второй — аналитики данных.
При этом не стоит ожидать, что все данные, собранные AI-тренерами, попадают прямиком в общий котёл. Эти данные должны пройти процедуру контроля качества, которая отбраковывает часть данных.
Далее данные обычно доразмечаются дополнительными сигналами: промптами, разметкой изображений либо логом рассуждений. Опыт индустрии показывает, что улучшение данных даёт больший бизнес-эффект, чем эксперименты с моделью.
Также отдельно стоит упомянуть получение данных с робота. Сбор датасета обычно выполняется с помощью специализированных инструментов для телеоперации, предоставляющих пользователю интерфейс управления разными частями робота.
Через интерфейс телеопа пользователь решает целевую задачу: например, хватает и поднимает кубик со стола. Действия пользователя логируются в виде управляющих команд, которые затем учится повторять VLA-модель. Самая важная метрика телеопа — производительность.
Чем выше производительность, тем быстрее собирается единица данных, эпизод. Производительность (количество эпизодов в единицу времени) разных телеопов может отличаться на порядок.
Точные референсные значения здесь не приводим сознательно: их трактовка затруднительна, поскольку показатель сильно зависит от требуемого уровня качества и разнообразия внешних факторов (освещение, расположение объектов, наличие отвлекающих элементов и т. д.).
Новые профессии в Physical AI
Работа с данными — отдельная большая область. Она не похожа на обычную разработку и требует особых навыков.
Именно поэтому в машинном обучении появляются новые профессии в дополнение к ML-исследователям и разработчикам:
- MLOps-разработчики;
- аналитики данных;
- AI-тренеры.
Расскажем о них подробнее.
MLOps-разработчики
Когда растёт объём данных, которые должны пройти в обучении через модель, с ним неизбежно растёт количество задействованных вычислительных ресурсов.
Вначале веса модели при обучении перестают помещаться в память одной видеокарты. Затем приходится задействовать дополнительные серверы. При этом серверы могут быть территориально разнесены в разных частях дата-центра.
Чтобы сохранить оптимальную скорость обучения (количество пройденных эпизодов за единицу времени), приходится придумывать хитрые схемы распараллеливания вычислений в обучении на разных серверах, реализовывать эффективные механизмы внимания, писать специализированный код для процессоров видеокарт и делать много других инженерных вещей.
Для этого требуется особая специализация, которой обладают MLOps-разработчики. Чаще всего эти специалисты также отвечают за все инфраструктурные ML-инструменты, подготовку и доставку моделей на реального робота.
Аналитики данных
Они отвечают за все операции с данными: от получения сырых датасетов до интеграции в финальную модель. Они формируют конкретный запрос на сбор данных для улучшения модели, обеспечивают доразметку и обогащение данных, производят дообучение и оценку результатов.
В разработке это непрерывный цикл, в котором после оценки обученной модели уточняется задание на сбор, и всё повторяется заново.
AI-тренеры
При разработке ML-моделей для классификации изображений либо генерации текста AI-тренеры вовлечены только в разметку готовых данных.
В Physical AI они собственноручно собирают данные с реальных роботов с помощью телеопа. Это физически сложная, но очень нужная профессия.
А производительность сбора, оказывается, зависит не только от качества телеопа, но и от навыков человека, который собирает данные.
Свойства нового пайплайна
Вы уже догадались, что пайплайн Physical AI — это не эволюционное развитие классического пайплайна робота. Это совершенно новая парадигма, отличительными свойствами которой являются:
- Инференс-часть на роботе — это «500 строк кода».
- Основное качество робота создаётся в офлайн-части.
- Создаётся ощущение, что поведение робота — это чёрный ящик.
- В первом приближении гарантии на действия эфемерны.
Взглянем на каждое из свойств подробней.
1. Инференс-часть на роботе — это «500 строк кода»
Physical AI наследует самые сильные способности от больших языковых моделей.
Потенциал приложения, работающего с языковой моделью, определяется на 99% возможностями самой модели. За пределами весов модели практически не содержится логики, кода, который принимает решения.
Оказывается, что «инженерия» поверх достаточно мощной end-to-end-модели только портит качество. Мы изучили этот феномен в параграфе 2.3.
Код, управляющий роботом в пайплайне Physical AI, включает лишь стандартные драйверы для общения с сенсорами и актуаторами, цикл, берущий очередную порцию данных от сенсоров, отправляющий их в VLA-модель, и направляющий результат работы непосредственно в модуль управления.
2. Основное качество робота создаётся в офлайн-части
На этом свойстве мы уже подробно остановились в разделе этого параграфа про инфраструктуру.
В офлайне есть цикл работы с данными, в котором обучаются модели и происходит много других интересных вещей. В классическом пайплайне основная работа идёт над кодом, который в скомпилированном виде попадает на робота.
Много аспектов работы пайплайна Physical AI зависят от работы над данными. При этом в процессе обучения данные безвозвратно растворяются в весах модели. Про их существование можно только догадываться, наблюдая за действиями робота.
3. Создаётся ощущение, что поведение робота — это чёрный ящик
В Physical AI-пайплайне нет блока, отвечающего за восприятие объектов. Нельзя понять, увидел ли робот человека перед тем, как наступить ему на ногу, или нет. А если робот увидел человека, то почему не стал на него реагировать?
То же самое касается и остальных модулей. И создаётся ощущение, что разработчики ничем не управляют. Но так лишь кажется. Современные модели и методы обучения заставляют сеть впитывать в себя всё полезное из датасета как губка. А датасет полностью наблюдаем, и его влияние на действия робота вычислимо.
Например, понять, наступит ли робот человеку на ногу, можно заранее — создав бенчмарк по взаимодействию с людьми с высокой степенью разнообразия. А затем дособрать необходимые навыки в проблемных ситуациях.
Системная работа с датасетом — основной залог предсказуемого поведения.
4. В первом приближении гарантии на действия эфемерны
Помимо системной работы с датасетом, существуют техники избавления от негативного поведения на базе RL, DPO и DAgger. Они, как точный скальпель хирурга, позволяют починить плохо работающую модель даже в сложных случаях.
В дополнение к этому выход робота можно проверить быстрыми классическими методами на безопасность, и в случае проблем запустить реакцию контура безопасности.
Что в итоге
Physical AI — это большая область, поэтому про все нюансы не расскажешь в одном параграфе. Эта задача выглядит непосильной.
Чтобы как-то систематизировать изучение, мы подготовили карту Physical AI, которая будет направлять вас на этом пути. По крайней мере, её задача — дать почувствовать глубину области Physical AI (показать всё разнообразие имеющихся блоков) и систематизировать обучение.
В следующей главе как раз приступим к изучению этой карты.