

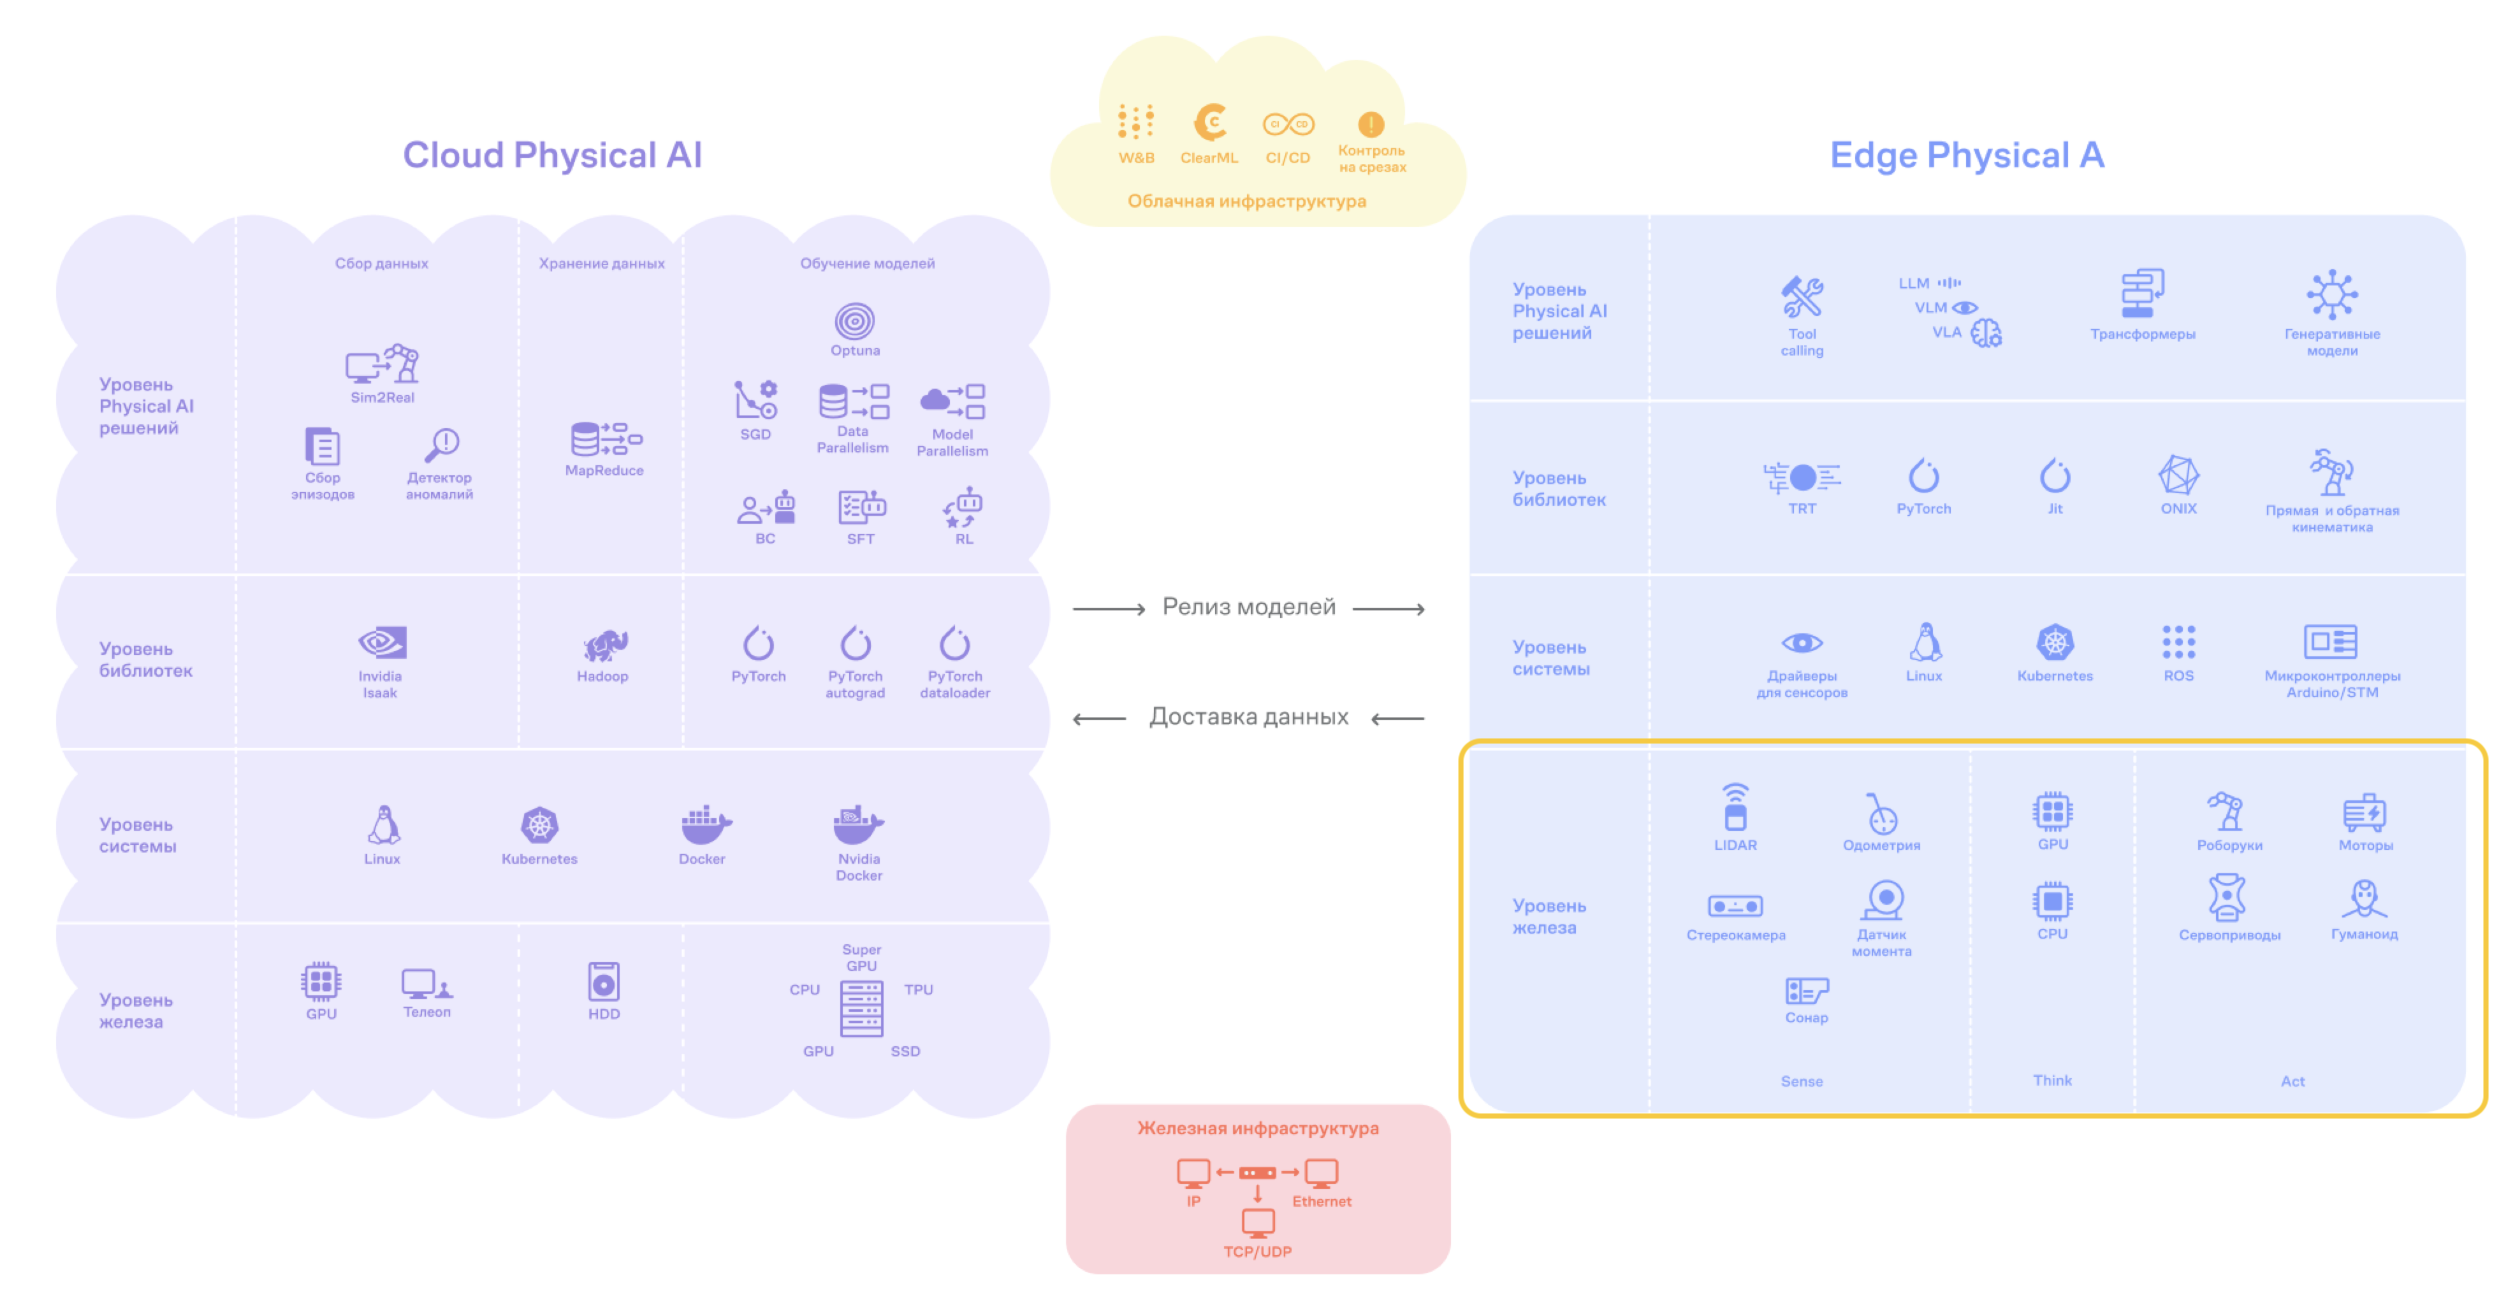
Edge Physical AI — это бортовая половина системы Physical AI. Она отвечает не за обучение модели, а за её работу прямо на роботе.
Внутри Edge Physical AI всё устроено по уровням, так же как и в Cloud-части.
- В основании лежит уровень железа. Это сенсоры и актуаторы, например лидар и моторы, а также бортовой вычислитель, например GPU.
- Над ним — уровень системы. Он связывает железо и программы через операционную систему и протоколы коммуникации, например Linux и ROS.
- Ещё выше — уровень библиотек с инструментами для запуска моделей, например TensorRT и ONNX.
- На вершине — уровень решений Physical AI. Это сами модели, которые думают и принимают решения, например VLA и VLM.
Дальше мы разберём каждый уровень по отдельности, начиная с уровня железа.
Уровень железа
Лидар
Лидар (англ. LIDAR, Light Detection and Ranging) — сенсор, который измеряет расстояние до объектов с помощью лазерных импульсов.
Датчик испускает короткий лазерный луч, тот отражается от поверхности, и по времени полёта вычисляется расстояние. Если лазер при этом вращается, получается полная 360-градусная карта окружения. Современные лидары достигают миллиметровой точности, что делает их основным сенсором для локализации, построения 3D-реконструкции и определения препятствий.
Первый вращающийся 3D-лидар реального времени создала Velodyne, которая до этого выпускала сабвуферы. Прототип появился после DARPA Grand Challenge 2005, а серийный HDL-64E в 2007 году стоял на пяти из шести машин, финишировавших в DARPA Urban Challenge. Сегодня лидары стали компактнее и доступнее: Sony анонсировала лидар AS-DT1 весом всего 50 граммов, а Unitree выпустила 4D-лидар L1 специально для своих робособак.
Интересный факт
Импульс лидара не всегда возвращается одним эхом. Когда луч попадает в тонкий или полупрозрачный объект, часть энергии отражается сразу, а часть идёт дальше.
Современные лидары научились сразу записывать несколько ответов. Первый (first) — от ближней поверхности. Последний (last) — от самого дальнего препятствия. Фиксируются и все промежуточные (all). Благодаря этим сигналам лидар может видеть стеклянную дверь.
Для лидара с одним ответом стеклянная дверь почти невидима, ведь большая часть света проходит насквозь. Но если first приходит от поверхности стекла, а last — от предмета за ним, значит на пути есть прозрачная преграда. Если самый сильный и последний ответы различаются, в этом направлении почти наверняка есть стекло.
Практика. Попробовать работу с лидаром можно в симуляторе NVIDIA Isaac Sim, где доступны различные модели устройств. Для экспериментов на реальном железе подойдёт 3D-лидар Livox Mid-360 с обзором 360° × 59° и дальностью до 70 м.
Познакомиться с лидарными данными можно на датасетах KITTI и nuScenes. Алгоритмы построения карт реализованы в опенсорс-проектах, таких как Cartographer, RTAB-Map и GTSAM. Эти алгоритмы можно запустить на датасетах KITTI для того, чтобы лучше понять, как они работают. Для отображения лидарных данных подходят инструменты визуализации в робототехнике, например Foxglove или RViz.
Изучить подробнее:
- Ouster (после объединения с Velodyne) — крупнейший производитель лидаров: документация и SDK
- RoboSense — различные лидары для робототехники
- Livox — доступные 3D-лидары для мобильных роботов
- Foxglove — инструмент для визуализации
Стереокамера
Стереокамера — это устройство из двух камер, разнесённых на фиксированное расстояние.
Каждая камера снимает одну сцену с разных углов. Процессор сравнивает два кадра и находит смещение одних и тех же точек — диспарантность (англ. disparity). Чем ближе объект, тем больше смещение. По диспарантности камера вычисляет расстояние до каждого пикселя и строит карту глубины в реальном времени. Принцип тот же, что у бинокулярного зрения человека.
В робототехнике стереокамеры используют для навигации, обхода препятствий и распознавания объектов. Самая популярная серия — Intel RealSense D400. Модель D435 имеет разрешение глубины 1280 × 720, поле зрения 85,2° × 58° и дальность до 10 м. Дополнительный ИК-проектор подсвечивает сцену точечным паттерном, что помогает вычислять глубину даже на однотонных поверхностях.
Интересный факт
В 2025 году Intel выделила RealSense в самостоятельную компанию — после угрозы её закрытия в 2021 году продукт выжил благодаря спросу на мировом рынке робототехники.
Практика. Попробовать стереозрение можно в симуляторе NVIDIA Isaac Sim с готовыми моделями стереокамер, а на реальном железе — на Intel RealSense D435 или более дешёвой Luxonis OAK-D.
Познакомиться со стереоданными удобно на датасете KITTI с отдельным стереобенчмарком и точной разметкой глубины от лидара. Базовые алгоритмы поиска диспарантности есть в OpenCV, например StereoBM и StereoSGBM, а более плотную карту глубины дают нейросетевые методы, например RAFT-Stereo или VGGT. Также можно попробовать классический SLAM-метод ORB-SLAM3.
Изучить подробнее:
- RealSense — официальный сайт: документация, сравнение моделей, примеры кода
- Intel RealSense SDK 2.0 на GitHub — открытый SDK
- Сравнение моделей D415/D435/D455 — как выбрать камеру под задачу
Одометрия
Одометрия — метод оценки положения робота по данным его собственных датчиков движения. Робот считает смещение относительно стартовой точки, и со временем ошибка неизбежно накапливается.
У колёсных роботов одометрию строят через энкодеры — датчики оборотов колёс. На ровной поверхности ошибка составляет 1–5% от пройденного пути, но на скользком покрытии она растёт значительно быстрее.
У роботов с ногами колёс нет, поэтому используют проприоцептивную одометрию (англ. leg odometry): робот отслеживает углы суставов и моменты контакта ноги с поверхностью. Такая одометрия менее точна: ноги проскальзывают чаще, а контакт прерывистый.
Точность повышают через объединение нескольких датчиков (sensor fusion). Например, визуально-инерциальная одометрия (VIO) совмещает камеру и IMU. Для четвероногих роботов система VILENS объединяет камеру, лидар, IMU и данные с ног. По сравнению с нежёстким объединением тех же сенсоров она снижает ошибку по перемещению в среднем на 62%, а по повороту на 51%.
Интересный факт
Визуальную одометрию начали разрабатывать ещё в 1980-х — в исследованиях по автономной навигации планетоходов: на других планетах нет GPS, а колёса буксуют в песке. На реальном марсоходе технология заработала только в 2004-м, на Spirit и Opportunity.
Практика. Попробовать одометрию для четвероногого робота можно с проектом Cerberus 2.0 — открытой визуально-инерциально-ножной одометрией (VILO) для Unitree A1/Go1.
Проект запускается через Docker и VSCode DevContainers. Готовые записи с роботов — ROS bags с IMU, камерой, энкодерами суставов и эталонными данными (англ. ground truth) от системы захвата движения (англ. motion capture) — доступны на Google Drive.
Изучить подробнее:
- An Overview to Visual Odometry and Visual SLAM — обзорная статья о визуальной одометрии и SLAM
- VILENS: Leg Odometry for All-Terrain Legged Robots — fusion-одометрия для четвероногих роботов
- Cerberus: Visual-Inertial-Leg Odometry — открытый код одометрии для Unitree A1/Go1
Датчик момента
Датчик момента измеряет крутящий момент в суставе робота.
Он позволяет роботу «чувствовать» силу, с которой сочленения давят на объекты или объекты давят на робота. Без датчика момента робот знает, куда повернулся сустав, но не знает, с какой силой он давит. Это критично для безопасной работы рядом с людьми.
Например, коллаборативные роботы Universal Robots серии e-Series (UR3e, UR5e, UR10e) оснащены встроенным силомоментным датчиком. В Physical AI датчики момента помогают роботу удерживать баланс при ходьбе, управлять усилием при захвате хрупких предметов и корректировать движение при контакте с поверхностью.
Датчик встраивают между редуктором и звеном. Тензорезисторы измеряют деформацию упругого элемента и передают сигнал по EtherCAT или SPI с частотой до 1–3 кГц. При выборе важны диапазон моментов и температурный режим.
Интересный факт
Первого робота с датчиками момента в каждом суставе — DLR LWR I — создали в Немецком аэрокосмическом центре в 1995 году. Идея выросла из космического эксперимента ROTEX на шаттле в 1993 году.
Изучить подробнее:
- Bota Systems: Robot Joint Torque Sensors — линейка датчиков момента для роботов
- FUTEK: Torque Sensor for Robot Joint Control — применение в коллаборативной робототехнике
- DLR: History of the DLR LWR — история первых роботов с датчиками момента
Сонар
Сонар (SONAR, Sound Navigation and Ranging) — это датчик, который измеряет расстояние до объектов с помощью звуковых волн.
Излучатель посылает ультразвуковой импульс, тот отражается от препятствия, и по времени возврата датчик вычисляет расстояние. Типичная дальность — от нескольких сантиметров до 3–5 метров.
Сонар хорошо дополняет камеры и лидары: он обнаруживает прозрачные стёкла и зеркальные поверхности, которые оптические сенсоры не видят.
Главное преимущество — низкая стоимость и простота. Например, популярный датчик HC-SR04 стоит около двух долларов и подключается к Arduino двумя проводами. Самое массовое применение сонаров — парковочные системы в автомобилях.
Классический сонар имеет один луч и видит только в одном направлении. Для широкого покрытия датчики ставят веером. Однако в последнее время появляются многолучевые решения.
Интересный факт
В 2022 году Tesla отказалась от ультразвуковых датчиков и перешла на чисто камерную систему Tesla Vision.
Это решение шло вразрез с подходом остальной индустрии, которая, наоборот, добавляла сенсоры. На практике камерная парковка работала заметно хуже ультразвука — это хороший пример того, что простые датчики не всегда легко заменить нейросетевым зрением.
Практика. Начать проще всего с Arduino и уже знакомого вам модуля HC-SR04. Это самый популярный учебный сонар, который «видит» объекты на дистанции от 2 см до 4 м.
У модуля четыре вывода — питание, земля, Trig и Echo. На Trig подают импульс длиной 10 мкс, а длительность сигнала на Echo переводят в расстояние. Например, эхо в 1000 мкс соответствует примерно 17 см до препятствия.
Изучить подробнее:
- HC-SR04 Datasheet — документация устройства
- Arduino Ultrasonic Sensor Tutorial (SparkFun) — пошаговое руководство по подключению сонара к Arduino
CPU
CPU (Central Processing Unit) — центральный процессор, главный координатор всех вычислений на роботе.
В отличие от GPU, который выполняет тысячи однотипных операций параллельно, CPU выполняет сложные последовательные задачи. На роботе CPU управляет всем: запускает операционную систему, обрабатывает данные с сенсоров, координирует работу актуаторов, ведёт логирование и сетевую коммуникацию.
Бортовые вычислители роботов чаще всего построены на архитектуре ARM, а не на x86, как в настольных компьютерах. ARM-процессоры потребляют на 30–50% меньше энергии, что критично для автономных роботов с ограниченным зарядом батареи.
Например, NVIDIA Jetson AGX Orin использует 12-ядерный ARM, а новейший Jetson Thor — 14-ядерный ARM. Jetson поддерживает принцип SoC (System-on-Chip) — CPU работает совместно с GPU и специализированными ускорителями на одном кристалле и имеет общую оперативную и видеопамять.
CPU берёт на себя «дирижёрскую» работу — запуск процессов, распределение задач между ускорителями и обработку нештатных ситуаций, а тяжёлые вычисления для инференса нейросетей делегирует GPU.
Интересный факт
До середины 2000-х производители гнались за частотой процессора. Pentium 4 разогнали почти до 3,8 ГГц, а Intel метила в 10 ГГц.
Но в 2004 году компания отменила проект сверхбыстрых чипов из-за их перегрева. Энергопотребление растёт быстрее частоты. С тех пор частоты так и стоят около 3–5 ГГц. Вместо разгона инженеры начали добавлять ядра. Поэтому в серверах теперь не один быстрый CPU, а процессор на сотни ядер.
Практика. На роботах CPU обычно входит в состав SoC-модулей. Разработчику не нужно выбирать CPU отдельно — он выбирает вычислительную платформу целиком. Для прототипов часто используют Jetson Orin Nano — до 40 TOPS (триллионов целочисленных операций в секунду). Для более серьёзных задач с VLA-моделями подойдёт Jetson AGX Orin (до 275 TOPS) или Jetson Thor (до 2 070 TFLOPS в формате FP4 — это уже триллионы операций с плавающей точкой, а не целочисленных).
Изучить подробнее:
- NVIDIA Jetson — официальная страница платформы Jetson для робототехники и Edge AI
- NVIDIA Jetson Thor — вычислительная платформа нового поколения для гуманоидных роботов
- Сравнение ARM и x86 (Хабр) — обзор различий архитектур на русском языке
GPU
GPU (Graphics Processing Unit) — процессор для параллельных вычислений.
GPU содержит тысячи простых ядер, которые одновременно обрабатывают однотипные операции: умножение матриц, свёртки, попиксельную обработку изображений. Изначально GPU создавали для рендеринга графики в играх, но сегодня они стали основой для инференса нейросетей в робототехнике.
В Edge Physical AI задача GPU — запускать VLA-модель прямо на роботе, чтобы он «думал» в реальном времени без обращения в облако. Для этого используют не серверные GPU, а компактные встраиваемые модули. Например, NVIDIA Jetson Orin Nano потребляет до 25 Вт и помещается на ладони, а Jetson AGX Orin обеспечивает до 275 TOPS производительности.
Для сравнения: десктопная RTX 5090 выдаёт гораздо больше вычислительной мощности, но потребляет 575 Вт — столько энергии мобильный робот на батарее просто не может себе позволить. Поэтому выбор edge-GPU всегда балансирует между производительностью и энергоэффективностью.
Интересный факт
На Jetson Orin AGX 64 ГБ с потреблением 60 Вт можно запустить VLM-модель на 2 млрд параметров, например Cosmos Reason 2B, — этого достаточно, чтобы робот мог рассуждать, понимать реальный мир и действовать в нём.
Человеческий мозг потребляет не сильно меньше — около 20 Вт, но, по разным оценкам, выдаёт от 10 000 до 100 000 TFLOPS. Jetson Orin AGX выдаёт порядка 85 TFLOPS — разрыв в энергоэффективности между мозгом и кремнием составляет несколько порядков.
Практика. Для программирования GPU на edge-устройствах разработчики используют CUDA и TensorRT для оптимизации инференса.
На Jetson AGX Orin можно запускать VLM-модели до 2 млрд параметров. Типичный рабочий цикл: загрузить обученную модель из облака, оптимизировать её через TensorRT и запустить инференс в реальном времени на роботе.
Изучить подробнее:
- NVIDIA Jetson Developer — официальная документация и SDK для edge-GPU Jetson
- Getting Started with Edge AI on Jetson — гайд NVIDIA по запуску LLM/VLM на Jetson
- NVIDIA CUDA Toolkit — набор инструментов для GPU-программирования
Моторы
Мотор — это механизм, который преобразует электрическую энергию в движение суставов, колёс и захватов робота.
Современные гуманоиды содержат десятки моторов: Tesla Optimus Gen 2 использует 28 актуаторов в теле и ещё по 11 степеней свободы в каждой кисти, а Unitree G1 — от 23 до 43 актуаторов. Три основных типа моторов в робототехнике: сервомоторы с обратной связью от энкодера для точного управления суставами, бесщёточные моторы (BLDC) с высоким КПД и долгим сроком службы и шаговые моторы для простых задач с малой нагрузкой.
Для увеличения крутящего момента моторы сочетают с редукторами. В Tesla Optimus используют гармонические редукторы — они компактны и не имеют люфта. Другой подход — квазипрямой привод (quasi-direct drive) с редуктором малого передаточного числа (порядка 1 к 10). Именно его применил основатель Unitree в первых робособаках, снизив стоимость в 10 раз.
Интересный факт
В руках Tesla Optimus Gen 3 моторы вынесены из пальцев в предплечье и передают усилие через тендоны — как мышцы предплечья человека управляют пальцами через сухожилия.
Практика. Ключевые параметры при выборе мотора — крутящий момент, скорость, плотность момента (отношение момента к массе) и тепловыделение. Для динамичных задач вроде ходьбы подходят BLDC-моторы (Brushless DC motors — электродвигатели постоянного тока без щёток), оснащённые редукторами и энкодерами. Для позиционирования с малой нагрузкой достаточно шаговых моторов.
Изучить подробнее:
- Standard Bots: Robot Motors Guide — обзор типов моторов с рекомендациями по выбору
- FOXTECH: Motors in Humanoid Robots — разбор моторов в гуманоидах с примерами (Tesla, Boston Dynamics, UBTECH)
Роборуки
Роборука (робот-манипулятор) — это механическая система, которая воспроизводит движения человеческой руки.
Роборука состоит из звеньев, соединённых суставами (англ. joints), и захвата на конце (англ. end-effector). Каждый сустав добавляет одну степень свободы (англ. DoF — Degree of Freedom).
Стандартная промышленная роборука имеет 6 DoF — этого достаточно, чтобы поместить захват в любую точку рабочей зоны под любым углом. Для сравнения: человеческая рука от плеча до кончиков пальцев имеет около 28 степеней свободы (21 на кисть и 7 на плечи и локоть).
Роборуки разделяют на промышленные и коллаборативные.
-
Коллаборативные роборуки оснащены датчиками силы и момента, которые мгновенно останавливают движение при контакте с человеком.
-
Промышленные роборуки достигают повторяемости ±0,02 мм и несут полезную нагрузку до 30 кг и выше, но они меньше подходят для работы рядом с человеком.
Для исследований в Physical AI появились доступные роборуки: например, SO-ARM101 с поддержкой экосистемы LeRobot стоит до $ 300, а двуручная система Mobile ALOHA — около $ 32 000. Эти роборуки используют для сбора телеоп-данных и обучения VLA-моделей.
Интересный факт
Первую промышленную роборуку Unimate установили на конвейер General Motors в 1961 году.
Она весила около 1800 кг и перемещала раскалённые литые детали, избавляя рабочих от опасного контакта с горячим металлом. Первые Unimate продавались за 35 000 $ в начале 1970-х, что эквивалентно более 200 000 $ в ценах 2026 года.
Практика. Самый доступный путь — собрать SO-ARM101. Комплект моторов продаётся на Seeed Studio и AliExpress, корпус печатается на 3D-принтере. Путь до первой модели: собрать пару из «ведущей» и «ведомой» руки, установить LeRobot и откалибровать моторы, подключить камеры, записать демонстрации через телеуправление и обучить VLA-модель.
Изучить подробнее:
- LeRobot (Hugging Face) — открытая платформа с моделями, датасетами и инструкциями по сборке роборуки SO-ARM101
- SO-ARM100 на GitHub — документация и BOM для сборки доступной роборуки
- Springer Handbook of Robotics — фундаментальный справочник по кинематике и динамике манипуляторов
Сервоприводы
Сервопривод — это мотор с обратной связью, который точно отслеживает и удерживает заданное положение вала.
Внутри одного модуля объединены электродвигатель, редуктор, датчик положения (энкодер или потенциометр) и управляющая электроника.
Контроллер постоянно сравнивает текущее положение вала с целевым и корректирует мотор до тех пор, пока ошибка не станет нулевой. Именно эта замкнутая петля обратной связи отличает сервоприводы от обычных двигателей, которые работают «вслепую» — без проверки реального положения.
В робототехнике сервоприводы управляют суставами рук, ног, головы и пальцев робота. Например, в исследовательских гуманоидных роботах серия Dynamixel MX от ROBOTIS обеспечивает управление на основе PID-контроллера, который корректирует управляющий сигнал на основе трёх составляющих: пропорциональной, интегральной и дифференциальной.
А в MIT Mini Cheetah инженеры разработали собственные модульные актуаторы из бесколлекторного мотора с планетарным редуктором и кастомным контроллером, которые одинаковы для всех 12 суставов робота и легко заменяются.
Интересный факт
Само слово servo придумал французский инженер Жозеф Фарко в 1873 году — он опубликовал книгу «Le servo-moteur ou moteur asservi» («Подчинённый двигатель»), где описал механизмы управления рулём парохода.
Во время Второй мировой войны сервомеханизмы совершили скачок: их массово применяли для наведения корабельных орудий, прожекторов и радаров.
Технология, рождённая для навигации, прошла через военное применение и теперь управляет суставами роботов — от пальцев манипуляторов до ног гуманоидов.
Практика. Ключевые характеристики при выборе сервопривода — крутящий момент, скорость вращения, тип протокола (PWM, TTL, RS-485, CAN) и тип редуктора (пластиковый, металлический, циклоидный).
Для хобби-проектов и образовательных роботов подходят сервоприводы серии Dynamixel XL и AX. Для исследовательских гуманоидов и манипуляторов применяют серии MX, XH и Dynamixel P. Для динамичных роботов (робособак, гуманоидов с прыжками) используют актуаторы на основе квазипрямого привода (англ. quasi-direct-drive) с маломощным редуктором и бесколлекторным мотором.
Изучить подробнее:
- ROBOTIS Dynamixel — официальный сайт с документацией по всем сериям сервоприводов
- Управление сервоприводами (Хабр) — обзор характеристик сервоприводов и основ управления
- Dynamixel SDK на GitHub — открытая библиотека для управления сервоприводами Dynamixel на Python, C++, Java
Гуманоиды
Гуманоидный робот — это робот с телом, похожим на человеческое: две ноги, две руки, туловище и голова.
Такая форма позволяет роботу работать в пространствах, спроектированных для людей, — ходить по лестницам, открывать двери, пользоваться инструментами.
Современные гуманоиды содержат от 20 до 50+ степеней свободы (DoF). Каждая степень свободы требует отдельного актуатора — электромотора с редуктором, энкодером и контроллером. Например, Tesla Optimus Gen 2 имеет около 40 DoF: 28 DoF на тело и по 11 DoF на кисти а Unitree G1 — от 23 до 43 DoF в зависимости от конфигурации.
Для сравнения: скелет человека содержит более 200 степеней свободы, а одна кисть — 21. Актуаторы составляют более 30% стоимости гуманоида, поэтому снижение их цены — одна из ключевых задач индустрии.
В контексте Physical AI гуманоиды важны тем, что их тело близко к человеческому. Это значит, что данные, собранные с человека (например, motion capture), можно использовать для обучения моделей. Основные ограничения сегодня — время автономной работы (2–5 часов) и ловкость рук, которая сильно уступает человеческой.
Интересный факт
Unitree G1 стоит от 16 000 $, к середине 2025 года компания продала более 5500 штук — это самый массовый гуманоид в мире.
До появления G1 исследовательский гуманоид стоил сотни тысяч долларов. Снижение цены на порядок открыло доступ к гуманоидам для университетских лабораторий по всему миру.
Практика. Самый доступный старт для работы с гуманоидами — Unitree G1 EDU. Робот поддерживает ROS 2, Python и C++, а EDU-версия включает NVIDIA Jetson Orin NX для запуска нейросетей на борту.
Для обучения локомоции в симуляции используют связку NVIDIA Isaac Sim + Isaac Lab + библиотеку RSL-RL. Обучение ходьбе по плоскости занимает около 4 минут на одном GPU.
Изучить подробнее:
- Unitree G1 — самый доступный исследовательский гуманоид, поддерживает ROS 2, Python, C++
- Boston Dynamics Atlas — передовой электрический гуманоид с RL-управлением и рекордной динамикой
- GR00T N1 — открытая foundation-модель от NVIDIA для обучения гуманоидов
- Learning to Walk in Minutes — гайд для быстрого обучения ходьбе в симуляции
- Isaac Lab — фреймворк для обучения гуманоидов в симуляции с интеграцией RSL-RL
Уровень системы
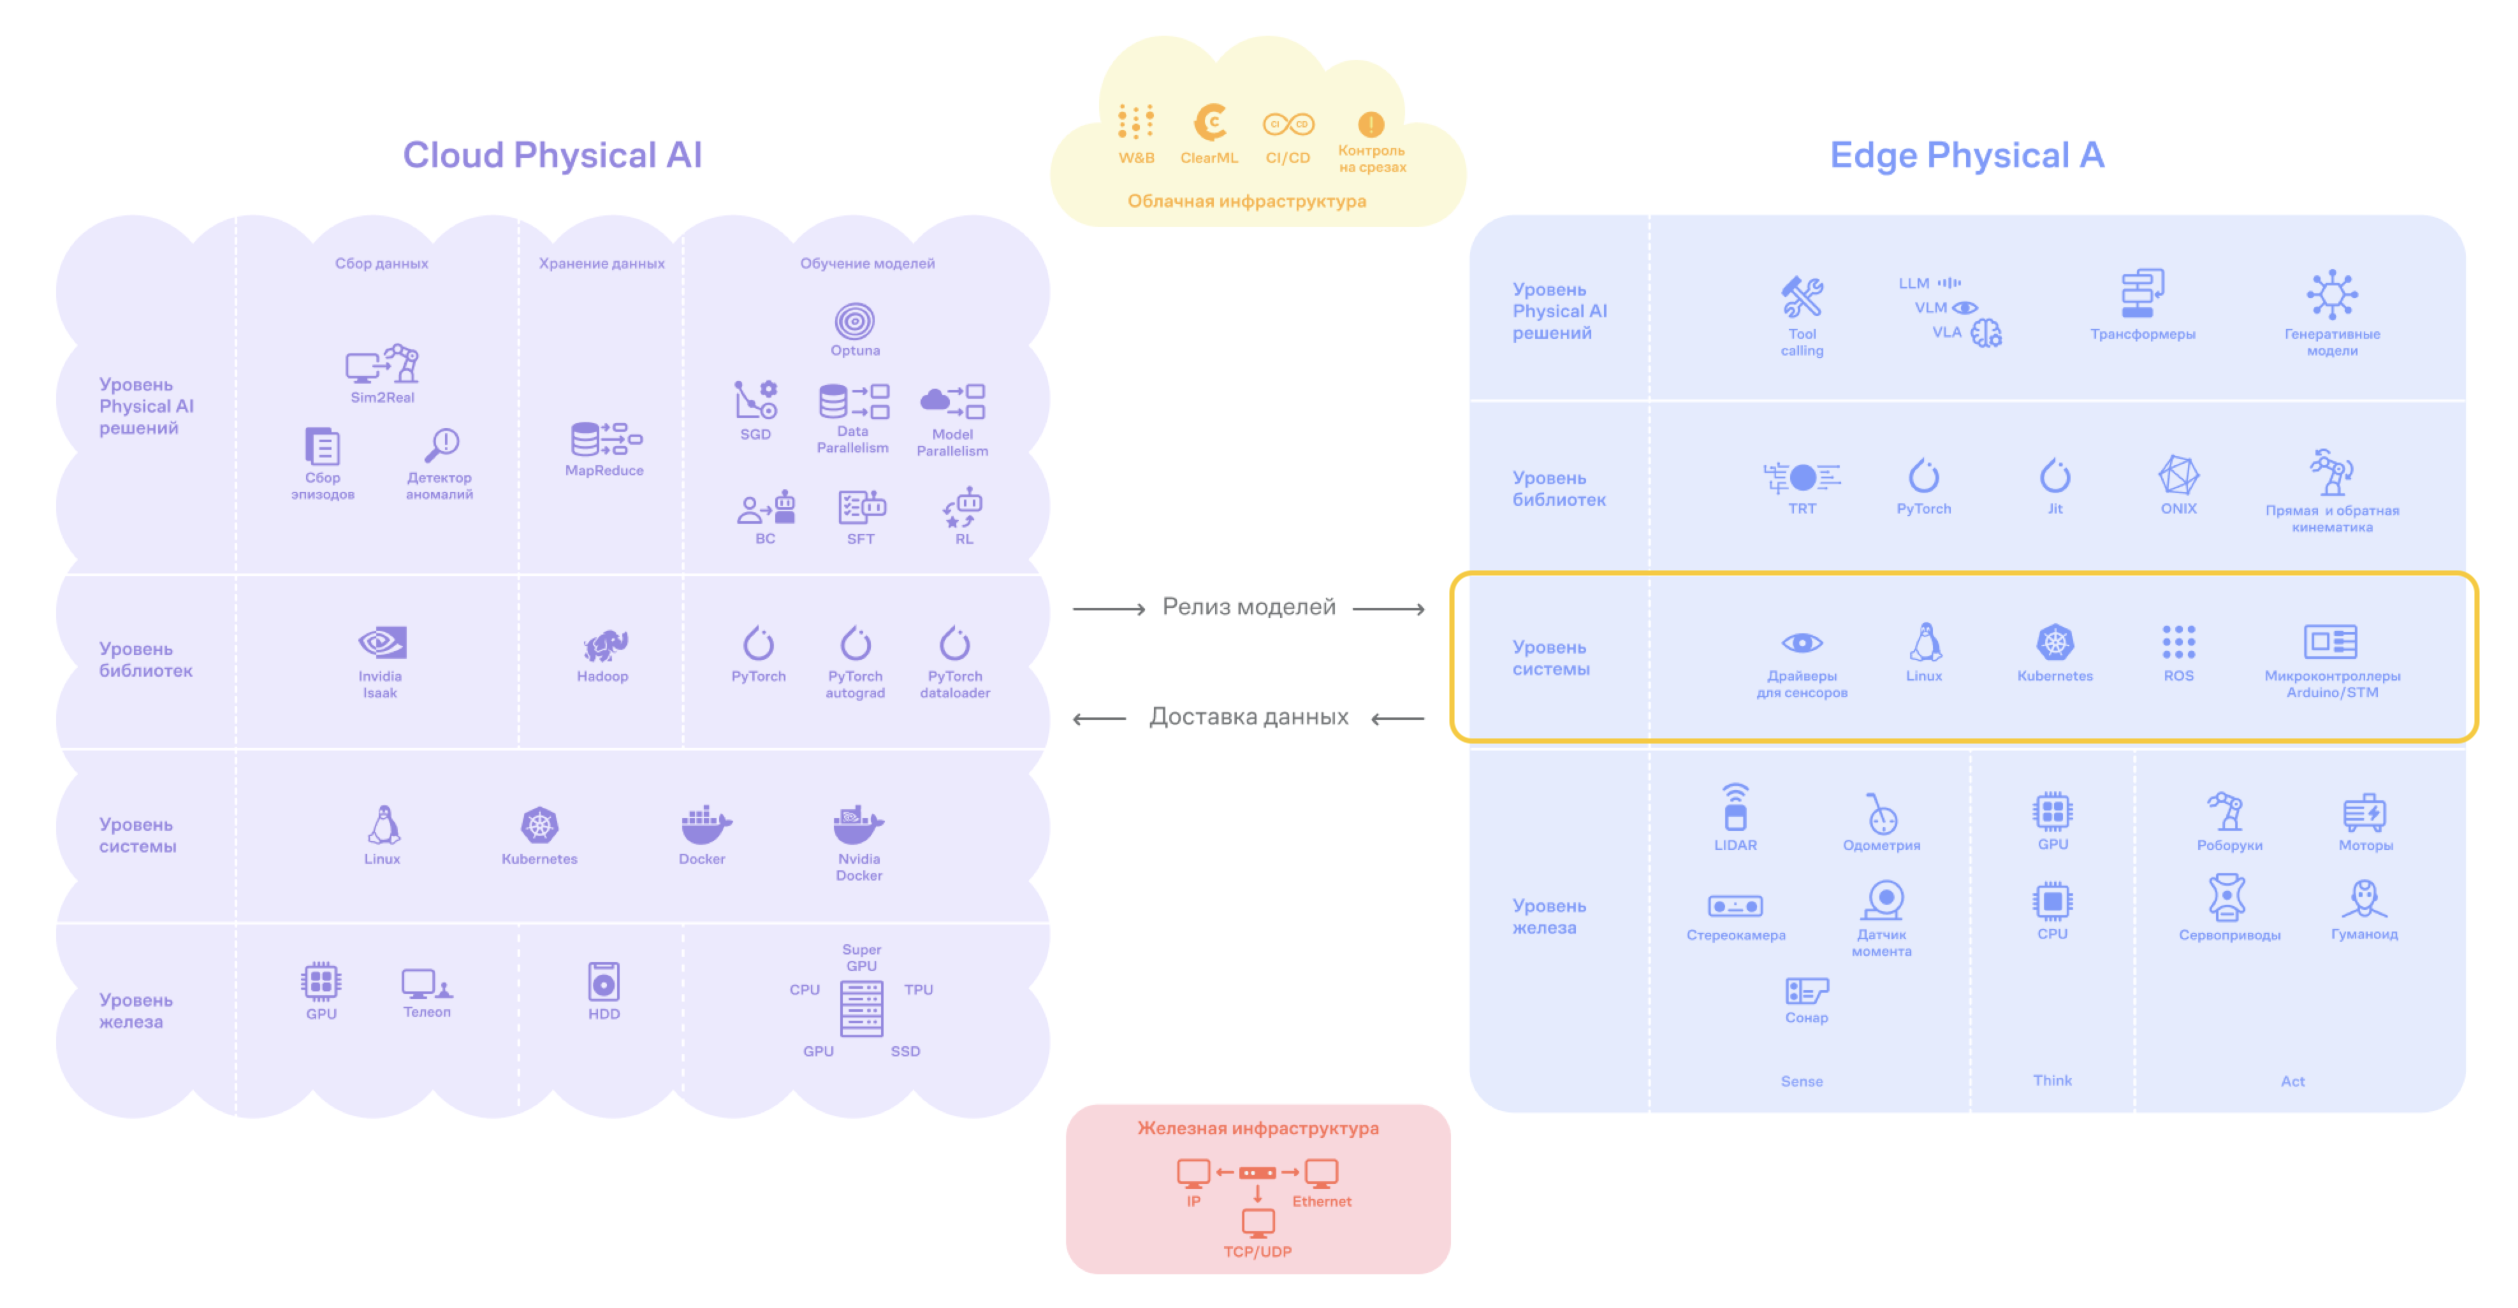
Linux
Linux — это открытая операционная система, которая служит стандартным фундаментом для Edge Physical AI.
На роботе Linux выполняет две ключевые задачи. Первая — управление аппаратными ресурсами: драйверами GPU, камер и сенсоров. Вторая — запуск ROS 2, основного фреймворка для разработки роботов.
Для управления приводами и сенсорами в реальном времени обычный Linux не подходит: стандартный планировщик ядра делает паузы до нескольких миллисекунд, что недопустимо для контроллеров движения. Поэтому на роботах устанавливают патч, который снижает задержки до 10–100 мкс.
Интересный факт
Boston Dynamics Atlas, Unitree G1 и большинство современных гуманоидных роботов работают под управлением Linux.
Практика. установить Ubuntu 22.04 LTS, поставить ROS 2 Humble или установить Ubuntu 24.04 и поставить ROS 2 Jazzy. Подробности можно посмотреть в хендбуке по основам Linux.
Изучить подробнее:
- ubuntu.com — официальный сайт Ubuntu
- Основы Linux (хендбук Яндекса) — введение в Linux и командную строку на русском
- Введение в Linux (Stepik) — бесплатный курс с нуля
Docker
Docker — это платформа контейнеризации, которая упаковывает приложение вместе со всеми зависимостями в изолированный контейнер.
На роботе Docker решает ту же задачу, что и в облаке: код инференса модели работает одинаково на любом устройстве — на ноутбуке разработчика, на тестовом стенде и на борту робота в продакшене.
Это особенно важно в Edge Physical AI, где среда выполнения жёстко зафиксирована: например, конкретная версия CUDA, TensorRT и драйвера под Jetson Orin или другой бортовой вычислитель. Главная сложность Docker на edge — архитектура ARM64.
Большинство разработчиков пишут код на x86-машинах, а бортовые компьютеры роботов чаще всего работают на ARM. Поэтому образы нужно собирать под нужную архитектуру через docker buildx. Собранный образ публикуют в реестре — например, на Docker Hub или NGC — и затем уже скачивают на робота.
Интересный факт
Есть открытый репозиторий jetson-containers, в котором собрано более 500 готовых контейнеров под Jetson: PyTorch, ROS 2, TensorRT, Isaac ROS и другие. Разработчику не нужно собирать окружение с нуля — достаточно взять нужный образ и добавить свой код.
Практика. Для запуска контейнера с доступом к GPU на Jetson нужен NVIDIA Container Toolkit (см. карточку Nvidia Docker) и флаг --gpus all при вызове docker run.
Образы собирают на x86-машине через docker buildx build --platform linux/arm64, затем публикуют в реестре и скачивают на робота командой docker pull. Базовые образы с JetPack берут с NGC.
Изучить подробнее:
- jetson-containers (GitHub) — готовые контейнеры для Jetson от NVIDIA
- Официальная документация Docker — основы и справочник по командам
- NGC-реестр: образы NVIDIA — оптимизированные контейнеры для edge и облака
- Develeap: Docker + Jetson Orin guide — практическое руководство по кросс-платформенным сборкам
ROS
ROS (Robot Operating System) — это открытый middleware-фреймворк для разработки роботов.
Он предоставляет стандартный набор инструментов: систему передачи сообщений между узлами, драйверы сенсоров и актуаторов, средства визуализации и симуляции.
ROS — это не операционная система в традиционном смысле, он работает поверх Linux и занимается коммуникацией между программными компонентами робота.
Например, узел камеры публикует изображения, а узел VLA-модели подписывается на них и публикует команды управления. Связь строится на стандарте DDS (Data Distribution Service), поэтому отдельного центрального сервера нет.
В Physical AI ROS используют как клей между железом и алгоритмами: он принимает данные с камер, лидаров и энкодеров и передаёт их в VLA-модель, а команды модели отправляет на актуаторы.
Интересный факт
ROS 1 достиг конца жизненного цикла в 2025 году, и теперь ROS 2 стал стандартом де-факто для новых робототехнических проектов — как в исследованиях, так и в промышленности. Первая версия ROS появилась ещё в 2007 году в Willow Garage и Stanford AI Lab.
Практика. Установить ROS 2 Jazzy (LTS до 2029) через apt на Ubuntu 24.04. Создать пакет командой ros2 pkg create, описать топики и сервисы, запустить узлы через launch-файлы.
Для интеграции с Physical AI — использовать NVIDIA Isaac ROS, который поставляет готовые узлы для инференса моделей на Jetson и x86 с GPU. Далее подробнее ознакомиться можно с помощью официальных туториалов.
Изучить подробнее:
- docs.ros.org — официальная документация ROS 2 Jazzy
- NVIDIA Isaac ROS — готовые пакеты ROS 2 для GPU-ускоренного инференса
- Туториалы ROS 2
Драйверы для сенсоров
Драйвер сенсора — это программный слой между операционной системой и физическим устройством.
Сенсор возвращает сырые данные: пиксели, токи с АЦП, пакеты по USB или Ethernet. Драйвер принимает эти данные и преобразует их в структурированный поток, например в топики ROS 2.
Без драйвера камера, лидар или IMU для системы просто не существуют. В Physical AI качество драйвера напрямую влияет на качество данных для обучения: задержки, потери пакетов и рассинхронизация временны́х меток ломают корреляцию между наблюдениями и действиями робота.
У каждого популярного сенсора есть свой SDK и свой драйвер ROS 2, и они не взаимозаменяемы. Например, камера Intel RealSense требует librealsense SDK, а лидар Ouster — свой пакет. Именно поэтому одна из первых задач при сборке нового робота — проверить, есть ли для каждого сенсора поддержка в нужной версии ROS 2.
Интересный факт
Для сенсоров с жёсткими требованиями по задержке, например для IMU в системах балансирования робота, используют RT-патч ядра Linux — он превращает ОС в систему реального времени с гарантированным временем отклика менее 1 мс.
Практика. Установить драйвер — значит поставить SDK производителя и пакет ROS 2. Например, для RealSense: sudo apt install ros-jazzy-realsense2-camera.
Для лидара Ouster: пакет ros2_ouster_drivers на GitHub. После установки данные сенсора появляются в топике ROS 2 и доступны всем узлам системы.
Изучить подробнее:
- ROS 2 Sensor Drivers — список поддерживаемых сенсоров
- RT-патч ядра Linux для роботов Universal Robots
- Intel RealSense ROS 2 — документация
- Ouster driver — документация
Микроконтроллеры (Arduino/STM)
Микроконтроллер — это компактный вычислитель, который объединяет процессор, память и набор периферийных интерфейсов в одном чипе.
Его задача — выполнять жёсткие команды управления в реальном времени: читать данные с энкодеров, генерировать PWM-сигналы для моторов, опрашивать датчики по шинам I²C и SPI. Это не «умная» часть робота — это «быстрая» часть.
Большие вычислители наподобие Jetson Orin или одноплатного компьютера занимаются инференсом модели и принимают решения. Микроконтроллер принимает команды от вычислителя и переводит их в конкретные электрические сигналы с предсказуемыми задержками в единицы микросекунд.
Два самых распространённых семейства в робототехнике — это Arduino (простой вход с большой экосистемой библиотек) и STM32 (ARM Cortex-M, промышленный стандарт с высокой точностью таймеров и аналоговых периферий).
Интересный факт
В марте 2026 года Arduino совместно с Qualcomm анонсировала плату Ventuno Q с двойной архитектурой: один процессор — Qualcomm Dragonwing IQ8 для AI-инференса, второй — STM32H5 для детерминированного управления моторами и датчиками.
Это прямое отражение разделения ролей внутри роботов Physical AI.
Практика. Arduino используют для прототипирования и недорогих учебных стендов. STM32 — в продакшен-роботах, где нужна точность таймеров и надёжность.
Микроконтроллер подключают к основному вычислителю через интерфейс передачи данных UART или CAN-шину и прошивают через ROS 2 micro-ROS, что позволяет публиковать данные с сенсоров прямо в ROS-граф.
Изучить подробнее:
- STM32 Getting Started (ST) — официальная документация и инструменты STMicroelectronics
- micro-ROS для STM32 и Arduino — интеграция микроконтроллеров в граф ROS 2
Уровень библиотек
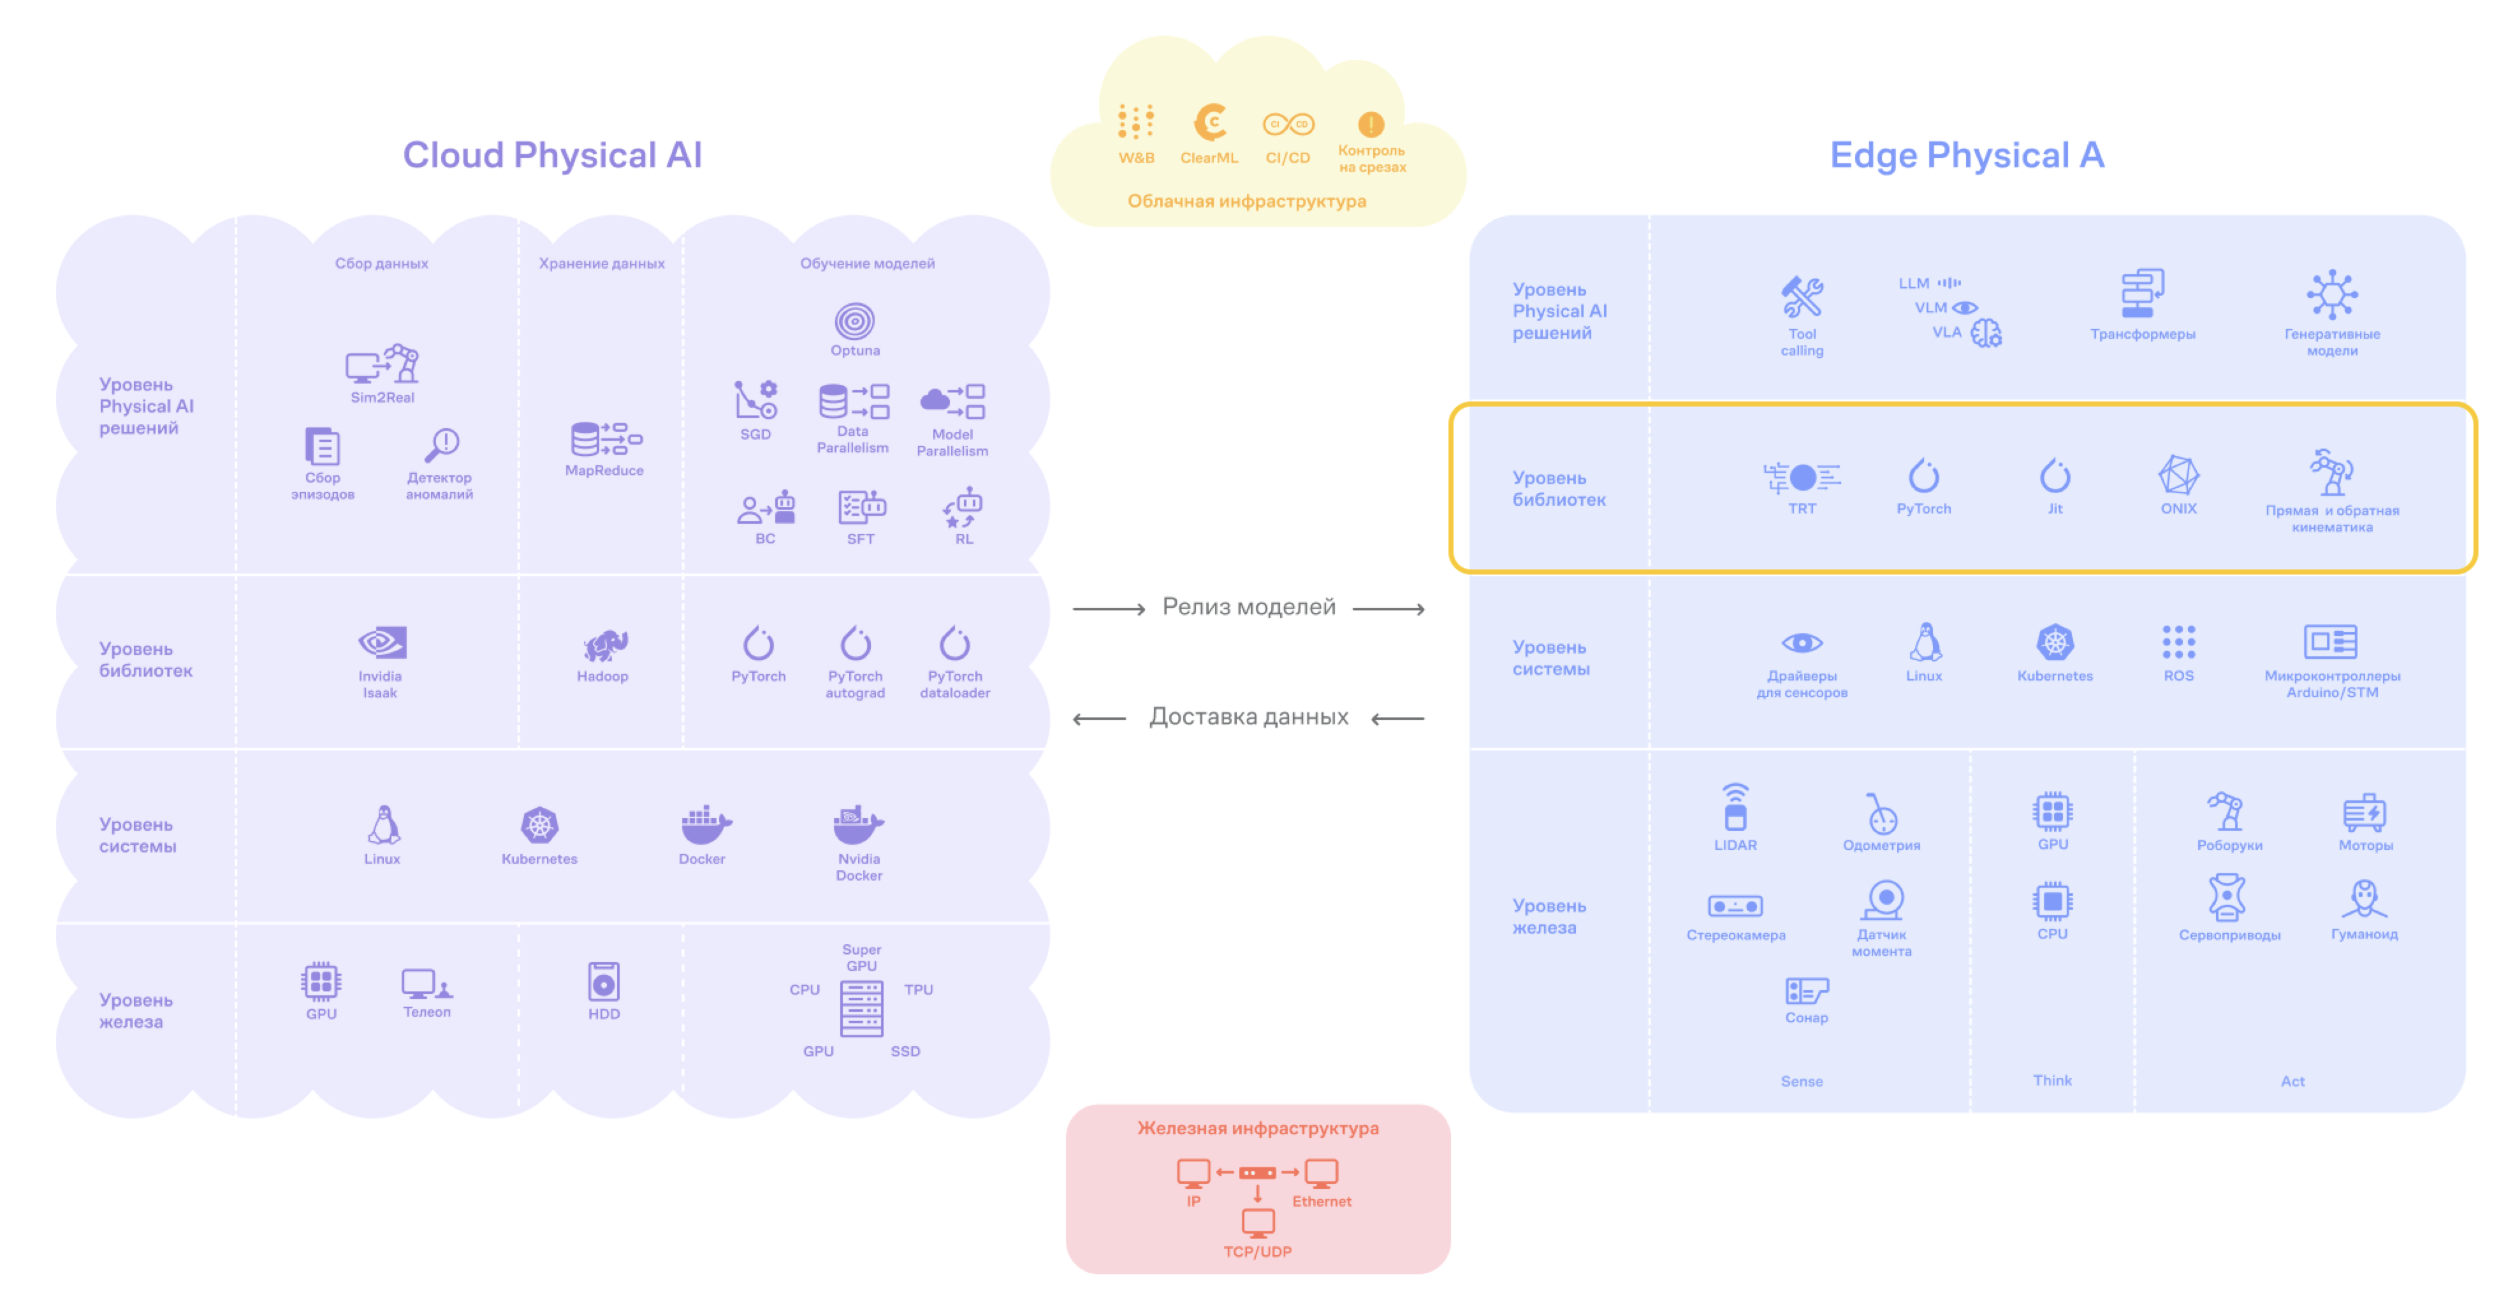
PyTorch
PyTorch на edge-устройстве — это не полная библиотека, а её урезанная версия для инференса уже обученной модели.
В облаке PyTorch нужен для всего. Он строит граф вычислений, считает обратное распространение ошибки и обновляет веса. На роботе из всего этого нужен только прямой проход (forward).
Поэтому на edge запускают не сам PyTorch, а экспортированную модель. Современный путь — экспорт через torch.export и запуск в лёгком рантайме ExecuTorch, который не зависит от Python.
Второй частый путь — перевод модели в ONNX. ONNX отвязывает модель от PyTorch, и её можно запустить в любом совместимом рантайме, например в ONNX Runtime. Для NVIDIA Jetson дополнительно применяют TensorRT. Он компилирует модель под конкретную архитектуру GPU и ускоряет инференс в 2–5 раз.
Интересный факт
Рантайм ExecuTorch весит всего около 50 КБ и помещается даже на микроконтроллер.
Тот же рантайм крутит AI в WhatsApp и очках Ray-Ban Meta. Но в робототехнике его берут редко. Роботы чаще работают на Jetson или x86, где ONNX Runtime и TensorRT выжимают из железа больше.
Практика. Экспортируйте модель через torch.export для ExecuTorch или через torch.onnx.export(model, ..., dynamo=True) для ONNX. ONNX-модель запускают через onnxruntime.InferenceSession. Для Jetson модель прогоняют через TensorRT, например утилитой trtexec.
Изучить подробнее:
- ExecuTorch — лёгкий рантайм PyTorch для запуска моделей на edge без Python
- torch.export — экспорт модели в переносимый граф
- ONNX Runtime — запуск моделей без PyTorch
- TensorRT — компиляция и ускорение инференса на NVIDIA Jetson
JIT
PyTorch JIT (Just-In-Time) — это компиляция модели в граф вычислений на лету.
Обычный PyTorch выполняет операции по очереди через интерпретатор Python. Это удобно при отладке, но медленно. JIT-компилятор разбирает модель и собирает соседние операции в один кернел.
Такое объединение называют фьюзингом. Оно сокращает количество обращений к памяти и ускоряет модель. В современном PyTorch за JIT отвечают torch.compile, который ускоряет модель прямо в Python через бэкенд TorchInductor. Также есть torch.export, который сохраняет модель в переносимый граф для запуска без Python, например на роботе.
Интересный факт
Главный выигрыш от фьюзинга не в самих вычислениях. Многие операции в нейросетях упираются не в скорость GPU, а в скорость памяти.
GPU успевает посчитать и простаивает, пока ждёт данные из памяти. Фьюзинг объединяет операции и держит промежуточные результаты в регистрах. Поэтому обращений к памяти меньше, а ускорение есть, хотя число арифметических операций то же самое.
Практика: Чтобы ускорить обучение или инференс в Python, оберните модель в torch.compile. Часто хватает одной строки. Чтобы подготовить модель к запуску на роботе без Python, используйте torch.export, который переводит эту модель в формат .pt2. Для самого edge-устройства подойдёт лёгкий рантайм ExecuTorch.
Изучить подробнее:
- Why Is PyTorch Compile So Fast: Kernel Fusion — наглядный разбор от команды PyTorch, как Inductor фьюзит операции в один кернел
- torch.compile tutorial — официальный гайд, как ускорить модель одной строкой
- torch.export — документация по экспорту модели для запуска без Python
ONNX
ONNX (Open Neural Network Exchange) — открытый стандарт для представления нейронных сетей в виде единого графа операторов.
Его задача — разорвать привязку модели к конкретному фреймворку. Модель обучают в PyTorch, экспортируют в .onnx-файл, а запускают через ONNX Runtime, TensorRT или CoreML — без переписывания кода.
В Physical AI ONNX — стандартный мост между облаком и edge: модель обучили на кластере H100, экспортировали через torch.onnx.export(...) и задеплоили на Jetson. ONNX Runtime при этом ускоряет инференс в 2–5 раз по сравнению с нативным PyTorch.
Интересный факт
ONNX изначально назывался Toffee и разрабатывался командой PyTorch.
В 2017 году проект переименовали и анонсировали совместно с Microsoft. Сегодня ONNX встроен в Windows, Azure и Microsoft Office.
Практика. экспортируйте модель командой torch.onnx.export(model, dummy_input, "model.onnx"), затем запустите через onnxruntime.InferenceSession("model.onnx").
Перед деплоем проверьте граф через onnx.checker.check_model(...). Для оптимизации под конкретное железо передайте .onnx в TensorRT или OpenVINO.
Изучить подробнее:
- onnx.ai — официальный сайт и список поддерживаемых операторов
- onnxruntime.ai — ONNX Runtime, старт за 5 минут
- pytorch.org/docs/stable/onnx.html — экспорт из PyTorch
TRT
TRT (TensorRT) — SDK от NVIDIA для оптимизации инференса нейронных сетей на GPU.
Принимает обученную модель из PyTorch или TensorFlow, компилирует её в движок под конкретное железо и применяет серию оптимизаций: слияние слоёв (англ. layer fusion), квантизацию весов (FP16, INT8, FP8), автоподбор CUDA-ядер.
В результате та же модель работает быстрее без потери точности. В Physical AI TensorRT применяют на последнем шаге перед деплоем на робота: модель обучили в облаке, экспортировали в формат ONNX, см. карточку выше, и скомпилировали через TensorRT под Jetson
Интересный факт
TensorRT-движок нельзя собрать на одной карте и запустить на другой.
Во время компиляции TensorRT замеряет скорость CUDA-ядер прямо на железе и зашивает в движок тактики под конкретную архитектуру.
Поэтому артефакт привязан к номеру версии GPU-архитектуры. У облачной A100 это SM 8.0, у бортового Jetson Orin — SM 8.7. Скомпилировать модель на A100 в облаке и закинуть готовый движок на Jetson не выйдет — рантайм выдаст ошибку либо скорость будет неоптимальной. Компилировать нужно на той же платформе, где модель будет работать.
Практика. экспортируйте модель в ONNX через torch.onnx.export(...), затем скомпилируйте движок через trtexec --onnx=model.onnx --saveEngine=model.trt. Для квантизации выбирайте значение FP16 как базу, INT8 — если нужна экономия памяти с калибровкой, FP8 — на видеокартах серии Hopper/Blackwell (H100, B200).
Изучить подробнее:
- developer.nvidia.com/tensorrt — официальная документация и SDK
- Hello AI World: TensorRT on Jetson — пошаговый туториал по деплою на Jetson
- TensorRT Developer Guide — подробное руководство по оптимизации
Прямая и обратная кинематика
Прямая и обратная кинематика (англ. forward/inverse kinematics, FK/IK) — это два способа перехода между описаниями положения робота.
FK отвечает на вопрос: «Какое положение займёт захват, если повернуть суставы на заданные углы?»
IK решает обратную задачу: «На сколько градусов повернуть каждый сустав, чтобы захват оказался в нужной точке?»
FK вычисляется быстро и однозначно — это просто последовательное перемножение матриц преобразования, сложность O(n) по числу суставов. IK требует решения нелинейных уравнений: для одной точки может существовать несколько решений, например «локоть вверх» или «локоть вниз», а иногда решения нет вообще.
В классической робототехнике IK — ключевой инструмент управления манипулятором. В Physical AI её роль меньше: end-to-end VLA-модели генерируют команды напрямую, минуя явное вычисление кинематики. Однако FK остаётся незаменимой для симуляции — именно по ней симулятор вычисляет текущую позу робота на каждом шаге.
Интересный факт
Для 6-степенного манипулятора со сферическим запястьем существует замкнутое аналитическое решение IK — максимум 8 конфигураций на одну точку.
Именно поэтому почти все промышленные роботы намеренно проектируются с таким сочленением: это гарантирует детерминированный и быстрый расчёт без численного перебора. Классический Stanford Arm (1969) стал одним из первых роботов с таким дизайном.
Практика. FK реализована в большинстве симуляторов — например, в NVIDIA Isaac Sim и MuJoCo — автоматически. IK в ROS 2 решается через пакет MoveIt 2 с солверами KDL или TracIK.
Для нестандартных роботов используют численные методы — например, библиотеку pink на Python.
Изучить подробнее:
- MoveIt 2 — документация по IK: практика планирования движений в ROS 2
- MIT OpenCourseWare: Introduction to Robotics — классический курс с выводом FK/IK
- pink: библиотека IK на Python — современный инструмент для численной обратной кинематики
Уровень решений Physical AI
Tool Calling
Tool Calling — это механизм, при котором языковая модель не просто генерирует текст, а вызывает внешние функции и программы.
Модель запрашивает список доступных инструментов с описаниями. Когда нужный инструмент найден, модель возвращает JSON с именем функции и аргументами.
Приложение выполняет вызов и возвращает результат обратно в модель. Tool Calling стал очень популярен внутри LLM-систем: за счёт него современные нейросети умеют искать информацию в интернете или выполнять команды в терминале.
В Physical AI это пока молодое направление. VLA-модель может вызывать, например, классический алгоритм навигации или детектор коллизий как внешний инструмент, не решая эти задачи самостоятельно.
Интересный факт
До июня 2023 года GPT-4 уже умел вызывать функции — это была эмерджентная способность, появившаяся без специального обучения.
OpenAI официально представил Function Calling (другое название Tool Calling) в июне 2023 года. Именно тогда модели дообучили на этой задаче, и использование LLM как агентов стало по-настоящему практичным.
Практика. Описать инструмент через JSON Schema — имя, параметры, типы. Передать описание в модель вместе с запросом. Разобрать ответ и выполнить вызов на стороне приложения. Вернуть результат в контекст.
Изучить подробнее:
- Anthropic: Tool Use Documentation — официальная документация по tool use в Claude
- OpenAI: Function Calling Guide — официальная документация OpenAI
- Prompt Engineering Guide: Function Calling — краткий обзор с примерами
VLA
VLA (Vision-Language-Action model) — класс нейронных сетей, которые объединяют восприятие, понимание языка и управление роботом в одной модели.
На вход VLA получает кадры с камер и текстовую команду, например «положи яблоко в корзину». На выходе — траектория движения манипулятора.
До появления VLA восприятие, планирование и управление строились как отдельные модули с явными границами между ними. VLA заменяет всё это одной end-to-end моделью.
Первой массово известной VLA стала RT-1 от Google (2022), обученная на 130 000 реальных эпизодов. В 2024–2025 годах появились π0 (Physical Intelligence), GR00T N1 (NVIDIA) и SmolVLA (Hugging Face) — модели, которые работают на десятках типов роботов без переобучения с нуля.
Также есть OpenVLA — открытая VLA с 7 млрд параметров, которая обучена на датасете Open X-Embodiment. В создании этого датасета участвовали специалисты из 21 института: более миллиона эпизодов на 22 разных роботах. Большую часть эпизодов операторы записывали вручную через телеоп, остальное собрали скриптами и автономными политиками.
Интересный факт
RT-2 научился выполнять команды вроде «возьми предмет, равный сумме двух плюс один», хотя никаких математических задач в обучающих данных роботов не было. Эта способность к рассуждению появилась сама из интернет-данных, на которых была предобучена VLM.
Практика. Попробовать VLA проще всего через LeRobot (Hugging Face) — там есть готовые скрипты для обучения и инференса. Для кастомной задачи берут претренированную модель (например, OpenVLA или GR00T N1) и файнтюнят на 50–200 собственных демонстрациях.
Изучить подробнее:
- OpenVLA на GitHub — код, датасеты, инструкция по файнтюну через LoRA
- LeRobot (Hugging Face) — фреймворк для обучения VLA на своём роботе
- π0: A Vision-Language-Action Flow Model — статья Physical Intelligence
- Обзор VLA-моделей (IEEE Access, 2025) — академический обзор по теме
VLM
VLM (Vision-Language Model) — это мультимодальная нейросеть, которая одновременно «видит» и «читает»: принимает на вход изображение и текст, а выдаёт текстовый ответ.
Архитектурно VLM состоит из трёх частей.
- Первая — визуальный энкодер, например ViT, который переводит изображение в числовые эмбеддинги.
- Вторая — проекционный слой, который переводит визуальные эмбеддинги в формат, понятный языковой модели.
- Третья — сама LLM, которая генерирует ответ.
В Physical AI VLM — это основа для VLA-моделей: нейросеть получает кадры с камер робота и текстовую инструкцию, а на выходе генерирует управляющие команды. Например, π0 использует SigLIP в роли визуального энкодера и Gemma 2.6B в роли языковой части.
Интересный факт
Коммерческий прорыв VLM случился в 2023 году с выходом GPT-4V от OpenAI. До этого модели существовали в академических статьях, но массового применения не имели.
Сегодня VLM лежит в основе большинства систем Physical AI — от роботов-манипуляторов до беспилотных автомобилей.
Практика. Для экспериментов с VLM берут готовый открытый чекпойнт, например LLaVA или Qwen2.5-VL, и дообучают его на своих данных через LoRA. Минимальный пример: nanoVLM от Hugging Face.
Изучить подробнее:
- Hugging Face: Vision Language Models Explained — обзор архитектур и готовые чекпойнты
- Qwen2.5-VL на Hugging Face — сильная открытая VLM с поддержкой видео
- Wikipedia: Vision-Language Model — обзор истории и архитектур
LLM
LLM (Large Language Model) — языковая нейросеть, обученная предсказывать следующий токен на триллионах слов текста из интернета, книг и кода.
LLM генерирует текст по одному токену за раз. Токен — это кусочек слова, который перевели в вектор из чисел. Модель смотрит на предыдущие токены и предсказывает следующий. Этот приём называют авторегрессией. Архитектурная основа всех современных LLM — это трансформеры.
В 2017 году Google предложил новую архитектуру нейронной сети — трансформер. А уже в 2018 году OpenAI выпустил GPT-1 на основе трансформеров и задал подход «предобучение на больших текстах, затем дообучение под задачу». В 2020 году GPT-3 со 175 млрд параметров показал, что модель умеет решать задачи без дообучения, по нескольким примерам прямо в запросе. В 2022 году вышел ChatGPT и сделал такие модели массовыми.
В Physical AI LLM — это фундамент для VLA-моделей. Робот получает знания об окружающем мире из предобученного LLM, а потом дообучается на данных с манипуляторов. Например, π0 использует Gemma 2.6B, а GR00T N1 — собственную языковую модель NVIDIA.
Интересный факт
В контролируемом эксперименте GPT-4.5 был идентифицирован как человек в 73% случаев — и показал результат выше, чем реальный участник-человек в той же задаче. Это первое экспериментальное доказательство, что LLM проходит тест Тьюринга.
Это первое экспериментальное доказательство, что LLM проходит тест Тьюринга.
Практика. LLM подключают через API — например, OpenAI или Anthropic — или запускают локально через transformers от Hugging Face. Для адаптации под робототехнические задачи применяют SFT и LoRA.
Изучить подробнее:
- Хендбук Яндекса по ML — русскоязычная база по нейросетям
- Hugging Face NLP Course — практический курс с кодом
Трансформеры
Трансформер — это архитектура нейронной сети, основанная на механизме внимания (англ. attention). В 2017 году Google предложил эту архитектуру в статье «Attention Is All You Need». Сейчас на ней построены все современные LLM.
Трансформер обрабатывает все токены входной последовательности параллельно во время обучения. Это принципиально отличает его от RNN, которые обрабатывали токены по одному.
За счёт параллелизма трансформеры хорошо масштабируются на GPU и позволяют обучать модели на триллионах токенов текста.
В Physical AI трансформер стал основой для VLA-моделей: например, π0 от Physical Intelligence и RT-1 от Google используют трансформер для обработки видео и языковых команд.
Интересный факт
Название «трансформер» появилось случайно: соавтору статьи Якобу Ушкорейту просто понравилось звучание этого слова.
Все восемь авторов оригинальной статьи покинули Google и основали собственные стартапы — среди них Character.ai и Adept.
Практика. Трансформеры используют через библиотеку transformers от Hugging Face: pip install transformers. Загрузить предобученную модель и запустить инференс можно через AutoModel и AutoTokenizer из этой библиотеки. Для обучения с нуля используют Trainer API или PyTorch напрямую.
Изучить подробнее:
- Attention Is All You Need — оригинальная статья о трансформере
- Attention Is All You Need (Хабр) — русский перевод статьи с объяснениями
Генеративные модели
Генеративные модели Physical AI — это нейросети, которые не просто классифицируют входные данные, а порождают новые данные: изображения, траектории, последовательности действий.
В Physical AI генеративные модели используют для генерации управляющих команд на основе наблюдений с камер и текстовых инструкций.
Есть два основных подхода:
Первый подход — авторегрессионные модели.
Они работают как языковые модели LLM, только предсказывают не слова, а действия. Непрерывное действие робота разбивают на дискретные уровни.
Каждый уровень становится токеном действия. Модель выдаёт токены один за другим, как LLM выдаёт слова. Например, так работают VLA-модели типа RT-2 или OpenVLA.
Второй — диффузионные модели и flow matching.
Они генерируют всю траекторию сразу, итеративно уточняя «зашумлённые» действия. Например, DiVLA-2B генерирует действия на частоте 82 Гц.
Диффузионные модели дают более плавные траектории, но работают медленнее авторегрессионных. Однако в последнее время набирает популярность подход flow matching — например, в π0, который решает проблему в скорости.
Интересный факт
Диффузионная модель использует тот же алгоритм, что Stable Diffusion и DALL-E. Подход пришёл из генерации изображений — score-matching из DDPM и DDIM.
Только модель в Physical AI «вычищает» из случайного шума не картинку, а траекторию движения робота. План действий робот генерирует так же, как нейросеть рисует изображение.
Практика. Для старта удобно взять π0 (Physical Intelligence) или OpenVLA — оба есть в открытом доступе. Диффузионную политику можно попробовать через библиотеку LeRobot от Hugging Face: там есть готовые пайплайны для сбора данных и обучения.
Есть гайд, в котором разобрано, как работать с диффузионной политикой в LeRobot.
Изучить подробнее:
- π0: блогпост Physical Intelligence — описание архитектуры и flow matching
- OpenVLA на GitHub — открытая VLA-модель с инструкцией по дообучению
- LeRobot (Hugging Face) — библиотека для обучения политик на дешёвом железе
- Diffusion Policy (Chi et al.) — оригинальная статья и код диффузионной политики
- Tutorial для LeRobot — пошаговый гайд для введения в LeRobot
- Diffusion models for robotic manipulation: a survey — научный обзор диффузионных политик для манипуляторов
В следующем параграфе мы расскажем про облачную инфраструктуру: слой, который связывает Cloud и Edge Physical AI в единый цикл.