

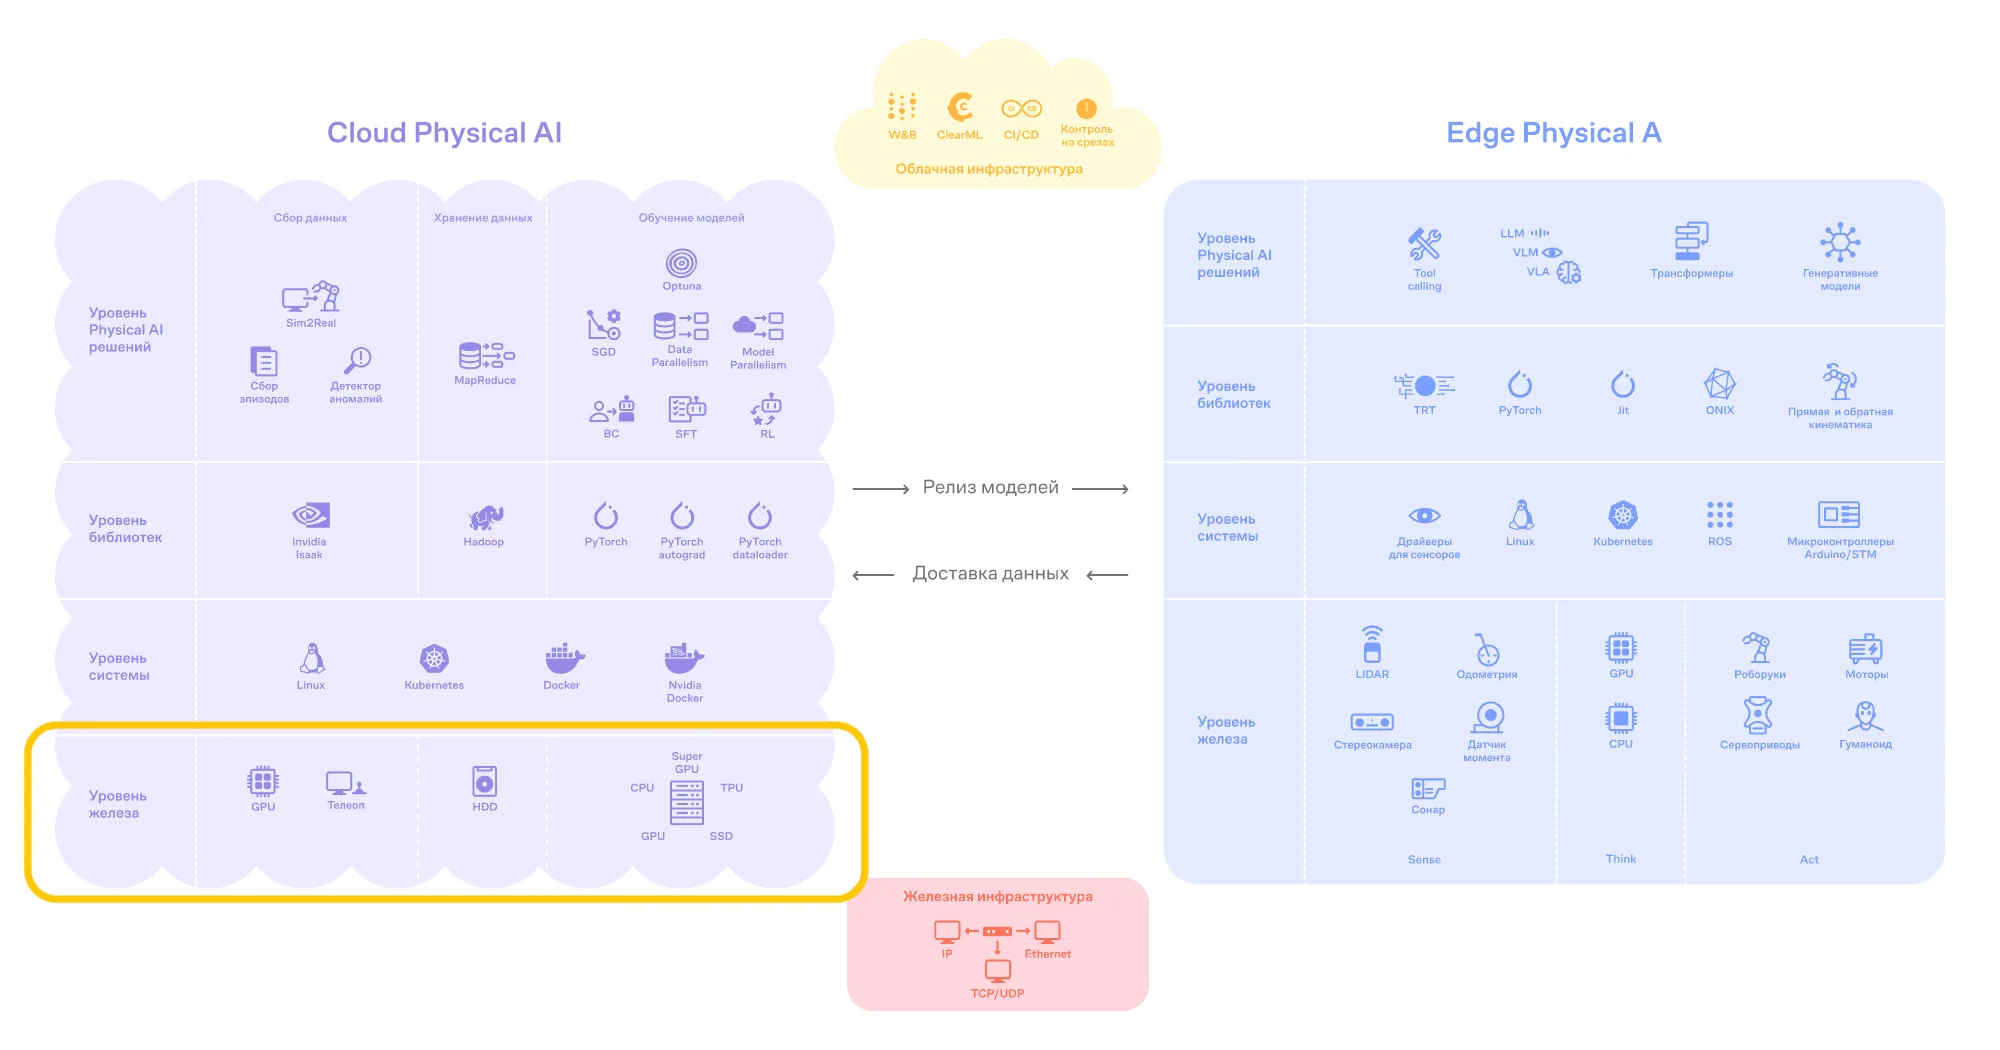
Cloud Physical AI — это облачная половина системы Physical AI.
Облако отвечает не за работу робота, а за обучение его модели. Внутри Cloud Physical AI устроен по уровням — так же, как и Edge-часть на самом роботе.
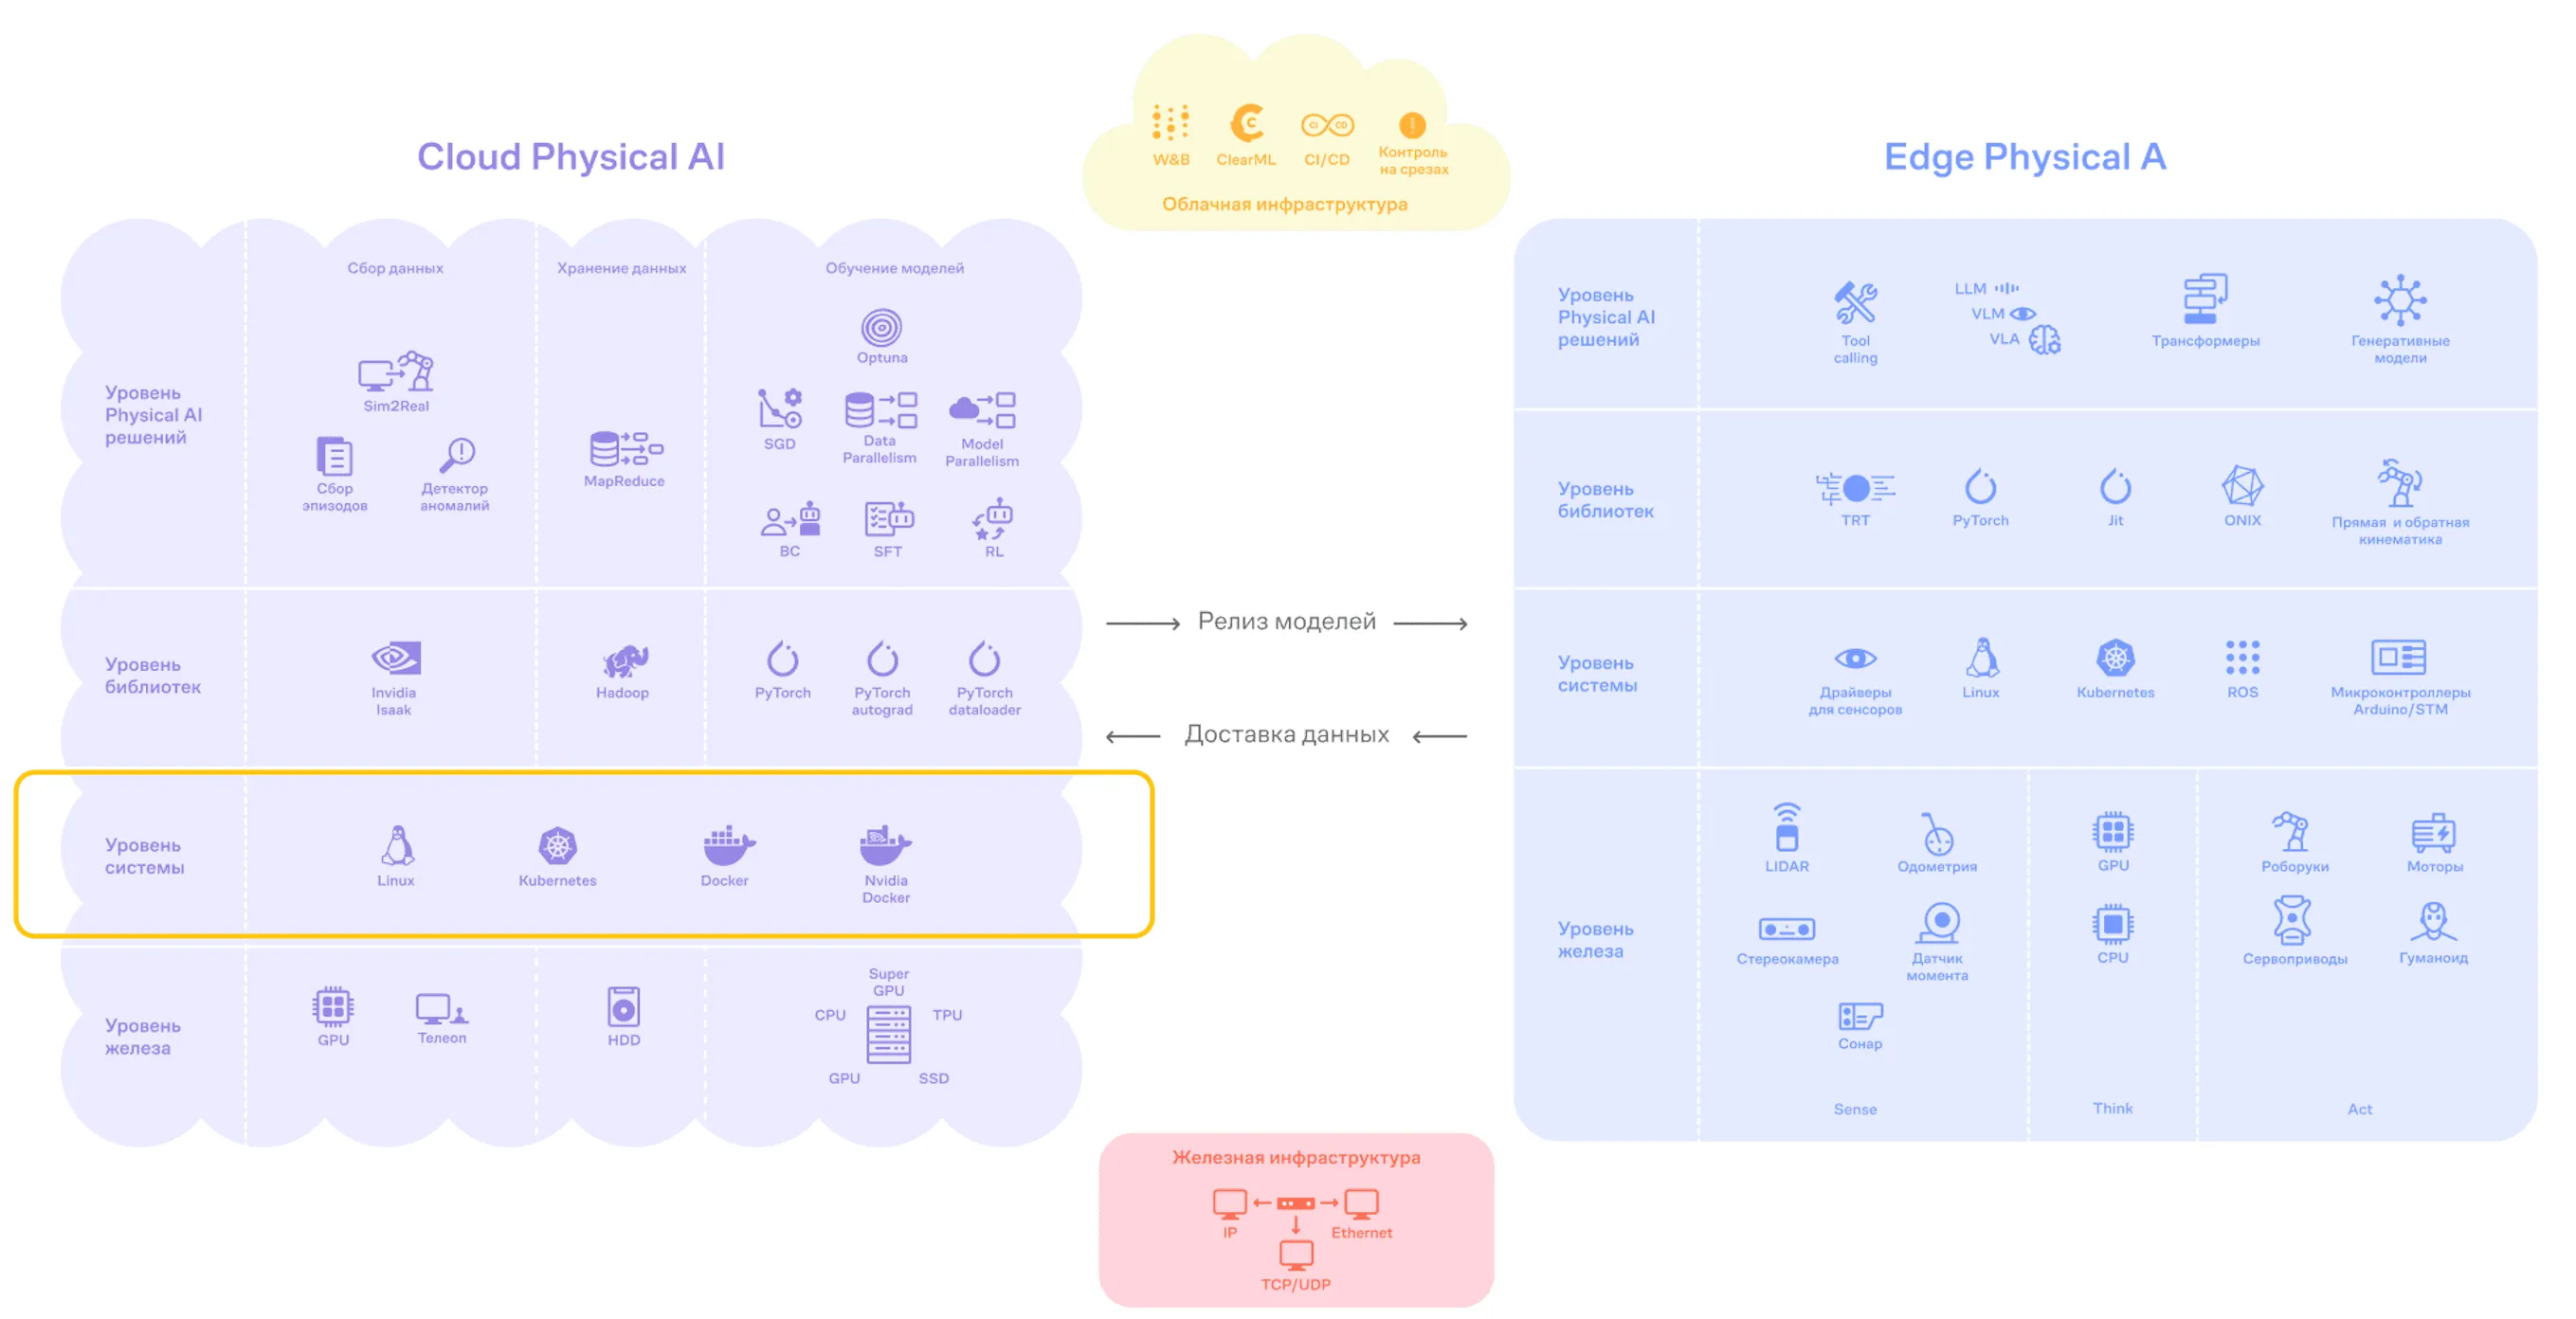
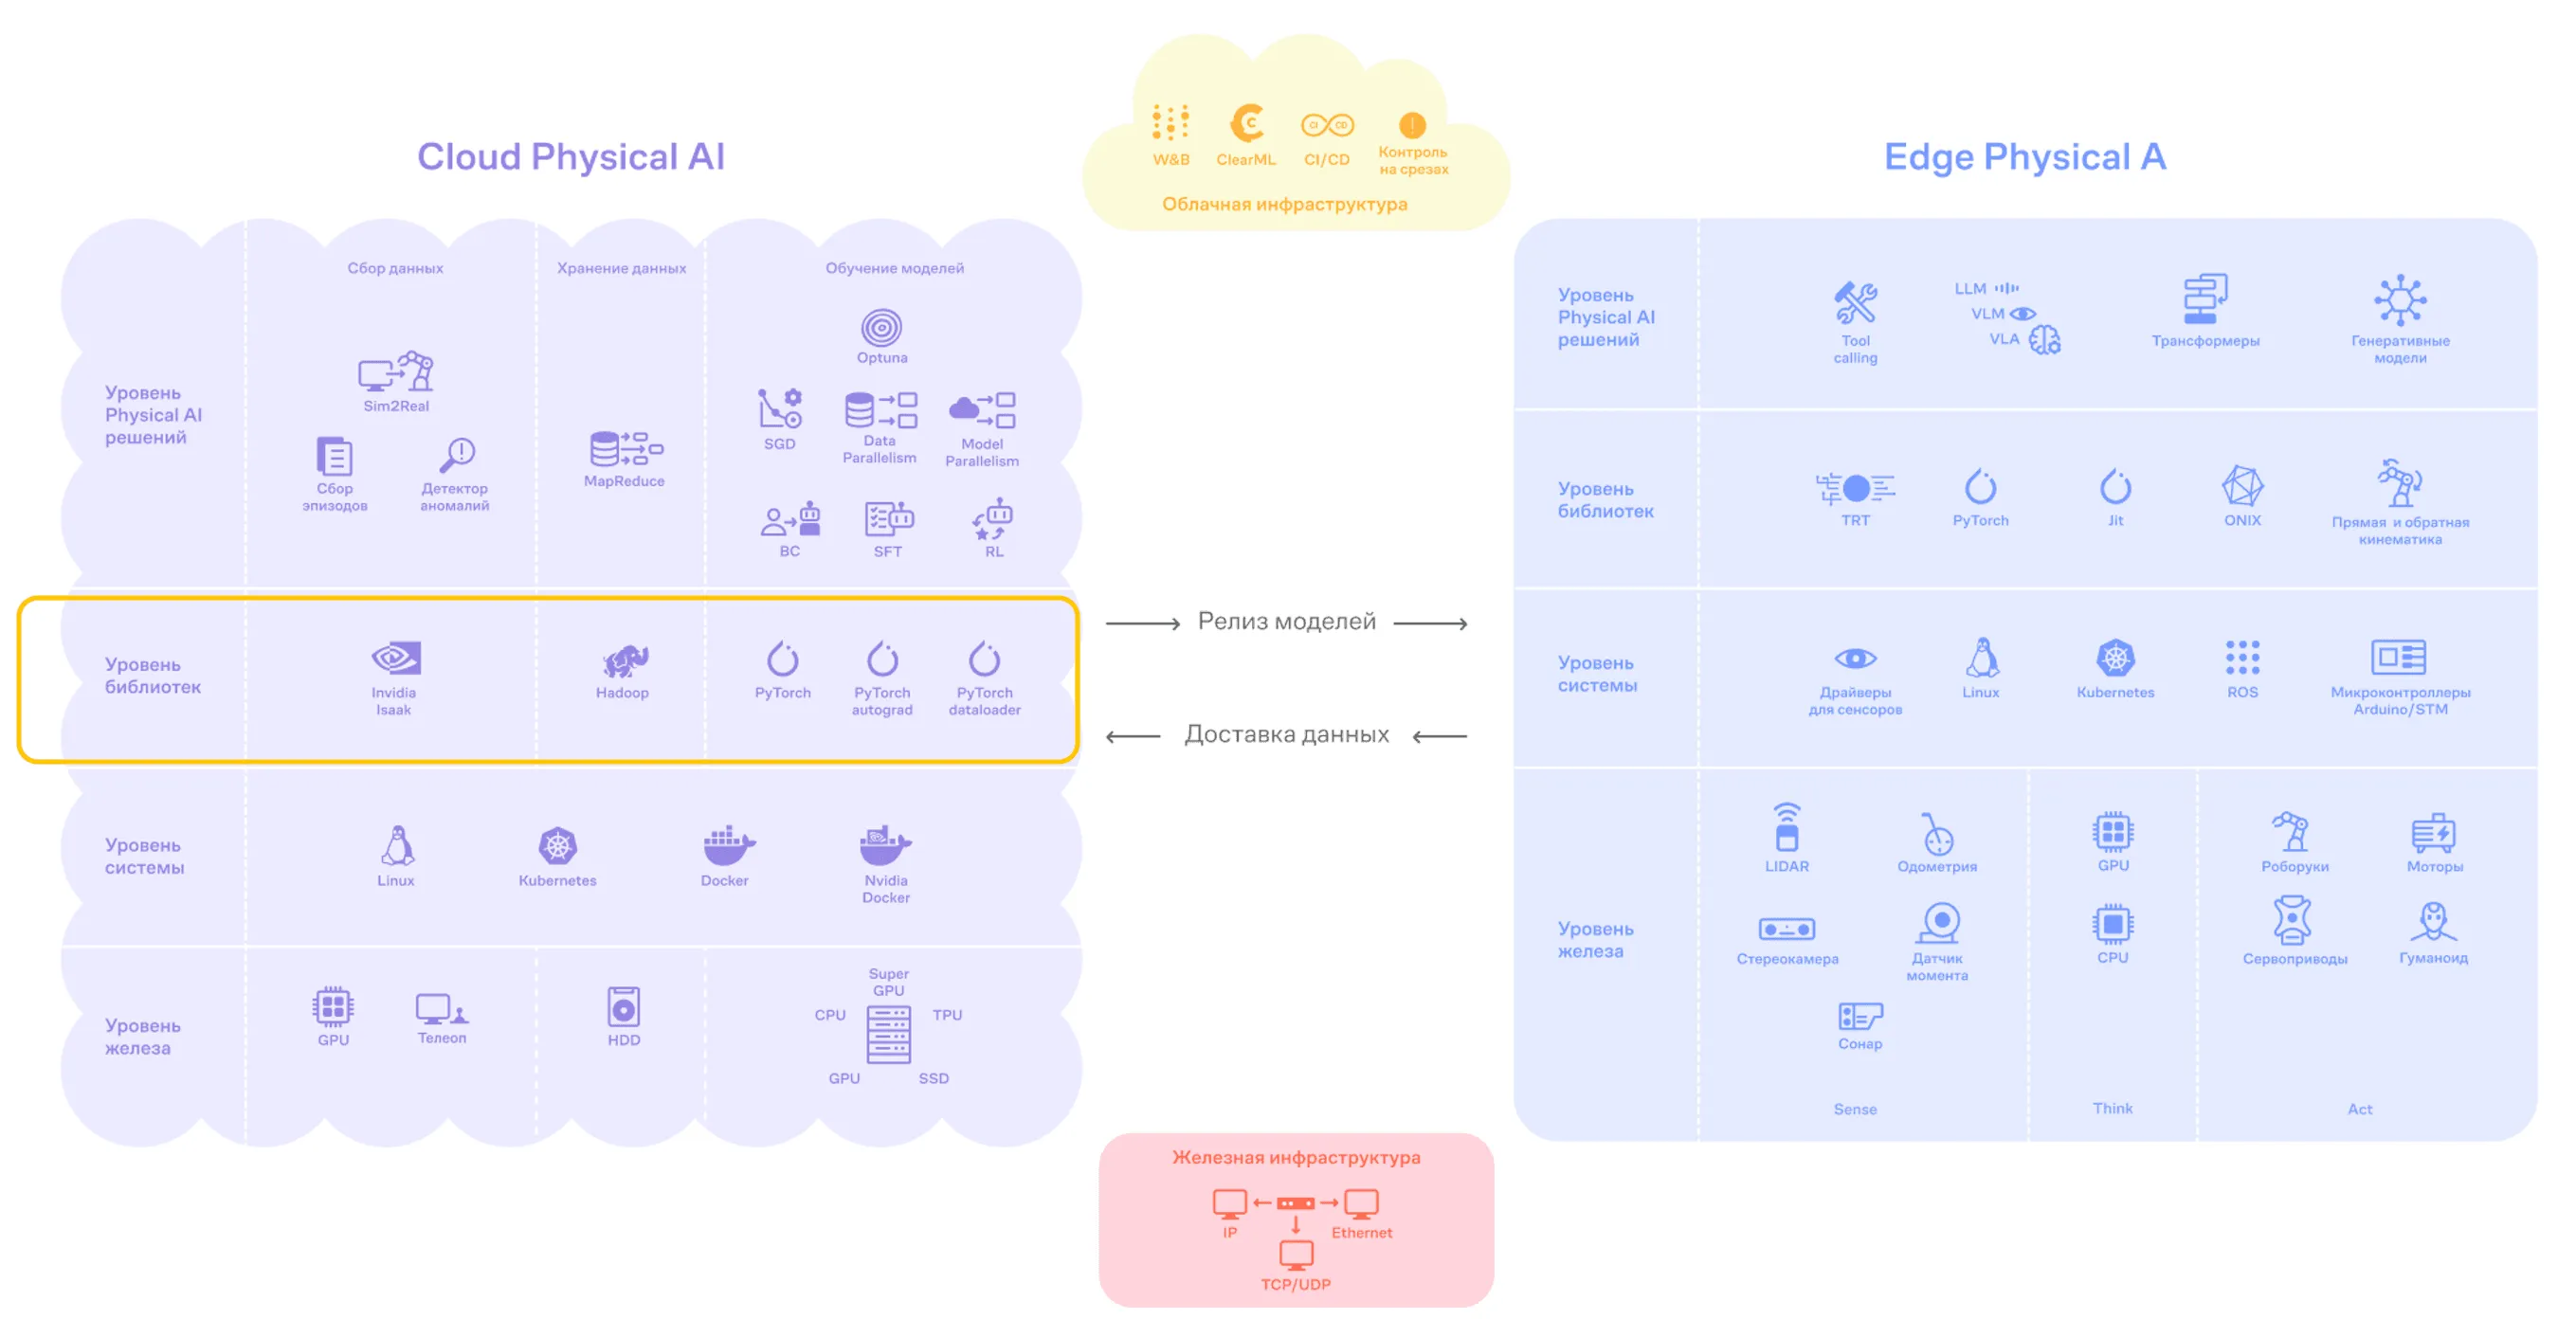
В основании лежит уровень железа — это вычислители и хранилища, например GPU и серверные диски. Над ним — уровень систем. Он связывает железо и программы через операционную систему и контейнеры, например Linux и Docker. Ещё выше — уровень библиотек с инструментами обучения, например PyTorch. На вершине — уровень Physical AI-решений. Это сами методы, по которым учат роботов, например SFT и RL.
Далее мы разберём каждый уровень по отдельности.
Уровень железа
GPU
GPU (Graphics Processing Unit) — это процессор для параллельных вычислений.
GPU содержит тысячи простых ядер, которые одновременно обрабатывают однотипные операции. Примеры таких операций — умножение и сложение матриц, рендеринг, попиксельная обработка изображений.
Исторически GPU применяли для обработки графики. Сегодня GPU используют для глубокого обучения нейросетей, симуляции физических процессов и анализа больших данных. Для программирования GPU есть специализированные API, например CUDA от NVIDIA, кроссплатформенный OpenCL, Metal от Apple, а также DirectX и Vulkan для графики.
В Physical AI GPU используют повсеместно — для обучения и инференса VLA-моделей и для запуска симуляции. При этом GPU для обучения и для инференса отличаются. Инференс идёт на устройстве, например на NVIDIA RTX 5090. В облаке для обучения берут более мощные GPU, например B200 или H200.
Интересный факт
Первую GPU, NVIDIA GeForce 256, представили в 1999 году.
Сегодня топовые модели содержат больше 22 000 ядер CUDA, например NVIDIA RTX 5090, и потребляют свыше 600 Вт. Для сравнения, человеческий мозг потребляет всего 20–25 Вт.
Также из интересного: B200 — это не один кристалл, а два, соединённых в одну видеокарту. Раньше NVIDIA делала ускоритель для дата-центров из единого кремниевого кристалла. Но Blackwell упёрлась в физический предел размера кристалла, и инженеры соединили два кристалла сверхбыстрой шиной. Для программ они выглядят как одна карта на 208 миллиардов транзисторов.
Практика. GPU программируют через CUDA. Типичный рабочий цикл простой. Сначала данные загружают в видеопамять. Потом запускают вычисления на тысячах ядер. В конце результат выгружают обратно. Для старта подойдут официальные ресурсы NVIDIA с документацией по CUDA — ссылки ниже.
Изучить подробнее:
-
Ресурсы NVIDIA — официальные ресурсы NVIDIA и документация по CUDA
-
CUDA Programming Guide — руководство по программированию на CUDA
-
Курсы NVIDIA — курсы NVIDIA DLI по ускоренным вычислениям и CUDA
-
An Even Easier Introduction to CUDA — пошаговый разбор на простом примере: сложение двух массивов, работа с общей памятью и оптимизация доступа к памяти.
TPU и специализированные ИИ‑ускорители
Для обучения современных моделей Physical AI нужны операции линейной алгебры. Например, сложение и умножение матриц или свёртки.
Под такие операции инженеры придумали отдельный класс «железа» — ИИ-ускорители. Самый известный из них — Tensor Processing Unit, или TPU. Его создала компания Google.
По устройству TPU похож на GPU, но его архитектура заточена под матричные вычисления и под пониженную точность, например формат bfloat16. Это ускоряет обучение и снижает энергопотребление.
Кроме TPU есть и другие ускорители — например, AWS Trainium, Huawei Ascend и Graphcore IPU. На таком железе обучают крупнейшие модели. Google тренирует Gemini на кластерах из тысяч TPU-чипов. Anthropic обучает модели Claude на чипах AWS Trainium.
Интересный факт
Google задумалась о собственном ИИ-чипе ещё в 2006 году, но всерьёз взялась за него только в 2013 году.
Инженеры посчитали, что растущая нагрузка от нейросетей скоро заставит компанию удвоить число дата-центров. Чтобы этого избежать, они и построили первый TPU.
Результат превзошёл ожидания: на инференсе первый TPU оказался в 15–30 раз быстрее GPU того времени и в 30–80 раз энергоэффективнее в пересчёте на ватт (Jouppi et al., ISCA 2017).
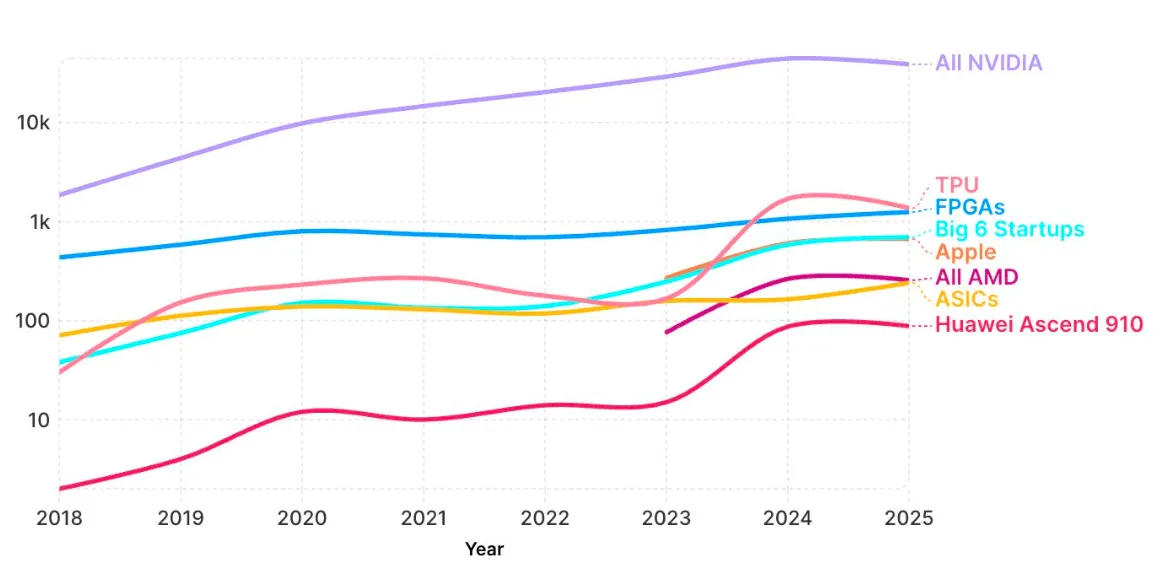
Ниже мы представили график упоминаний в научных работах различных вычислителей. Он показывает, что в последнее время чаще начинают упоминаться не NVIDIA вычислители.
Практика. Проще всего попробовать TPU в Google Colab — там его можно бесплатно выбрать как ускоритель. Для серьёзного обучения берут Google Cloud TPU. В коде TPU подключают через JAX или через PyTorch/XLA. У AWS Trainium своя экосистема — SDK AWS Neuron.
Изучить подробнее:
-
Jouppi et al., «In-Datacenter Performance Analysis of a Tensor Processing Unit» (ISCA 2017) — основополагающая статья про первый TPU
-
An in-depth look at Google's first TPU — разбор архитектуры в блоге Google Cloud простым языком
-
cloud.google.com/tpu/docs — официальная документация Google Cloud TPU
-
aws.amazon.com/ai/machine-learning/trainium — страница AWS Trainium и ссылки на SDK AWS Neuron
Super GPU
Super GPU — это высокопроизводительный вычислительный узел на базе одного или нескольких серверных GPU.
Его задача — обучать большие модели искусственного интеллекта. Обычно такие системы строят на ускорителях уровня NVIDIA B200 или H200. Они выдают до 9000 TFLOPS за счёт специализированных Tensor Core и поддержки форматов с низкой точностью, например FP16, BF16 и FP4, FP8.
В отличие от обычных GPU в рабочих станциях, Super GPU ставят в серверные узлы или в специализированные системы вроде NVIDIA DGX (это AI-сервер).
Внутри стоят 8 GPU, например H100 или B200. Их соединяет интерконнект NVLink/NVSwitch, а узлы между собой связывает сеть InfiniBand на 200–400 Гбит/с. В инфраструктуре Cloud Physical AI такие узлы обучают большие модели VLA и LLM, а также считают симуляции робототехнических сценариев.
Интересный факт
Главная сложность Super GPU — не сами вычисления, а пересылка данных между GPU картами.
Поэтому в NVIDIA DGX B200 восемь GPU соединяет NVLink пятого поколения с суммарной пропускной способностью около 14,4 ТБ/с.
Это на порядок быстрее обычной шины PCIe. Именно такая связь позволяет восьми картам работать как одна большая.
Практика. Обучение на Super GPU сложнее, чем на обычном GPU. Главная причина — масштабирование. Нужно решить, как передавать данные и модель между различными GPU. Подробнее — в разделах Data Parallelism и Model Parallelism.
Изучить подробнее:
-
NVIDIA DGX Platform — официальная страница про серверы DGX.
-
DGX B200 User Guide — характеристики и устройство современного AI-сервера.
CPU
CPU (Central Processing Unit) — это основной вычислитель в компьютерах.
В Cloud Physical AI его роль вспомогательная, но незаменимая. Основную нагрузку при обучении нейросетей берут на себя GPU и TPU, а CPU готовит и предобрабатывает данные.
Он управляет процессом обучения и логирует метрики. Ещё CPU сохраняет чекпоинты модели и работает с хранилищами, например с SSD и HDD.
Для этого применяют серверные многоядерные процессоры с высокой пропускной способностью памяти, например AMD EPYC или Intel Xeon. Число ядер и скорость памяти напрямую влияют на то, как быстро CPU «кормит» данными GPU.
Интересный факт
Вспомогательный CPU иногда становится узким местом всей системы.
В обучении на основе RL нужен огромный параллелизм, например десятки тысяч одновременно работающих сред. CPU не успевает их обсчитывать, поэтому разработчики переносят даже предобработку данных на GPU.
Практика. Если во время обучения GPU простаивает, проверьте загрузку CPU — часто он не успевает готовить данные. Помогает увеличение числа воркеров в загрузчике данных PyTorch.
Изучить подробнее:
-
Документация PyTorch: torch.utils.data — официальное описание
DataLoader. Параметрnum_workersвключает многопроцессную загрузку данных и распараллеливает её между несколькими рабочими процессами -
NVIDIA DALI — библиотека для ускорения пайплайна данных. Решает проблему узкого места на CPU, перенося предобработку данных на GPU
-
Простые способы ускорения обучения PyTorch-моделей (Habr) — разбор практических приёмов. Аугментацию и трансформацию данных легко вынести в параллельные процессы через параметр
num_workers
SSD
SSD (Solid-State Drive) — это твердотельный накопитель, который хранит данные на микросхемах флэш-памяти без механических частей.
В Cloud Physical AI SSD используют там, где скорость доступа к данным критична.
Первое применение — хранение активных датасетов, которые загружаются в память GPU во время обучения. Это так называемый «горячий» слой хранения. Если загрузка батча тормозит, GPU простаивает — это прямые потери в скорости обучения. Поэтому SSD ставят непосредственно в обучающий сервер.
Второе применение — хранение промежуточных результатов: чекпоинтов и логов инструмента логирования, а также визуализации TensorBoard. Скорость последовательного чтения у топовых SSD достигает 7 000 МБ/с против ~200 МБ/с у HDD. Объём SSD в типичном обучающем сервере составляет от нескольких до десятков ТБ.
Интересный факт
Несмотря на высокую скорость, SSD не вытеснили HDD в дата-центрах — они работают в паре.
HDD хранит «холодные» данные дёшево (цена за ТБ у HDD в 5–10 раз ниже), а SSD отвечает только за «горячий» слой, который активно используется «прямо сейчас».
Практика. При настройке обучающего пайплайна убедитесь, что датасет лежит на SSD, а не на сетевом хранилище — это один из самых простых способов устранить узкое место в обучении на GPU. Проверить, где узкое место, можно через nvidia-smi dmon и iostat.
Изучить подробнее:
- PyTorch DataLoader performance tips — как I/O влияет на скорость обучения
HDD
HDD (Hard Disk Drive) — это жёсткий диск с механическими вращающимися пластинами.
Скорость чтения значительно ниже SSD, однако как вы уже знаете, стоимость хранения одного гигабайта у HDD в 5–10 раз меньше. В Cloud Physical AI HDD применяют для «холодного» хранения — то есть для архивных датасетов, которые не используются в текущей итерации обучения.
Например, стандартный датасет Open X-Embodiment весит около 9 ТБ — постоянно держать такой объём на быстрых SSD экономически нецелесообразно.
Типичная архитектура хранения строится по принципу иерархии: «горячие» данные (текущий датасет) — на SSD, «тёплые» и «холодные» (архивы прошлых сборов, резервные копии весов) — на HDD или объектных хранилищах типа S3.
Для работы с большими объёмами на HDD используют системы распределённого хранения с поддержкой модели распределённых вычислений MapReduce, например Hadoop HDFS. Они позволяют распараллеливать чтение данных и ускорять предобработку перед обучением.
Интересный факт
HDD существуют с 1956 года — первый диск IBM 350 весил около тонны и хранил всего 5 МБ. Сегодня один диск на 20 ТБ весит около 700 граммов.
То есть за 70 лет плотность хранения выросла примерно в 5.5 миллиарда раз.
Практика. Для архивного хранения датасетов настраивают систему распределенного хранения Hadoop HDFS или подключают объектное хранилище, например AWS S3. Данные из «холодного» слоя перед обучением перемещают на «горячий» SSD с помощью скриптов предобработки.
Изучить подробнее:
-
Hadoop HDFS — официальная документация по распределённому хранилищу
-
AWS S3 — объектное хранилище для архивных данных
Телеоп
Телеоп (teleoperation) — технология дистанционного управления роботом человеком в реальном времени.
Оператор управляет роботом через устройства ввода: клавиатуру, джойстик, VR-контроллер, шлем виртуальной реальности или экзоскелет. Робот повторяет его движения и передаёт обратно видео и сенсорную информацию.
В Physical AI телеоп используется прежде всего для сбора обучающих данных: AI-тренер вручную выполняет действия роботом, а система записывает эпизоды взаимодействия — траектории движений, изображения с камер и состояние актуаторов. Из этих эпизодов потом учатся VLA-модели методом Behavioural Cloning.
Хрестоматийный пример — проект ALOHA (Stanford, 2023), про который мы говорили в одном из предыдущих параграфов: двурукий робот управляется через пару ведущих манипуляторов-«марионеток», оператор физически двигает ими руками, а робот повторяет движения.
Компания Physical Intelligence пошла дальше — операторы надевают экзоскелет и записывают тысячи демонстраций сложных манипуляций. Так собираются датасеты масштаба Open X-Embodiment (эпизоды с десятков платформ по всему миру), которые затем используются для предобучения генералистских моделей, например π0.
Интересный факт
Для обучения ALOHA жарить креветок и затягивать пластиковые стяжки хватило всего 50 демонстраций — при том, что сама установка обошлась примерно в $20 000, что на порядок дешевле промышленных аналогов.
Практика. Для быстрого старта используют LeRobot (Hugging Face) — готовые скрипты для сбора эпизодов через геймпад или 3D-манипулятор SpaceMouse.
Изучить подробнее:
-
LeRobot (Hugging Face) — библиотека для сбора данных и обучения моделей на реальных роботах
-
π0 blog (Physical Intelligence) — как телеоп-данные используются для обучения генералистской модели
Уровень системы
Linux
Linux — это открытая операционная система, построенная на ядре Линуса Торвальдса в 1991 году.
В отличие от Windows и macOS, Linux бесплатен, имеет богатую экосистему open-source инструментов и удобную командную строку. Именно поэтому большинство ML-разработчиков выбирают его для серверной работы.
Linux управляет ресурсами CPU, памяти и GPU и распределяет их между процессами. Также Linux обеспечивает совместимость с CUDA, Docker и инструментами обучения моделей.
В Cloud Physical AI Linux — это стандартная ОС для обучения моделей: он поддерживает PyTorch, TensorFlow и Python — главный язык программирования в Physical AI. Стандартный дистрибутив для продакшн-обучения — Ubuntu 22.04 LTS.
Интересный факт
Если сложить все дистрибутивы Linux, например Ubuntu, Debian и Fedora, то на нём работает около 57% профессиональных разработчиков. Это даже больше, чем доля Windows в 47,6% (источник). А на пользовательских десктопах Linux почти не встречается — его доля всего около 3 - 4% (источник). Получается, Linux выбирают те, кто делает инструменты, а не те, кто ими пользуется.
Практика. Установить Ubuntu 22.04 LTS, настроить NVIDIA-драйверы (sudo apt install nvidia-driver-535) и проверить GPU командой nvidia-smi.
Изучить подробнее:
-
ubuntu.com — официальный сайт Ubuntu
-
Яндекс Хендбук: Linux — введение в философию Linux и командную строку на русском с практическими задачами и автопроверкой
-
Stepik: Введение в Linux — бесплатный курс без предварительных знаний
-
Stepik: Linux — администрирование — Bash — системное администрирование и кибербезопасность
Docker
Docker — это платформа контейнеризации, которая упаковывает приложение вместе со всеми его зависимостями в изолированный контейнер.
Контейнер запустится одинаково на любой машине: на ноутбуке разработчика, на сервере или в облаке — без классической проблемы «у меня работает, а у тебя нет». Это особенно важно в ML-командах, где разные разработчики могут иметь разные версии Python или CUDA: Docker фиксирует окружение раз и навсегда.
Более того, на одной облачной машине можно запускать несколько изолированных контейнеров одновременно. Например, один разработчик обучает модель, другой параллельно запускает симуляцию, третий — инференс и тестирование — и они не мешают друг другу.
В отличие от виртуальных машин, Docker не эмулирует отдельное ядро ОС, а использует ядро хоста. Поэтому контейнер стартует за 1–2 секунды против 30–60 секунд у VM, занимает десятки МБ вместо нескольких ГБ и потребляет значительно меньше RAM.
Интересный факт
Docker появился в 2013 году как внутренний инструмент компании dotCloud.
За первые сутки после публичного анонса репозиторий собрал тысячи звёзд на GitHub, и компания полностью сменила направление бизнеса — переименовалась в Docker Inc. и сосредоточилась на развитии платформы.
Практика. Разработчик пишет Dockerfile — текстовый файл, описывающий, как собирать образ: какой базовый образ взять, какие пакеты установить.
Например: FROM pytorch/pytorch:2.2.0-cuda12.1-cudnn8-runtime, затем зависимости через pip install — и образ готов. Запускается командой docker build + docker run. Для GPU-ускорения нужен NVIDIA Container Toolkit.
Для запуска нескольких докеров вместе используют Docker Compose. Для этого редактируют файл docker-compose.yml, в котором прописаны конфигурации запуска докеров.
Изучить подробнее:
-
Яндекс Практикум — «Что такое Docker» — статья-введение на русском
-
Stepik — «Docker для начинающих» — практические задания прямо в браузере
-
Официальная документация Docker — справочник и туториалы
Nvidia Docker
Nvidia Docker (NVIDIA Container Toolkit) — это расширение Docker, которое позволяет контейнерам получить доступ к GPU хоста.
Без него контейнер «не видит» видеокарту, так как драйверы и CUDA остаются снаружи изолированной среды. С ним достаточно добавить флаг --gpus all при запуске контейнера — и внутри будет полный доступ к GPU, как будто код работает напрямую на машине.
В Physical AI это критично: контейнер с обучением модели или симуляцией должен использовать GPU, иначе всё обучение упадёт на CPU и замедлится в десятки раз.
Интересный факт
NVIDIA поддерживает открытый реестр готовых контейнеров — NGC (NVIDIA GPU Cloud).
Там лежат оптимизированные образы с предустановленными CUDA, PyTorch, TensorRT и другими библиотеками. Разработчику не нужно собирать окружение с нуля: достаточно взять подходящий образ и запустить его с флагом --gpus all.
Практика. Установить nvidia-container-toolkit через apt по официальной инструкции, после чего запускать контейнеры с флагом --gpus all или прописать GPU-доступ в docker-compose.yml.
Изучить подробнее:
-
NGC (NVIDIA GPU Cloud) — официальный реестр NVIDIA с оптимизированными контейнерами для обучения и инференса
-
Официальная документация — инструкция по установке и настройке
Kubernetes
Kubernetes (K8s) — система оркестрации контейнеров с открытым исходным кодом, разработанная Google и переданная в некоммерческий фонд CNCF в 2015 году.
Если Docker — это «коробка» для одного приложения, то Kubernetes — это диспетчер, который управляет тысячами таких коробок одновременно: следит за их здоровьем, перезапускает упавшие, балансирует нагрузку и масштабирует под трафик.
В Physical AI Kubernetes используется в Cloud-части: он оркестрирует задачи по обучению моделей, управляет воркерами для распределённого обучения (Data Parallelism, Model Parallelism), обеспечивает изоляцию GPU-задач и позволяет запускать множество параллельных обучений одновременно — например, для проведения экспериментов по подбору гиперпараметров через Optuna или сравнения различных архитектур моделей.
Интересный факт
Kubernetes — это транслитерация греческого слова «κυβερνήτης», которое означает «кормчий» или «рулевой». Отсюда же произошло слово «кибернетика».
Сокращение K8s появилось потому, что между «K» и «s» ровно восемь букв.
Практика. Для запуска GPU-задач в K8s нужен NVIDIA GPU Operator — он автоматически устанавливает драйверы и device plugin. Для распределённого обучения PyTorch-моделей используют Kubeflow Training Operator с ресурсом PyTorchJob.
Изучить подробнее:
-
kubernetes.io — официальный сайт
-
Интерактивный туториал прямо в браузере — kubernetes.io/docs/tutorials
-
Kubeflow для ML-задач — оркестрация ML-пайплайнов поверх K8s
Уровень библиотек
PyTorch
PyTorch — открытая библиотека машинного обучения, написанная на Python и C++.
PyTorch стала де-факто стандартом для исследований в области глубокого обучения и обучения Physical AI моделей. К 2023 году доля PyTorch среди новых ML-репозиториев на Papers With Code достигла ~70%, тогда как TensorFlow упал до ~4% (источник).
Библиотека предоставляет два ключевых компонента: инструменты для работы с тензорами на GPU и механизм автоматического дифференцирования. Поверх этих примитивов строятся нейронные сети любой сложности — от простого перцептрона до VLA-моделей типа π0.
Интересный факт
Ключевую часть PyTorch — модуль автоматического дифференцирования — написал Адам Пашке, студент Варшавского университета (факультет математики, информатики и механики, MIMUW), пришедший на стажировку в компанию по разработке ИИ, где проект вёл Сумит Чинтала, сооснователь и идейный лидер PyTorch.
То есть один из самых влиятельных ML-фреймворков в истории начался как учебная задача.
Практика. Установка: pip install torch torchvision torchaudio. Чтобы увидеть, как работает PyTorch, можно попросить кодинг-агента:
«Напиши простую нейросеть на PyTorch, которая учится аппроксимировать функцию sin(x). Покажи граф обучения и финальные предсказания. Также покажи код и объясни его»
ИИ сгенерирует рабочий код и запустит его.
Изучить подробнее:
-
pytorch.org — официальный сайт
-
pytorch.org/tutorials — официальные туториалы
-
Книга: Deep Learning with PyTorch — Eli Stevens et al.
PyTorch Autograd
PyTorch Autograd — это движок автоматического дифференцирования в PyTorch.
Он отслеживает все операции над тензорами в процессе прямого прохода и автоматически вычисляет градиенты при вызове .backward(). О том, что такое прямой проход, производные и градиент можно почитать в параграфе хендбука по математике для ML. Именно информацию о градиентах использует алгоритм обратного распространения ошибки при обучении нейросетей (см. [параграф] https://education.yandex.ru/handbook/math/article/gradientnie-metodi ).
Когда вы работаете с тензорами, PyTorch начинает строить граф вычислений (англ. computation graph) — направленный ациклический граф, где узлы — это операции, а рёбра — тензоры. При вызове метода .backward() Autograd идёт по этому графу в обратном направлении и применяет цепное правило дифференцирования.
Интересный факт
В отличие от TensorFlow 1.x, который строил статический граф до запуска, Autograd строит граф динамически — прямо во время выполнения кода.
Практика. Чтобы разобраться с Autograd, можно попросить кодинг-агента объяснить, как именно вычисляются градиенты для простой модели, и попробовать запустить пример самостоятельно. Подробный туториал с примерами на официальном сайте.
Изучить подробнее:
-
PyTorch Autograd Explained — YouTube (Elliot Waite) — визуальное объяснение графа вычислений
-
https://education.yandex.ru/handbook/math - хендбук по математике от Яндекса
PyTorch DataLoader
PyTorch DataLoader — это модуль для загрузки обучающих данных в модель батчами.
Представьте конвейерную ленту на фабрике: DataLoader непрерывно подаёт порции данных (батчи) в GPU, где потом на GPU происходит обучение. Во время обучения нейросеть потребляет данные итерациями — DataLoader автоматически перемешивает датасет и разбивает его на батчи.
Интересный факт
Узкое место при обучении на H100 нередко не сам GPU, а именно загрузка данных. Параметр num_workers=8–16 (параллельные процессы препроцессинга) и pin_memory=True (прямая выгрузка тензоров в GPU-память, минуя CPU-кеш) способны поднять утилизацию GPU с 60% до 95%+.
Подробнее тут.
Изучить подробнее:
NVIDIA Isaac
NVIDIA Isaac — это открытая платформа для разработки роботов.
Платформа состоит из нескольких ключевых компонентов:
- Isaac Sim — физически точный симулятор для генерации синтетических данных и тестирования.
- Isaac Lab — open-source фреймворк для обучения роботизированных политик (RL и имитационное обучение).
- Isaac ROS — набор CUDA-ускоренных пакетов поверх ROS 2.
- Isaac GR00T — семейство foundation-моделей для гуманоидных роботов.
Boston Dynamics, Fourier, Miso Robotics, Virtual Incision, Wandelbots и другие интегрируют Isaac в свои платформы. Фактически платформа стала индустриальным стандартом для разработки гуманоидов.
Интересный факт
Дженсен Хуанг назвал платформу Isaac в честь двух Айзеков сразу — Ньютона и Азимова.
Ньютон — потому что симулятор работает на законах физики. Азимов — потому что именно он придумал «Три закона робототехники» и сформировал культурный образ безопасного робота-помощника, к которому стремится Physical AI.
Практика. Isaac Sim доступен как контейнер через NVIDIA NGC и на AWS Marketplace. Isaac Lab — open-source на GitHub. GR00T N1 доступен на Hugging Face.
Изучить подробнее:
- Официальная страница Isaac
- Isaac Sim
- Технический блог NVIDIA
- Туториал по обучению своего робота
Hadoop
Apache Hadoop — это open-source-фреймворк для распределённого хранения и обработки больших данных.
Hadoop берёт файл, режет его на блоки по 128 МБ, раскидывает по узлам кластера и обрабатывает все блоки параллельно — вместо последовательного чтения одной машиной.
Он решает две задачи: хранение данных через HDFS (Hadoop Distributed File System), которая разбивает и реплицирует данные, и параллельную обработку этих данных через парадигму MapReduce.
В контексте Physical AI Hadoop важен прежде всего как инструмент предобработки данных перед обучением. Он позволяет запускать массивные трансформации поверх сырых эпизодов: распаковывать сжатые файлы, мёржить таблицы телеметрии, фильтровать битые эпизоды, перешафлить датасет.
Фактически Hadoop — это мост между сырыми данными с роботов и тем, что подаётся непосредственно в обучение.
Интересный факт
Hadoop назван в честь игрушечного слона сына одного из создателей, Дуга Каттинга.
Изучить подробнее:
- hadoop.apache.org — официальная документация и quickstart
- Stepik: Введение в Hadoop — русскоязычный курс по основам
- Яндекс Практикум: Инженер данных — курс включает работу с распределёнными системами
Уровень Physical AI решений
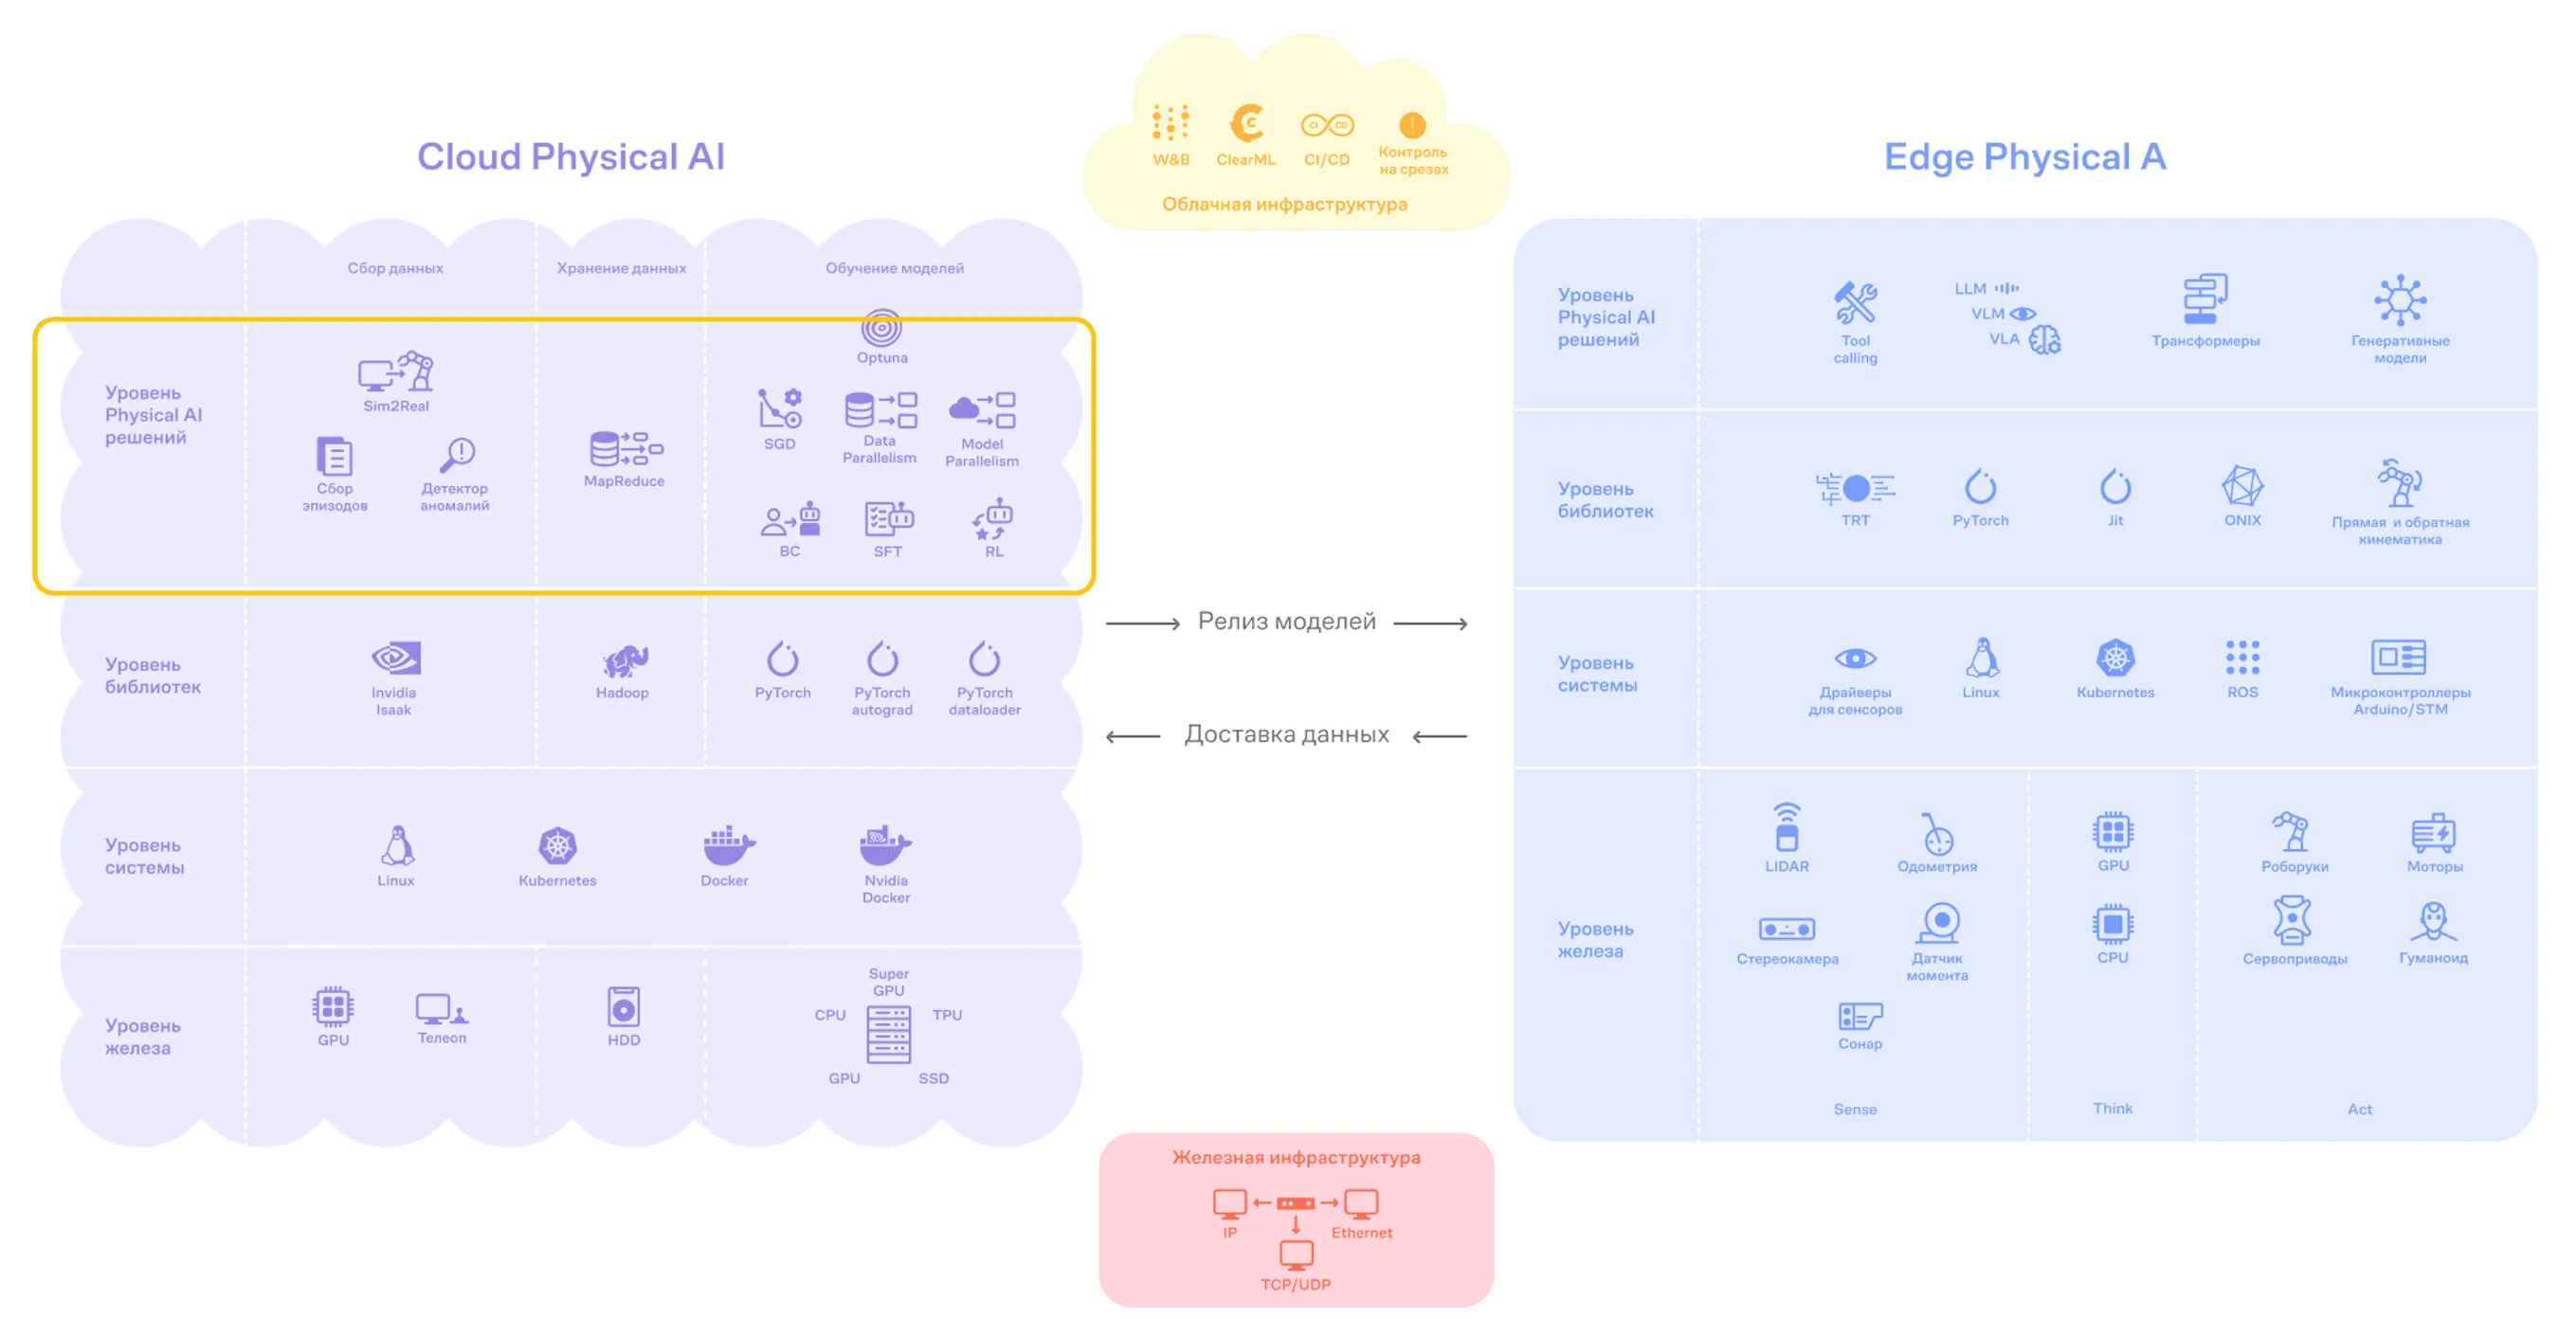
- Sim2Real
- Сбор эпизодов
- Детектор аномалий
- MapReduce
- Optuna (Hyperparameter optimization)
- Data Parallelism
- Model Parallelism
- SGD
- BC
- SFT
- RL
Sim2Real
Sim2Real (Simulation-to-Real) — это подход, при котором модель или политику робота обучают целиком в симуляции, а затем переносят на реального робота без дополнительного дообучения на реальных данных.
Идея проста по замыслу, но сложна в реализации. Физика симулятора всегда приблизительна, и агент может «выучить» артефакты движка, которых нет в реальности. Разницу между поведением в симуляции и в реальном мире называют sim2real gap — разрыв между реальностью и моделью.
Для сокращения sim2real gap или уменьшения его влияния применяют следующие методы:
- domain randomization, рандомизация параметров среды — освещения, массы, трения;
- domain adaptation, адаптация данных из симуляции к реальным данным;
- system identification, получение реальных параметров механизма и перенос их в симуляцию.
Знаковый пример — проект OpenAI Dactyl, где роборуку научили собирать кубик Рубика исключительно в симуляции с domain randomization (OpenAI).
В Physical AI Sim2Real критически важен: собирать данные на реальных роботах дорого и медленно, а симуляция позволяет генерировать миллионы эпизодов за часы. Популярные платформы для Sim2Real — NVIDIA Isaac Sim, которая работает на GPU, поддерживает моделирование нескольких десятков тысяч параллельных сред одновременно и предлагает фотореалистичный рендеринг, а также MuJoCo, PyBullet и Gazebo.
Практика. Главный принцип — не гнаться за идеальным реализмом симулятора, а сделать политику устойчивой к разнообразию условий.
Для этого рандомизируют физические параметры (масса, трение, задержки моторов), визуальные параметры (текстуры, освещение, шум камер) и динамику (случайные внешние силы).
Чтобы проверить на сколько метод переноса работает корректно, разработчики проводят простой тест: воспроизводят один и тот же эпизод в симуляторе и в реальности и смотрят на разницу между ними. В дальнейшем уже на больших данных разработчики используют метрику корреляции между результатами в симуляции и результатами в реальности.
Изучить подробнее:
-
NVIDIA Isaac Sim — платформа для робототехнической симуляции и генерации синтетических данных
-
Lilian Weng — Domain Randomization for Sim2Real Transfer — подробный обзор методов domain randomization с математикой
-
OpenAI — Learning Dexterity — описание проекта Dactyl с деталями подхода
-
AwesomeSim2Real (GitHub) — актуальный каталог статей и ресурсов по Sim2Real
-
Sim2Real: How to Reduce the Reality Gap — обзор методов, метрик и примеров из индустрии
Сбор эпизодов
Сбор эпизодов — это запись демонстрационных данных для обучения Physical AI моделей.
В отличие от классического ML, где достаточно размеченных картинок, здесь записываются синхронизированные потоки с камер, датчиков и положений суставов робота.
Два основных подхода — телеуправление (оператор «показывает» роботу задачу через VR-шлем или leader-follower руки) и генерация в симуляции.
На одну задачу обычно нужно от 50 до 5 000 эпизодов. Масштаб быстро растёт: Open X-Embodiment объединяет более 1 млн траекторий с 22 типов роботов, а NVIDIA с помощью GR00T Blueprint сгенерировала 780 000 синтетических траекторий.
Для сбора эпизодов качество критично, так как рассинхронизация камер и команд даже в 50 мс ухудшает обучение. Данные хранятся в форматах RLDS (TFRecord, стандарт Open X-Embodiment), LeRobot v2 (Parquet плюс MP4, используется GR00T), HDF5 (DROID, RH20T).
Практика. Нужны робот с телеуправлением, синхронизированная запись всех модальностей (RGB, глубина, суставы, усилия) и валидация эпизодов. Для старта подходит open-source-платформа LeRobot — готовый пайплайн от подключения робота до загрузки данных на Hugging Face Hub.
Изучить подробнее:
-
LeRobot (Hugging Face) — open-source-библиотека сбора данных и обучения
-
NVIDIA Isaac GR00T — VLA-модель и инструменты генерации синтетических данных (GR00T-Mimic, GR00T-Dreams)
-
Open X-Embodiment — крупнейший открытый датасет (более 1 млн траекторий, 527 навыков)
-
DROID Dataset — 76 000 эпизодов манипуляций через VR-телеуправление
Детектор аномалий
Детектор аномалий (Anomaly Detection) — это алгоритм, который находит «нештатные» ситуации в данных или поведении робота, обучаясь только на примерах нормальной работы.
Представьте опытного оператора на заводе: он видел тысячи штатных циклов и мгновенно замечает, когда что-то идёт не так, даже если конкретную поломку видит впервые.
Так же работает и детектор: модель запоминает «норму», а всё, что сильно отклоняется, получает высокий рейтинг аномалий (англ. anomaly score).
В Physical AI детектор решает две задачи: контроль качества обучающих данных (отсев битых эпизодов и некачественных траекторий) и мониторинг робота в работе (если ошибка модели резко растёт — робот столкнулся с ситуацией, которой не было при обучении).
Интересный факт
Детекция аномалий изначально массово применялась в банках для поиска мошеннических транзакций — те же самые алгоритмы (Isolation Forest, автоэнкодеры) сейчас ловят сбои роботов.
Изучить подробнее:
-
Phys-AD Dataset (arXiv: 2503.03562) — 6400+ видео физически обоснованных аномалий с роборукой
-
voraus-AD Dataset — открытый бенчмарк для детекции аномалий в робототехнике
-
scikit-learn: Outlier Detection — классические методы (Isolation Forest, One-Class SVM)
MapReduce
MapReduce — это модель распределённой обработки данных, которую придумали инженеры Google Джеффри Дин и Санджай Гемават в 2004 году.
Идея простая: вместо того чтобы тащить терабайты данных к одному мощному серверу, мы отправляем вычисления туда, где данные уже лежат.
Работает в два шага:
- На этапе Map каждый узел кластера обрабатывает свой конкретный кусок данных.
- На этапе Reduce результаты группируются по ключам и агрегируются в итоговый ответ.
Это похоже на перепись населения: каждый переписчик (Map) обходит свой район и записывает данные, а потом центральная комиссия (Reduce) сводит итоги по всей стране.
В Cloud Physical AI MapReduce помогает обрабатывать огромные датасеты для обучения роботов. Например, стандартный робототехнический датасет Open X-Embodiment весит около 9 ТБ — обработать такой объём на одной машине невозможно. MapReduce, реализованный в Hadoop, разбивает эти данные на блоки по 128 МБ и обрабатывает параллельно на тысячах узлов.
При этом система сама перезапускает упавшие задачи, что обеспечивает отказоустойчивость. В Яндексе используют собственную платформу YTsaurus (ранее YT — Yandex Tables). YTsaurus развёрнута на десятках тысяч серверов и обрабатывает эксабайты данных.
Практика. MapReduce работает в связке с HDFS — распределённой файловой системой Hadoop.
Разработчик описывает две функции: Map (преобразование входных данных в пары «ключ–значение») и Reduce (агрегация по ключам). Всю работу по распределению задач, балансировке нагрузки и обработке сбоев берёт на себя фреймворк. Писать MapReduce-задачи можно на Java, Python или C++.
Изучить подробнее:
-
Оригинальная статья Dean & Ghemawat (2004) — фундаментальная работа, с которой всё началось
-
Hadoop MapReduce Tutorial (Apache) — официальный туториал с примерами кода
-
Курс «Hadoop. Система для обработки больших объёмов данных» (Stepik) — бесплатный курс на русском, включая раздел по MapReduce
-
Работа с заданиями MapReduce (Yandex Cloud) — практическое руководство на русском
-
Документация YTsaurus (GitHub) — исходный код и документация
Optuna (Оптимизация гиперпараметров)
Гиперпараметры — это настройки модели, которые инженер задаёт до начала обучения. Например, learning rate, размер батча или количество слоёв в нейросети. Модель не может подобрать их сама.
Наивный подход — перебрать все комбинации (grid search) — работает слишком медленно. Optuna решает эту задачу умнее: она использует байесовскую оптимизацию (алгоритм TPE), которая учится на предыдущих экспериментах и концентрирует поиск в перспективных областях. Подробнее про подбор гиперпараметров можно посмотреть в параграфе https://education.yandex.ru/handbook/ml/article/podbor-giperparametrov .
В Physical AI это особенно критично: одна итерация обучения VLA-модели может занимать несколько недель, и каждый неудачный запуск — это потерянные GPU-часы на дорогих A100/H100. Optuna также умеет досрочно останавливать бесперспективные эксперименты (англ. pruning) и параллелить поиск на несколько GPU-узлов без изменения кода.
Интересный факт
Optuna создана командой Preferred Networks — японской компании, которая специализируется на робототехнике и Physical AI.
Компания разработала Optuna именно для ускорения своих экспериментов с обучением роботов. Статья об Optuna была представлена на KDD 2019 — одной из главных конференций по Data Mining.
Практика. Разработчик описывает на Python целевую функцию и диапазоны гиперпараметров. Optuna запускает серию экспериментов, где каждый следующий запуск учитывает результаты предыдущих. Бесперспективные эксперименты останавливаются досрочно.
Optuna интегрируется с PyTorch, TensorFlow и MLflow.
Изучить подробнее:
-
optuna.org — официальный сайт и документация
-
Optuna Tutorial (Read the Docs) — пошаговое руководство с примерами
-
Habr: Optuna — подбор гиперпараметров — обзор на русском с примерами кода
-
Яндекс Практикум: Optuna — статья на русском с интеграцией MLflow
-
GitHub: optuna/optuna — исходный код и примеры
Data Parallelism
Data Parallelism — это метод распределённого обучения нейронных сетей, при котором одну и ту же модель копируют на несколько GPU, а обучающие данные делят между ними.
Представьте класс из 8 студентов, где каждый решает свою порцию задач из общего учебника, а потом все сверяют ответы и записывают общее решение. Так же работает Data Parallelism: каждый GPU считает градиенты на своей порции батча, затем все GPU усредняют градиенты через операцию AllReduce и одинаково обновляют веса модели.
В результате обучение ускоряется почти линейно с числом GPU. Например, компания разработки ИИ систем Deepset совместно с AWS и NVIDIA добились ускорения в 3,9 раза и сокращения стоимости обучения NLP-моделей в 12,8 раз с помощью PyTorch DDP.
Для очень больших моделей используют FSDP — расширение DDP, которое разбивает между устройствами не только данные, но и сами веса модели, градиенты и состояния оптимизатора.
В Physical AI Data Parallelism критически важен: одна итерация обучения VLA-модели может занимать несколько недель на одном GPU. Распараллеливание на кластер из 8–64 GPU сокращает это время до дней.
Data Parallelism подходит, когда модель помещается в память одного GPU. Если модель слишком большая, применяют Model Parallelism, гибридные подходы или вариации data parallelism, например, FSDP.
Практика. В PyTorch для Data Parallelism есть встроенный модуль DistributedDataParallel.
Он копирует модель на каждый GPU, раздаёт каждому свою порцию данных и синхронизирует градиенты автоматически. Разработчик оборачивает модель в DDP и запускает обучение одной командой torchrun. Устанавливать ничего дополнительно не нужно — всё входит в стандартный PyTorch.
Изучить подробнее:
-
PyTorch DDP Tutorial — официальный туториал с примерами кода
-
PyTorch DDP Series (видео) — пошаговая видеосерия от PyTorch
-
Data Parallelism: From Basics to Advanced (DigitalOcean) — подробный обзор всех подходов к распараллеливанию
-
Distributed Parallel Training (Towards Data Science) — сравнение Data Parallelism и Model Parallelism с примерами на PyTorch
-
LLM scaling week - интенсив от Яндекса про масштабирование обучения
-
YaFSDP - библиотека от Яндекса для масштабирования обучения
Model Parallelism
Model Parallelism — это метод распределённого обучения, при котором саму модель разрезают на части и размещают на нескольких GPU.
Если в Data Parallelism каждый GPU хранит полную копию модели и получает свою порцию данных, то в Model Parallelism каждый GPU хранит только фрагмент модели и обрабатывает все данные сообща.
Это необходимо, когда модель просто не помещается в память одного GPU. Например, GPT-3 с 175 миллиардами параметров занимает около 350 ГБ в формате FP16. На одном V100 обучение такой модели заняло бы примерно 288 лет.
Поэтому NVIDIA обучала GPT-3 на 1024 GPU A100 и уложилась чуть больше чем в месяц. На момент публикации этого параграфа при использовании более современных GPU (H100) время обучения аналогичной модели на таком же кластере сокращается уже до недели.
Существует два основных вида Model Parallelism.
- Tensor Parallelism режет отдельные слои «горизонтально» — матрицу весов одного слоя делят между GPU. Каждый GPU считает свой фрагмент умножения матриц, а затем результаты собирают вместе.
- Pipeline Parallelism режет модель «вертикально» — по слоям. Первый GPU обрабатывает первые слои, второй — следующие, и так далее. Данные идут по цепочке GPU, как детали по конвейеру. В наивной реализации такой подход может приводить к простаиванию GPU. Однако современные подходы обходят этот недостаток, например с помощью микробатчей: пока один GPU передаёт микробатч следующему, он уже берёт в работу новый микробатч.
На практике оба подхода комбинируют между собой и с Data Parallelism — это называют 3D-параллелизм.
Практика. В PyTorch tensor parallelism доступен через модуль torch.distributed.tensor.parallel, а pipeline parallelism — через torch.distributed.pipelining.
Для промышленного обучения больших моделей используют NVIDIA Megatron-LM или Microsoft DeepSpeed, которые реализуют все виды параллелизма «из коробки».
Tensor parallelism лучше всего работает внутри одного сервера, где GPU связаны быстрым NVLink. Pipeline parallelism можно использовать между серверами.
Изучить подробнее:
-
NVIDIA Blog: Scaling Language Model Training to a Trillion Parameters — подробное объяснение всех видов параллелизма от NVIDIA
-
Megatron-LM на GitHub — библиотека NVIDIA для обучения больших моделей
-
PyTorch Distributed Overview — официальный обзор распределённого обучения
-
Colossal-AI: Paradigms of Parallelism — понятное объяснение всех видов параллелизма с диаграммами
-
LLM scaling week - интенсив от Яндекса про масштабирование обучения
SGD
SGD (Stochastic Gradient Descent, Стохастический градиентный спуск) — это базовый алгоритм оптимизации.
Градиентный спуск вычисляет, в какую сторону нужно изменить веса модели, чтобы ошибка уменьшилась. Направление наибольшего увеличения ошибки называют градиентом. Алгоритм делает шаг в сторону, противоположную градиенту, и повторяет это много раз.
Обычный градиентный спуск считает градиент по всему датасету и только потом делает один шаг. SGD поступает иначе: берёт один пример или небольшую группу (мини-батч) и сразу корректирует веса.
Это не только ускоряет обучение на больших данных, но и улучшает сходимость. Шум от случайной выборки помогает модели выбираться из локальных минимумов и седловых точек, в которых обычный градиентный спуск застревает.
В контексте Physical AI градиентный спуск используют при обучении VLA-моделей на серверах с GPU. Идея стохастической аппроксимации восходит к работе Роббинса и Монро 1951 года, а Фрэнк Розенблатт в 1950-х впервые применил SGD для обучения перцептрона — первой нейросети.
Сегодня SGD и его потомки (Adam, AdamW) лежат в основе обучения практически всех глубоких нейросетей.
Практика. Ключевой параметр SGD — learning rate (скорость обучения). Слишком высокий — модель «проскакивает» оптимум и расходится. Слишком низкий — учится неоправданно долго.
Поэтому применяют расписание learning rate: большой шаг в начале, маленький к концу. Часто добавляют momentum — накопление «инерции» обновлений, чтобы не застревать в локальных минимумах. В PyTorch SGD вызывается через torch.optim.SGD с параметрами lr, momentum, weight_decay либо аналоги, например, оптимизатор torch.optim.Adam.
Изучить подробнее:
-
PyTorch SGD — официальная документация — параметры, формулы, примеры
-
Dive into Deep Learning, глава 12.4 — SGD — интерактивный учебник с кодом на PyTorch
-
Яндекс Образование — Градиентные методы — от базового градиентного спуска до SGD и мини-батчей
-
Яндекс Образование — Оптимизация в ML — SGD, momentum, Adam и другие оптимизаторы
BC
BC (Behaviour Cloning) — метод обучения робота на основе подражания за человеком.
Робот наблюдает за действиями эксперта и учится их повторять через обычное обучение с учителем (англ. supervised learning). По сути, BC сводит задачу управления к задаче регрессии: на входе — наблюдения (например, изображения с камер и положения суставов), на выходе — действия эксперта.
В Physical AI BC используют для обучения роботов бытовым действиям. Оператор через телеуправление показывает роботу, как выполнить задачу: например, переложить предмет или налить кофе. Нейросеть запоминает пары «что вижу → что делаю» и потом воспроизводит навык самостоятельно.
Современный пример — алгоритм ACT (Action Chunking with Transformers), который позволяет роботу ALOHA освоить 6 сложных задач всего по 10 минутам демонстраций с точностью 80–90%.
Главная проблема BC — накопление ошибок (англ. compounding errors). Если обученная политика чуть отклоняется от траектории во время работы, робот попадает в ситуации, которых не было в обучающих данных, и ошибки нарастают лавинообразно. Для борьбы с этим используют метод сбора данных на основе перехвата робота, когда робот не справляется (в литературе известен как &DAgger) , а также используют увеличение количества демонстраций.
Интересный факт
Первое успешное применение BC — проект ALVINN Дина Помело в 1989 году. Нейросеть с одним скрытым слоем из 29 нейронов научилась держать машину на дороге, наблюдая за водителем через камеру. Через шесть лет Помело проехал на минивэне из Питтсбурга в Сан-Диего. Это 4 600 км, из них 98% пути рулила программа. Бортовой компьютер был слабее современных Apple Watch.
Практика. Для BC нужны демонстрации эксперта — пары «наблюдение, действие». Нужно собрать 50–200 эпизодов через телеуправление и обучить нейросеть минимизировать ошибку между предсказанным и реальным действием эксперта.
Для робототехнических задач хорошо работает архитектура ACT — она предсказывает сразу последовательность действий, а не одно за раз, что снижает накопление ошибок. Например, можно начать со следующего проекта с недорогим роботом, например, с Low-Cost Robot Arm.
Изучить подробнее:
-
Лекция MIT — Imitation Learning (Russ Tedrake) — подробный разбор BC с математикой и примерами
-
ALOHA: Learning Fine-Grained Bimanual Manipulation — проект BC + ACT для двуруких роботов
-
Implicit Behavioral Cloning (CoRL 2021) — продвинутый подход к BC через энергетические модели
SFT
SFT (Supervised Fine-Tuning) — это метод дообучения предварительно обученной модели на размеченных примерах правильного поведения.
В робототехнике этот же подход часто называют «обучение подражанием» (англ. imitation learning) или «клонирование поведения» (англ. behavioral cloning).
За основу берём foundation model — большую модель, которая уже прошла предварительное обучение на масштабных данных, например GR00T или π0, потом показываем ей пары «вход → правильный выход».
Модель корректирует свои веса, чтобы воспроизводить эти примеры. В контексте Physical AI — записи демонстраций, где AI-тренер через телеоп показывает роботу, как выполнять задачу. ИИ учится на готовых примерах, как человек учится по решённым задачам из учебника.
Именно так работает большинство VLA-моделей на первом этапе обучения. Например, для модели π0 от Physical Intelligence исследователи провели SFT на телеоп-данных.
Другой пример — Mobile ALOHA, где всего 50–200 демонстраций хватило, чтобы робот научился выполнять сложные бытовые задачи. В работе RT–1 авторы сделали важный вывод: разнообразие задач в датасете даёт больший вклад в обобщаемость модели, чем простое увеличение числа примеров для уже освоенных навыков.
Ограничение SFT в том, что модель хорошо работает в ситуациях, похожих на обучающие примеры, но ошибается за их пределами. В последнее время всё больше разработчиков видит пользу в дополнительном этапе на базе RL, что уже стало стандартом в области LLM.
Интересный факт
В работе Open X-Embodiment показали, что данные с совершенно разных роботов улучшают обобщающую способность модели при SFT.
Коллективный датасет из более чем 1 млн эпизодов от 22 разных роботов позволил модели-генералисту с 55 млрд параметров оказаться вдвое успешнее, чем модель с 5 млрд параметров.
Практика. SFT в Physical AI — это прежде всего подготовка качественного датасета демонстраций.
AI-тренер управляет роботом через телеоп и записывает данные с камер и актуаторов. Модель обучают повторять действия тренера в ответ на аналогичные наблюдения. После SFT модель часто дополнительно улучшают через RL, чтобы расширить её способность адаптироваться к новым ситуациям.
Попробовать SFT на практике можно через LeRobot от Hugging Face — фреймворк реализует imitation learning, RL и VLA-модели в PyTorch. Либо можно попробовать SFT в симуляторе: те же принципы, но данные достать проще.
Изучить подробнее:
-
Хабр — Что такое Supervised Fine-Tuning — обзор метода на русском языке
-
π0: Our First Generalist Policy — пример применения SFT для обучения VLA-модели робота
-
Open X-Embodiment (arXiv) — масштабный мультироботный датасет для SFT
-
Self-Improving Embodied Foundation Models (arXiv) — исследование связки SFT + RL для робототехники
-
LeRobot (GitHub) — открытый фреймворк для обучения роботов от Hugging Face с поддержкой SFT и RL
-
LeRobot: Parameter Efficient Fine-Tuning — руководство по дообучению VLA-моделей (SmolVLA) через LoRA
-
GR00T N1 от NVIDIA — открытая VLA-модель на 2B параметров для гуманоидных роботов
RL
RL (Reinforcement Learning, обучение с подкреплением) — метод обучения, при котором модель сама ищет лучшую стратегию поведения методом проб и ошибок.
Агент совершает действия в среде и получает награду за удачные решения. В отличие от SFT, где модель копирует готовые примеры, RL позволяет находить решения, которые эксперт мог бы и не придумать.
В Physical AI RL незаменим для задач локомоушена. Например, в работе «Sim-to-Real: Learning Agile Locomotion For Quadruped Robots» робособака научилась ходить целиком в симуляции, а результат перенёсся в реальность без дообучения.
Политика оказалась на 30% энергоэффективнее инженерного решения. RL также используют как «клей» между компонентами. В работе «UMI on Legs» авторы взяли готовую политику манипуляции и через RL научили мобильную платформу подстраиваться под неё.
На практике RL обычно применяют после SFT: сначала модель учится по демонстрациям, а затем RL помогает ей выйти за рамки примеров и улучшить качество самостоятельно. Однако при разработке VLA RL пока не стал базовым этапом. Скорее всего, это изменится по аналогии с LLM.
Интересный факт
В работе “Learning to Walk in Minutes” исследователи научили робособаку ходить по ровной поверхности за 4 минуты, а по лестницам — за 12 минут.
Ключ к такой скорости — массовый параллелизм: тысячи виртуальных роботов обучаются одновременно на одном GPU через Isaac Gym.
Практика. Главная сложность RL — конструирование функции награды.
Награда должна поощрять нужное поведение и штрафовать за опасные действия. Самый популярный алгоритм для робототехники — PPO. Обучение обычно проводят в симуляции на тысячах параллельных окружений, а затем переносят политику на реального робота (Sim2Real).
Для освоения RL с нуля хорошо подходит бесплатный курс Spinning Up от OpenAI — он включает теорию, готовые реализации PPO и SAC, а также упражнения.
Изучить подробнее:
-
Как работает Reinforcement Learning — вводная статья на русском
-
Хабр — Как мы учим роботов ходить плавно (Яндекс) — практический пример RL + PPO для робособак
-
Spinning Up (OpenAI) — бесплатный курс по RL с реализациями PPO, SAC и других алгоритмов
-
Sim-to-Real: Learning Agile Locomotion (arXiv) — знаковая работа по переносу RL-политики из симуляции на реального робота
-
Learning to Walk in Minutes (arXiv) — рецепт обучения локомоушена за минуты на одном GPU
В следующем параграфе подробнее расскажем про компоненты в подсистеме Edge Physical AI.