

В предыдущей главе мы дали определение Physical AI, посмотрели на предпосылки появления области, а также разобрали ряд ключевых работ.
В этой мы посмотрим, как принципы, заложенные в определение Physical AI, превращаются в рабочую систему. Но перед этим разберёмся, как выглядит архитектура классического решения по управлению роботом, взглянем на её плюсы и минусы. Вы сами поймёте, откуда взялись важные элементы архитектуры в Physical AI.
Давайте в этом параграфе познакомимся с классическим пайплайном управления роботом — способом декомпозиции кода управления роботом на модули, который был широко принят до появления Physical AI. Мы посмотрим на основные модули пайплайна, какие вариации он допускает, а также про другие потребности в разработке.
Надеемся, вы помните определение пайплайна, которые мы ввели в параграфе 2.4. Этим термином называют цепочку модулей, по которым движутся данные и которые в совокупности решают поставленную задачу. В случае с пайплайном робота основная задача — управление актуаторами: опираясь на данные сенсоров, сгенерировать набор команд для выполнения полезного действия.
Эта формулировка естественным образом транслируется в разработку пайплайна. При этом формулировка не ограничивает нас в выборе технологий. Поэтому уместно говорить о пайплайне как с использованием технологий Physical AI, так и без них.
Теперь пришло время взглянуть на нашу систему целиком перед тем, как погрузиться в детали.
Модули классического пайплайна
Ниже приведена схема с основными модулями пайплайна и их связями. Это расширенная версия из параграфа 2.4. Блоки на схеме представляют собой программные модули пайплайна, стрелки между блоками отражают потоки информации.
Данные обычно перемещаются не в виде абстрактных байтов, а запакованы в осмысленные структуры. Как раз они и показаны над стрелками между модулями.
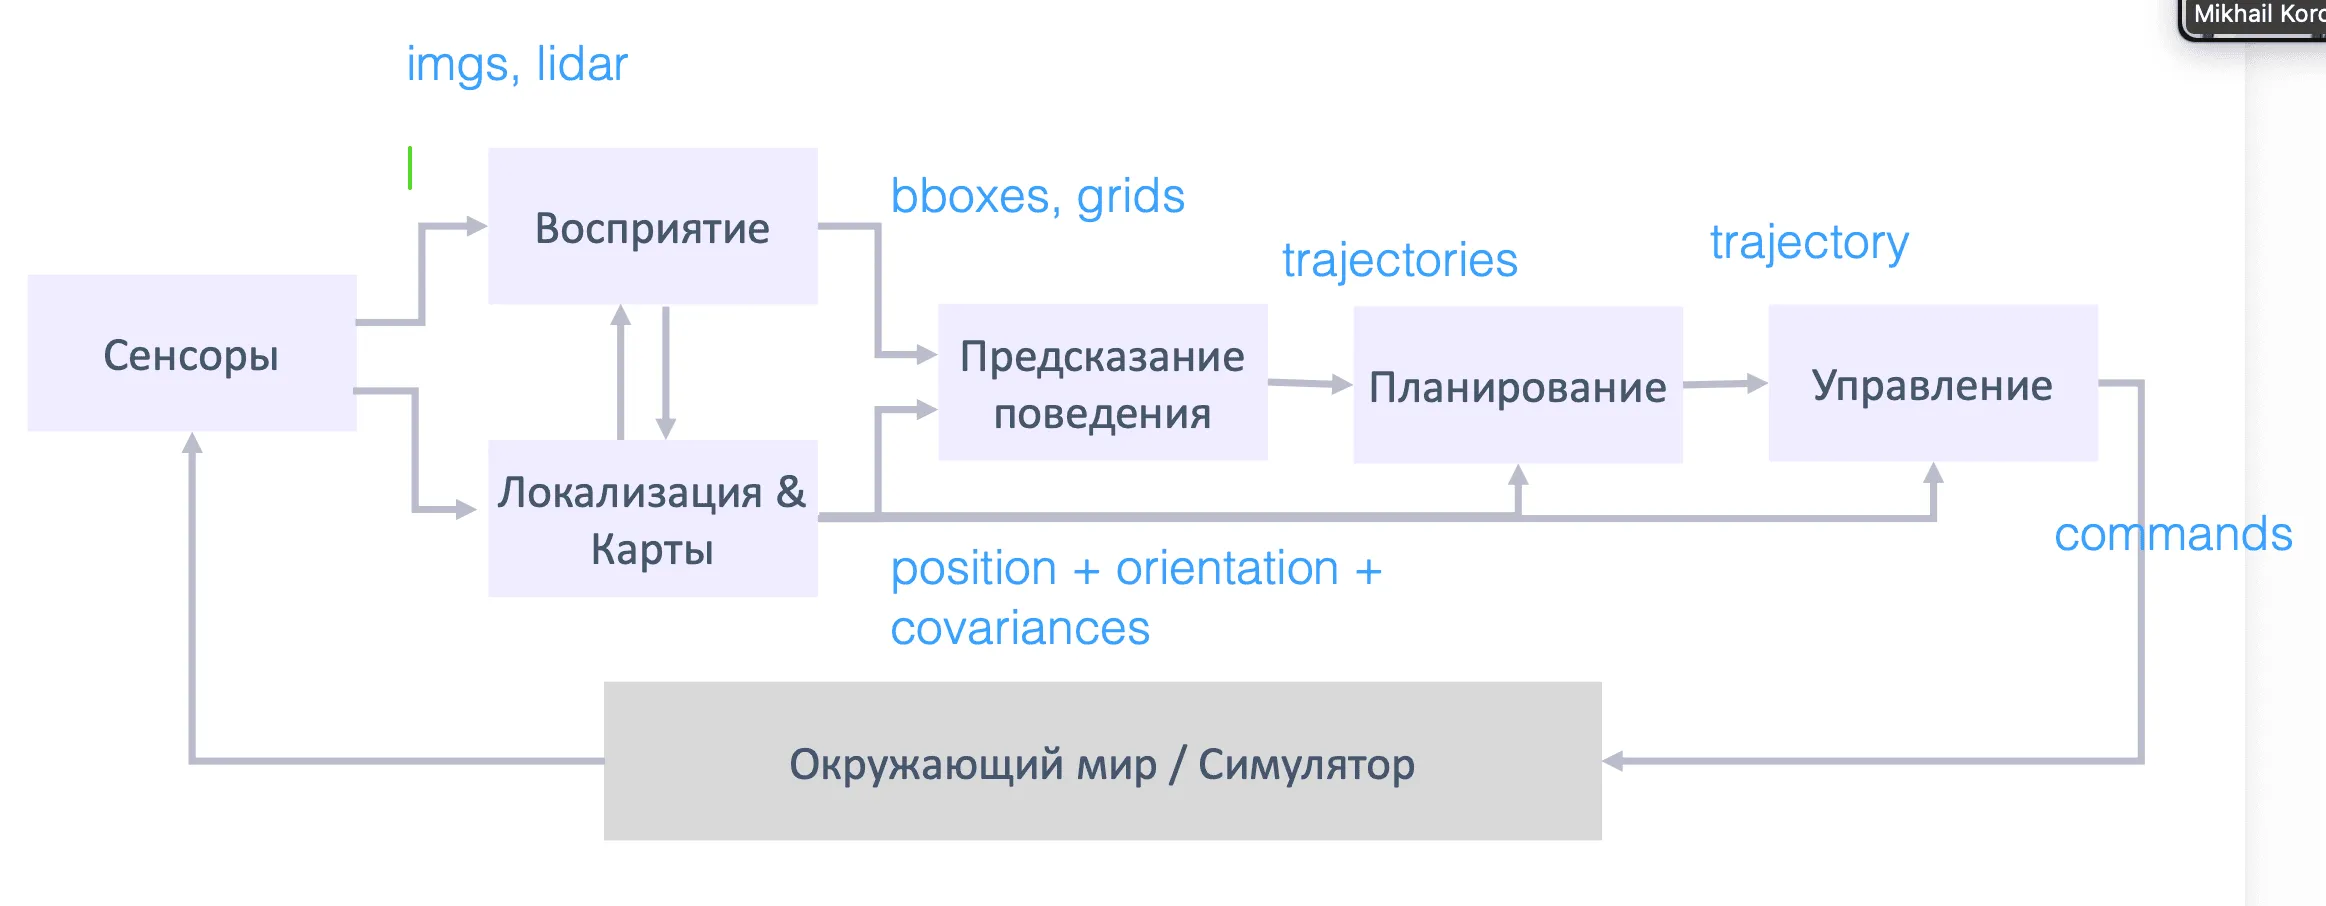
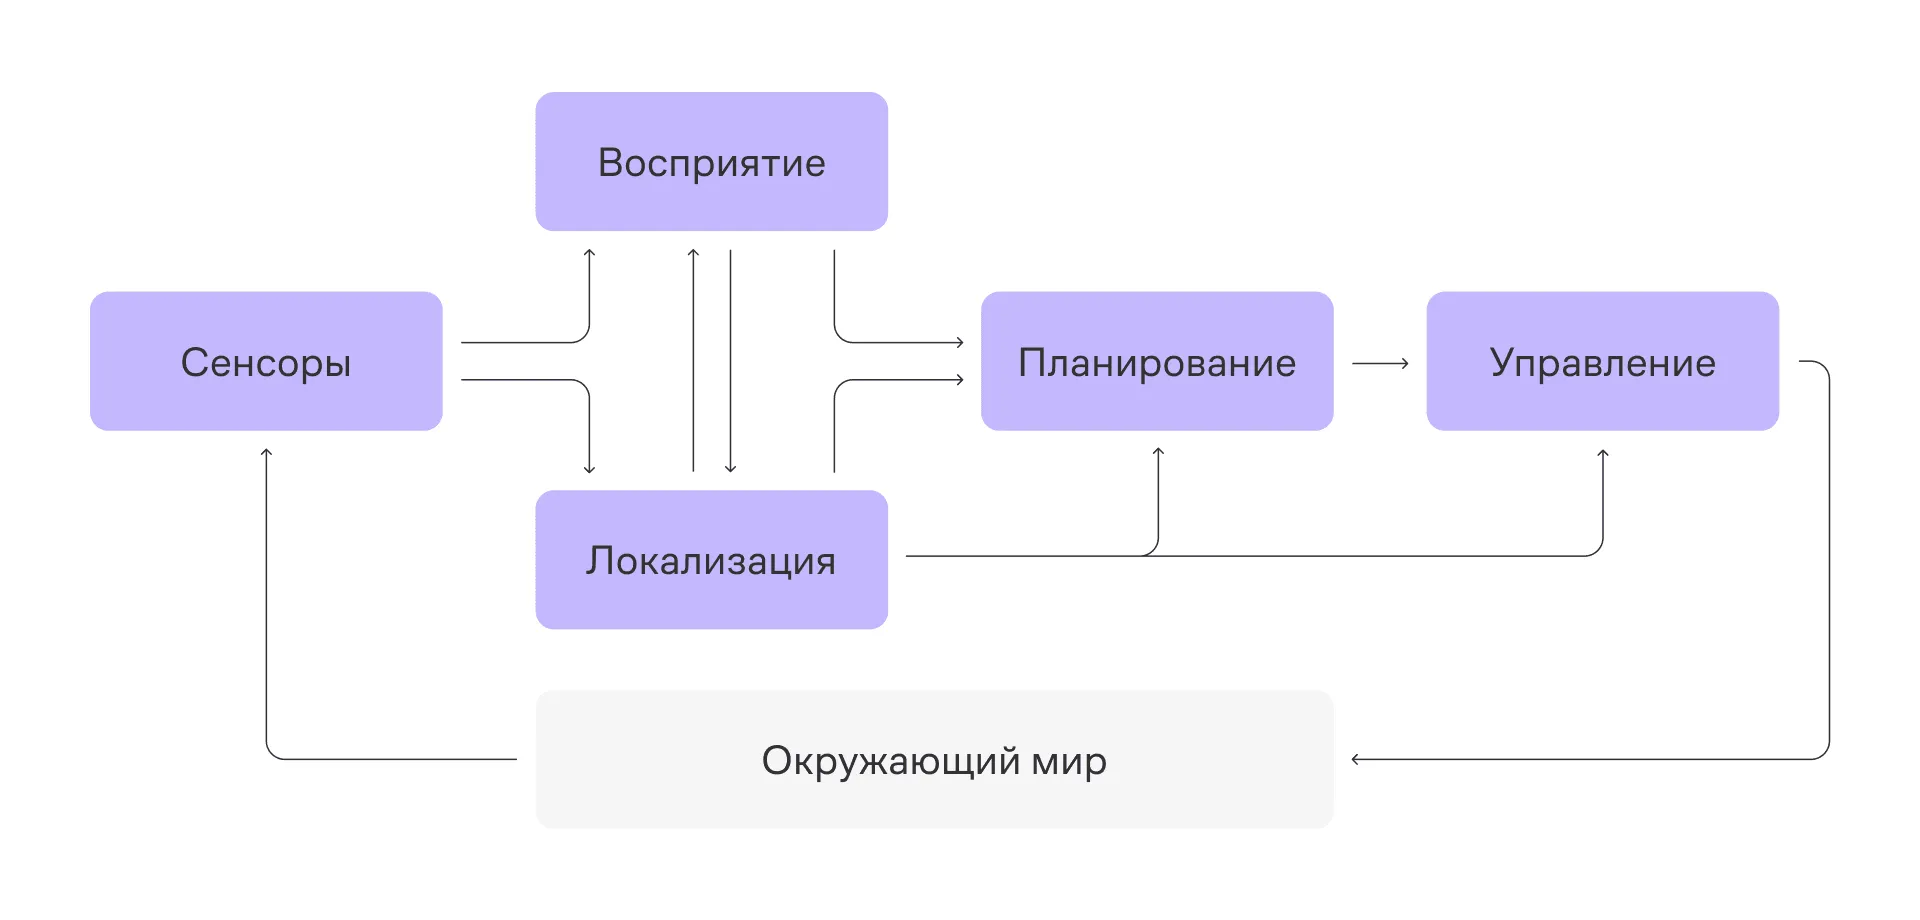
Это не финальная схема, выбитая в камне, а лишь одна из возможных реализаций. В этой главе мы ещё вернёмся к потенциальным модификациям.
Цикличность — одно из самых важных свойств, которое охватывает весь робопайплайн. В пайплайне перевода из параграфа 2.4 поступление предложения на вход триггерило все модули по цепочке. Здесь же есть несколько похожих триггеров:
- Поступление данных с сенсоров. Примером модулей, использующих данный триггер, служат локализация, персепшен и предсказание поведения.
- Таймеры, запускающие обработку входной очереди сообщений или генерации выхода. По такому принципу работают модули управления и планирования. Они всегда берут самые свежие данные на вход и на их основе создают выходное представление с нужной частотой.
В нашей системе образуется несколько важных потоков данных, которые периодически повторяются:
- Данные с сенсоров → Обработка данных → Обновление части модели мира.
- Самая свежая модель мира → Построение плана → Исполнение плана.
Под моделью мира мы будем понимать знания о статических и динамических препятствиях, их расположение в мировой системе координат, прогнозы и такую же информация о нашем положении.
Давайте посмотрим более внимательно на элементы в каждой из цепочек.
Работа с сенсорами
Получение данных от «железа» или сенсоров (сенсинг) — это первый модуль в цепочке построения модели мира для робота. Как правило, на роботах используются следующие типы сенсоров:
- Сенсоры для восприятия мира вокруг (лидары, радары, камеры, ультразвуковые датчики; силомоментные и датчики касаний в гуманоидах и роборуках).
- Специализированные сенсоры для локализации (GNSS-приёмник, например, ГЛОНАСС, IMU, одометры).
На уровне модуля сенсинга происходит периодическое чтение данных с сенсоров, декодирование этих данных, а также первичная предобработка и очистка от шумов, которая нужна всем потребителям данных с этих сенсоров.
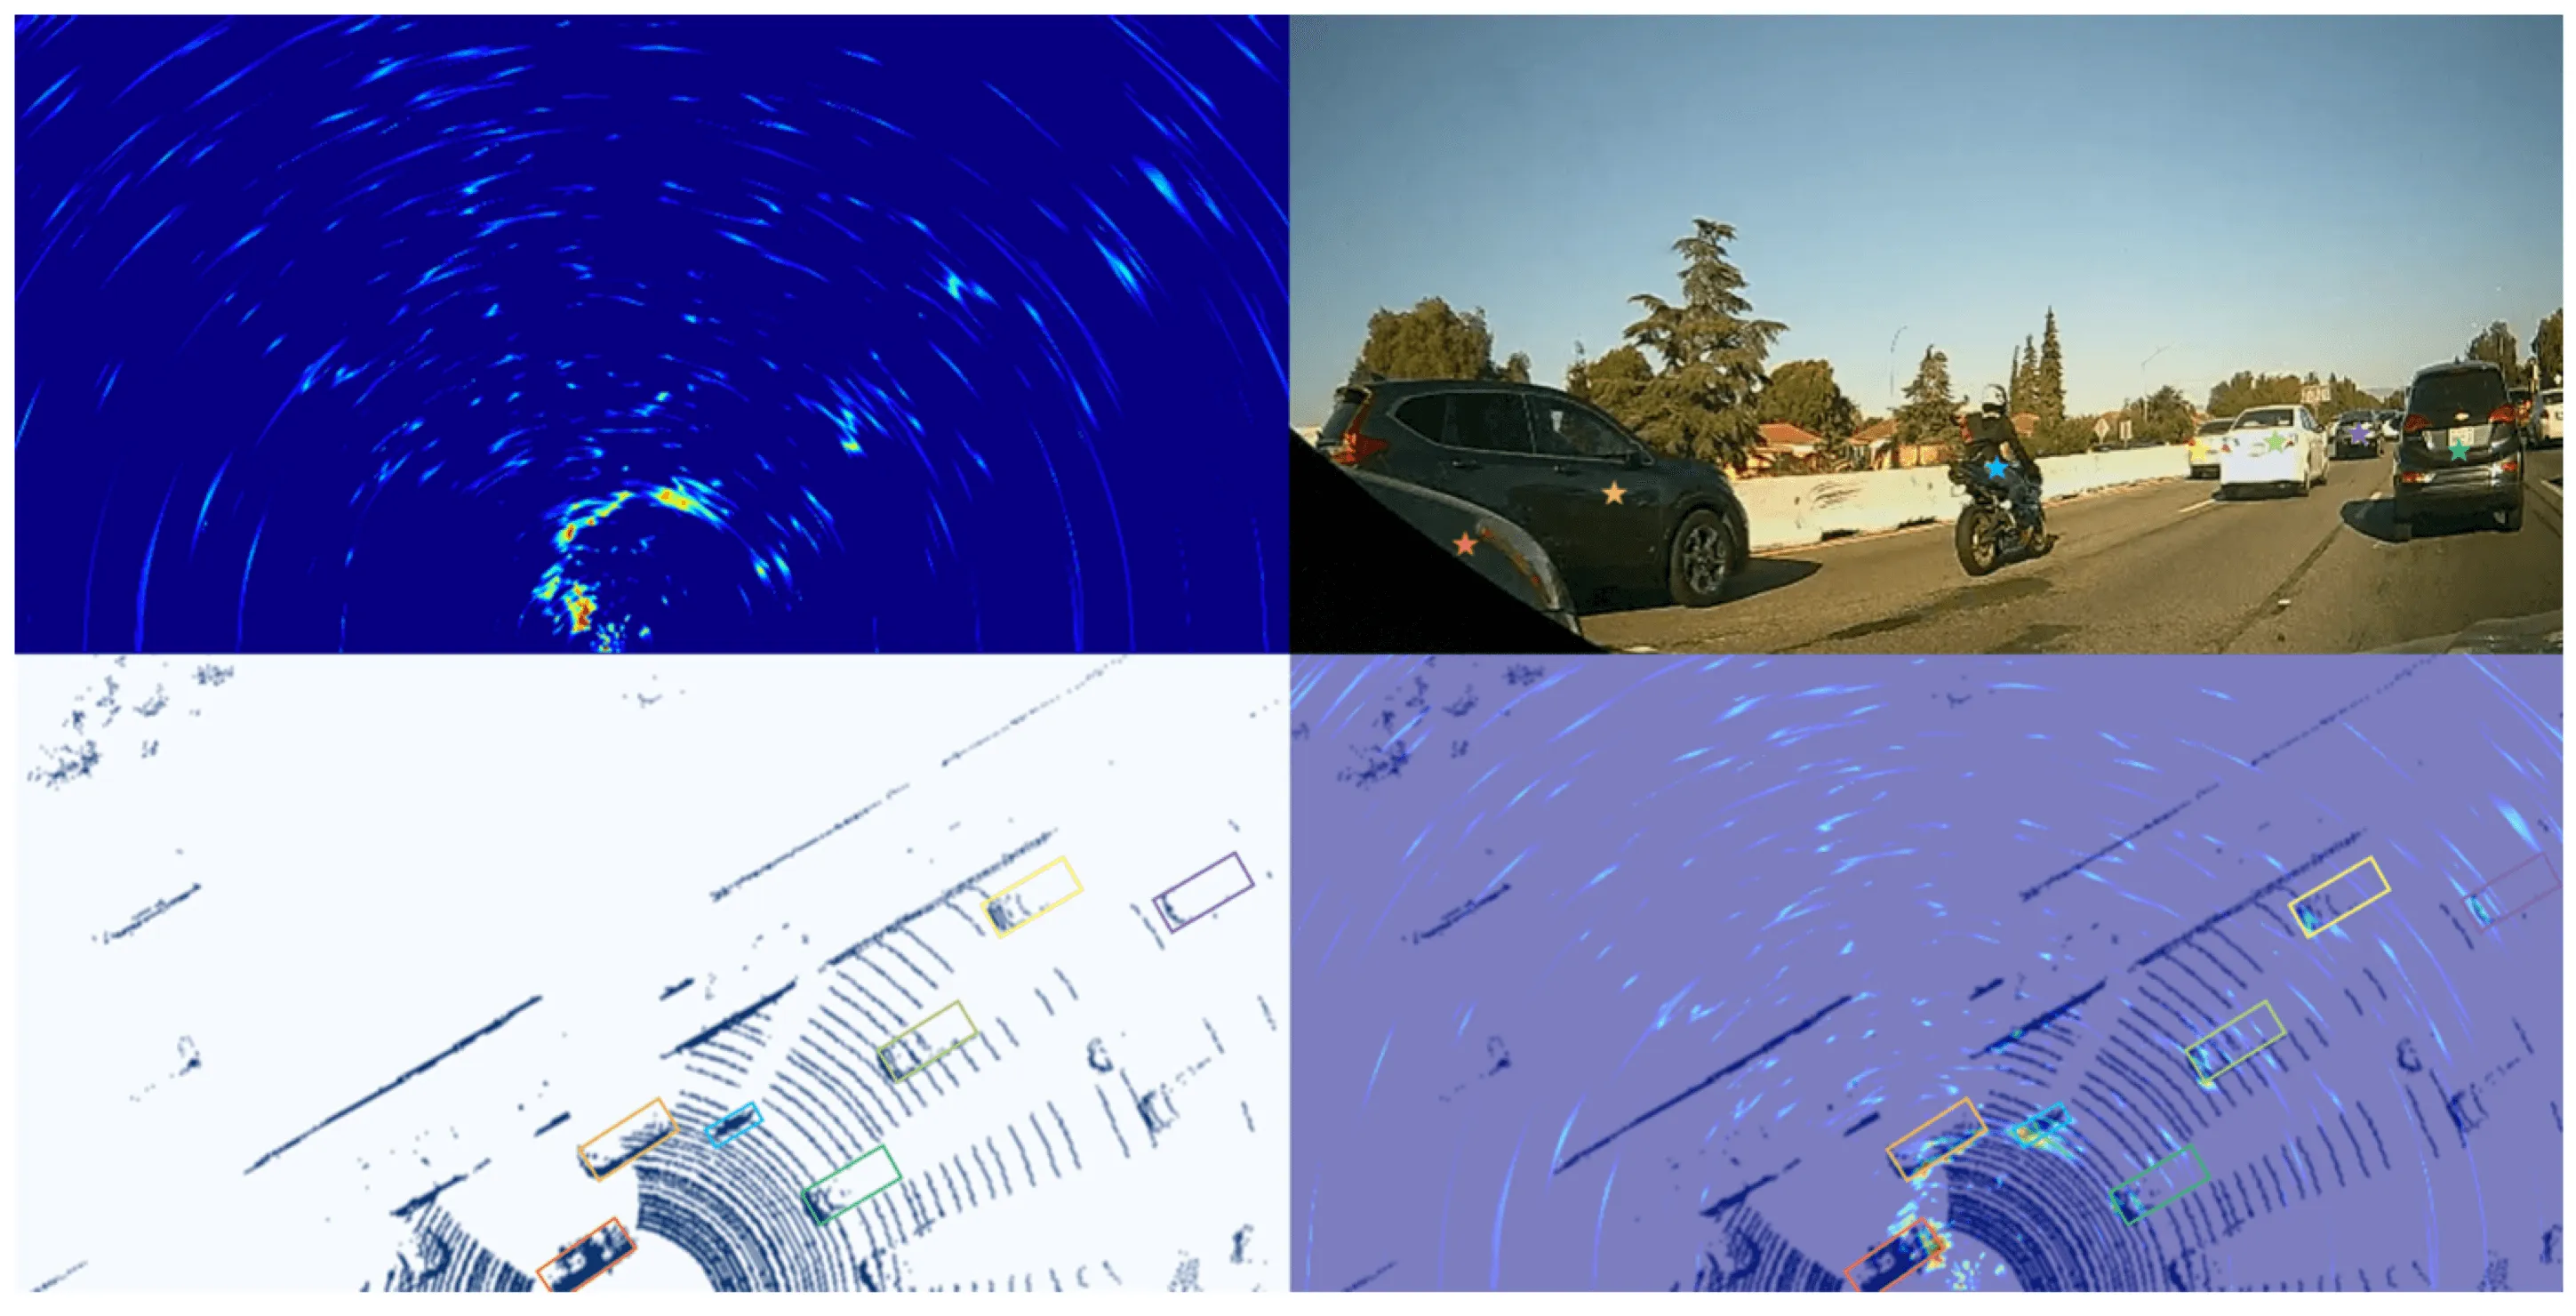
Почувствовать разницу между различными сенсорами проще, смотря на одни и те же объекты. Давайте взглянем на визуализацию радара (верхний левый угол), лидара (нижний левый угол) и камеры (верхний правый угол), установленные на автономном автомобиле. Правый нижний угол — результат совмещения лидарной и радарной визуализаций.
Кроме того, важный подготовительный этап работы — калибровка сенсоров. Она включает в себя как подбор внутренних параметров сенсоров (например, параметров кривизны линз в камерах), так и определение положения сенсора относительно некоторой фиксированной точки на корпусе робота.
Калибровка сенсоров даёт возможность сопоставлять данные, снятые разными сенсорами или одним сенсором, но в разное время. Например, зная калибровки камеры и лидара, можно спроецировать лидарные точки в камеру и обогатить их информацией о цвете.
Процедура калибровки обычно сводится к задаче оптимизации: требуется подобрать параметры сенсора, минимизирующие некоторую функцию ошибки.
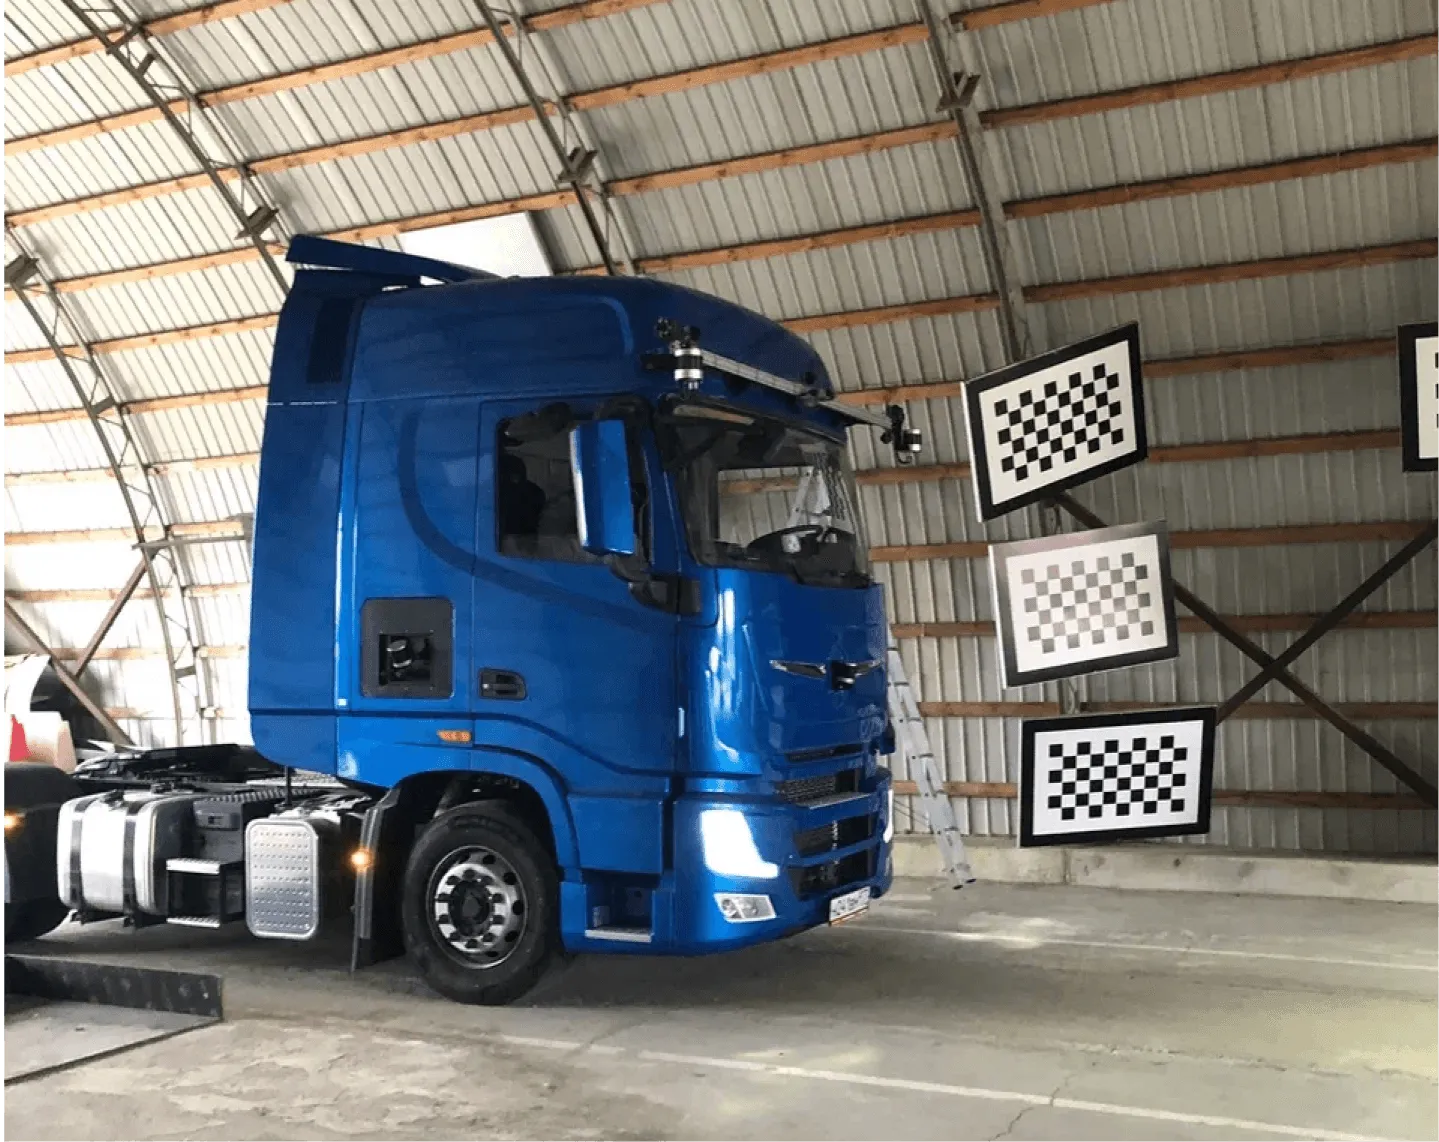
Например, для калибровки внутренних параметров камеры часто используется специальная калибровочная доска, на которой изображён «шахматный» паттерн — чередующиеся чёрные и белые клетки.
Такой паттерн легко распознаётся на камерах. Если известен размер клетки в шахматном паттерне, то по нескольким снимкам калибровочной доски можно подобрать параметры камеры, которые минимизируют расстояние между теоретическим положением уголков клеток и фактически найденным положением уголков на картинке.
В реальной жизни калибровочное окружение может выглядеть вот так:
Как вы могли догадаться, модули сенсинга стоят первыми в классическом пайплайне. Именно они взаимодействуют с реальным миром. Это приводит к нескольким неприятным проблемам.
Сенсоры могут загрязняться, и из-за этого качество данных деградирует. Крепления сенсоров могут разбалтываться со временем, и, как следствие, калибровки приходят в негодность. Физические соединения сенсоров с вычислительными устройствами могут начинать сбоить и искажать данные.
Эти и другие проблемы приводят разработчиков классического пайплайна к дилемме: разрабатывать ли идеальную систему сенсинга, пропускающую дальше по пайплайну только «чистые» данные, или же делать последующие компоненты классического пайплайна устойчивыми к шумным данным, размазав обработку по всей системе?
На практике выбор оказывается иллюзорным, и для хорошей системы необходимы оба подхода. Более подробно к вопросу фиксации границ между компонентами мы вернёмся в параграфе 3.2.
Сенсинг поставляет данные для любых модулей, участвующих в построении модели мира. От выходных данных сенсинга зависит «жизнь» остальных модулей пайплайна и пригодность получаемой модели.
Локализация
Как правило, в любом роботе есть некоторая подвижная часть, совершающая полезную работу.
Задачей модуля локализации является определение положения всех подвижных частей в текущий момент. Например, если говорить про автономный транспорт, то от локализации требуется определить положение автомобиля в некоторой мировой системе координат, чтобы правильно построить маршрут к месту назначения, а также вовремя корректировать отклонения от этого маршрута.
Именно локализация создаёт цикл обратной связи для модулей планирования и управления. Без них автомобиль не смог бы удержаться на заданном маршруте. При управлении же роботом-гуманоидом от локализации требуется определить положение как робота целиком в некоторой мировой системе координат, так и положение его рук, ног, головы и промежуточных подвижных суставов.
Данные о положении различных частей робота затем попадают в общую модель мира. Исходя из нашей схемы понятно, что локализация работает не в вакууме, а потребляет данные разных сенсоров. Но выбор сенсора и подхода к локализации тесно связаны. Всего выделяют два подхода:
- построение абсолютной локализации;
- построение относительной локализации (одометрия).
Рассмотрим оба подхода чуть подробнее.
Методы абсолютной локализации
Методы для получения абсолютной локализации находят положение робота в фиксированной системе координат, не меняющейся между запусками.
Простейшим примером такого метода является обработка сигнала GNSS, который сам по себе даёт информацию об абсолютном положении приёмника сигнала в пространстве.
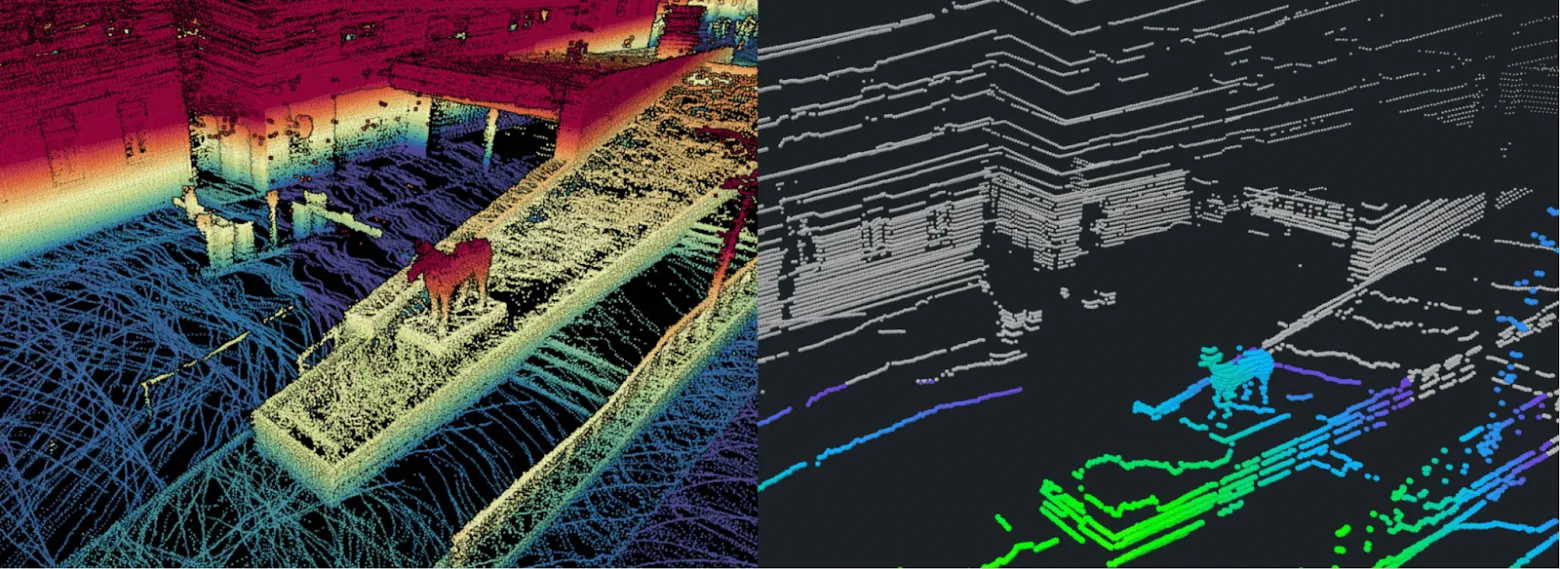
Другим примером является метод ICP (англ. Iterative Closest Point). Данный метод получает на вход лидарные облака и подбирает оптимальное преобразование (матрицу поворота и вектор смещения ) так, чтобы текущее лидарное облако лучше всего совпадало с некоторым референсным лидарным облаком окружающего мира.
Вот так выглядит пример референсного облака с рельефом местности для локализации робота-доставщика по лидару (слева) и real-time лидарного облака с этого робота (справа).
Методы относительной локализации
Методы относительной локализации облегчают себе задачу. Они привязывают положение робота к какой-то произвольной точке. На эту точку обычно не накладывают много ограничений.
Зная результат работы этих методов, а также положение робота в предыдущий момент времени, можно легко вычислить новое положение робота. Например, для колёсных роботов, зная скорости вращения колёс, их радиус и направление движения, можно с помощью формул из школьной физики вычислить перемещение робота.
Другой пример относительно локализации — метод ICP. Мы уже рассматривали его при обсуждении абсолютной локализации. Оказывается, его можно применить и для вычисления относительной локализации, если вместо карты использовать предыдущее лидарное облако. В этом случае модуль будет решать задачу лидарной одометрии.
Аналогичным образом получается метод визуальной одометрии: по двум последовательным картинкам с камеры также можно определить, как сместилась камера в пространстве.
Недостатки методов
Недостаток методов из первой группы кроется в происхождении локализации. Без специальных внешних источников знаний не обойтись, будь то спутники на орбите с известным положением или заранее построенное плотное лидарное облако местности.
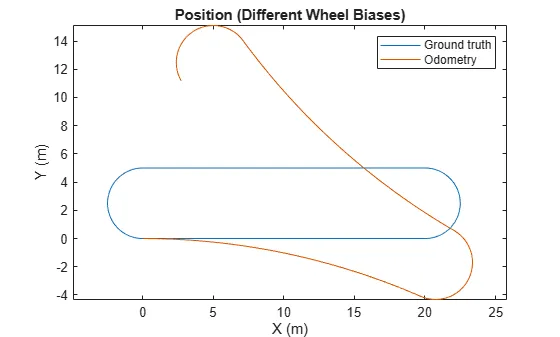
Методы второй группы неприменимы во всех случаях из-за того, что накапливают ошибку во времени. На графике ниже наглядно видно, как накопление ошибки при относительной локализации (систематическое отклонение в сторону) сказывается на оценке абсолютного положения.
Методы одометрии можно приблизить к методам абсолютной локализации за счёт построения карты во время работы. Группа подобных методов называется SLAM (англ. Simultaneous Localization And Mapping).
На практике хочется выжать максимум из имеющихся ресурсов. Поэтому на роботах одновременно запущены несколько алгоритмов локализации, по одному из каждой группы. Результаты их работы объединяются с помощью третьего алгоритма (например, фильтра Калмана).
Это помогает отфильтровать ошибки одного из источников при работающих других, а при усреднении хорошо работающих источников получить более высокую точность.
Итак, после модуля локализации у нашей модели мира появилась точка отсчёта. Давайте научим её воспринимать другие элементы этого мира!
Восприятие
Модуль восприятия также находится в цепочке построения модели мира, получая на вход данные с сенсоров. В случае с методами локализации для модели мира мы выбирали между абсолютными и относительными перемещениями.
В методах восприятия вариантов выбора множество. И чаще всего выбирают такое представление, с которым удобнее всего работать последующим модулям пайплайна. Также выбор конкретной модели зависит от задачи, которую должен решать робот, и конфигурации имеющихся сенсоров.
Существует два подхода к представлению объектов в модели окружающего мира:
- моделирование объектов с помощью некоторых структурированных (векторных) примитивов;
- более абстрактное моделирование занятости пространства, возможно, без привязки к объектам.
Первую группу будем называть структурированными, а вторую — неструктурированными.
Начнём с рассмотрения структурированных представлений.
Структурированные представления
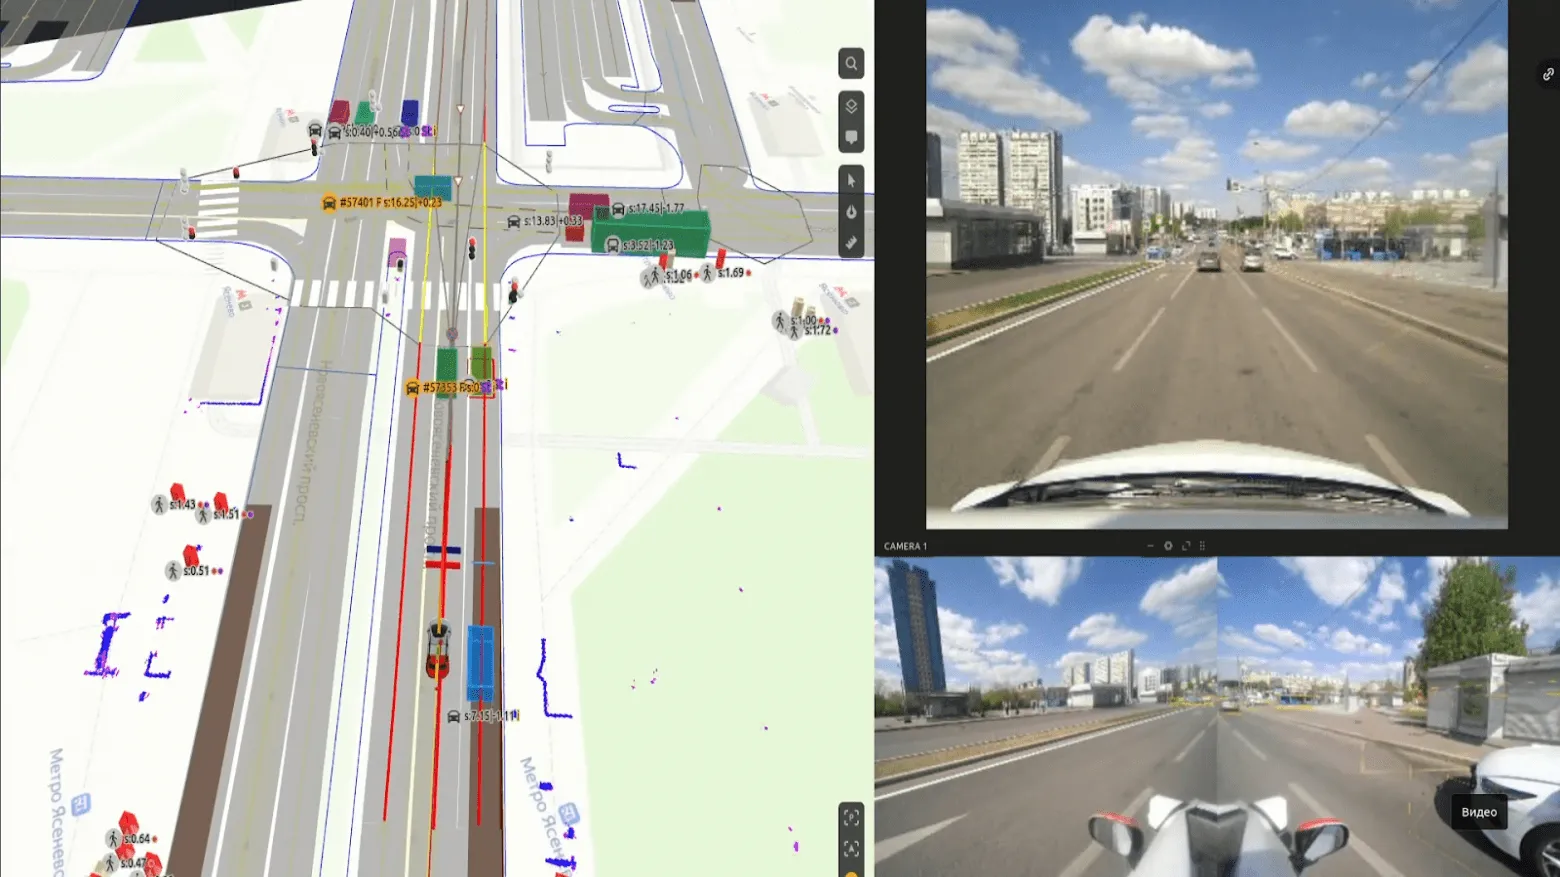
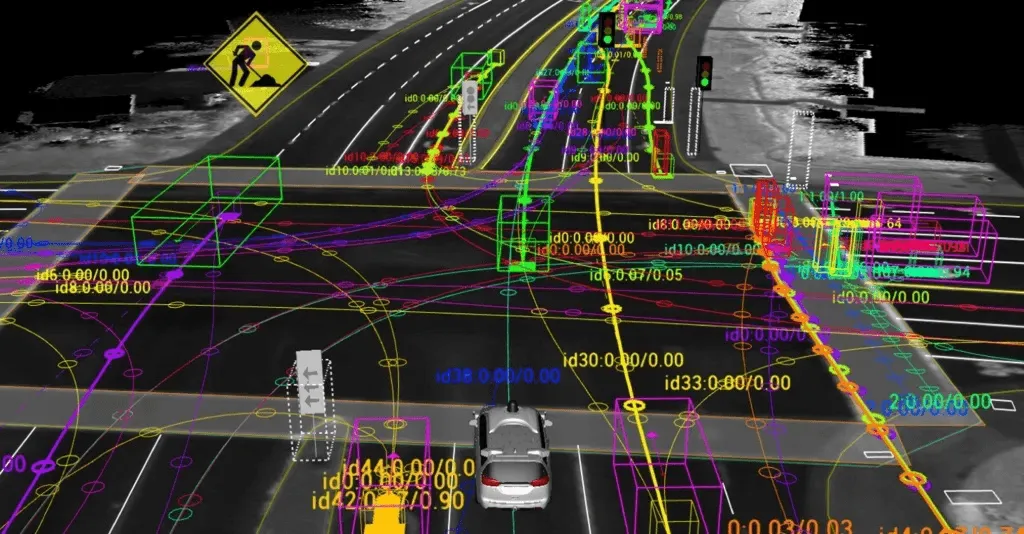
Взглянем на реальный пример. На иллюстрации ниже автомобили и пешеходы отображаются как параллелепипеды, которые обогащены дополнительной информацией, например, типом объекта, его скоростью и направлением движения. Иногда добавляют уникальный идентификатор, чтобы находить похожие экземпляры объектов во времени.
Слева на изображении — пример модели представления мира, используемой в автономном автомобиле. Справа — изображения с трёх фронтальных камер автомобиля.
Помимо динамических объектов, векторное представление включает данные про карту — полосы для движения, которые также имеют свои внутренние атрибуты: максимальную разрешённую скорость для движения, возможность перестроиться на соседние полосы, допустимость остановки и парковки на этой полосе.
Здесь также есть информация о светофорах, пешеходных переходах и зонах перекрёстков.
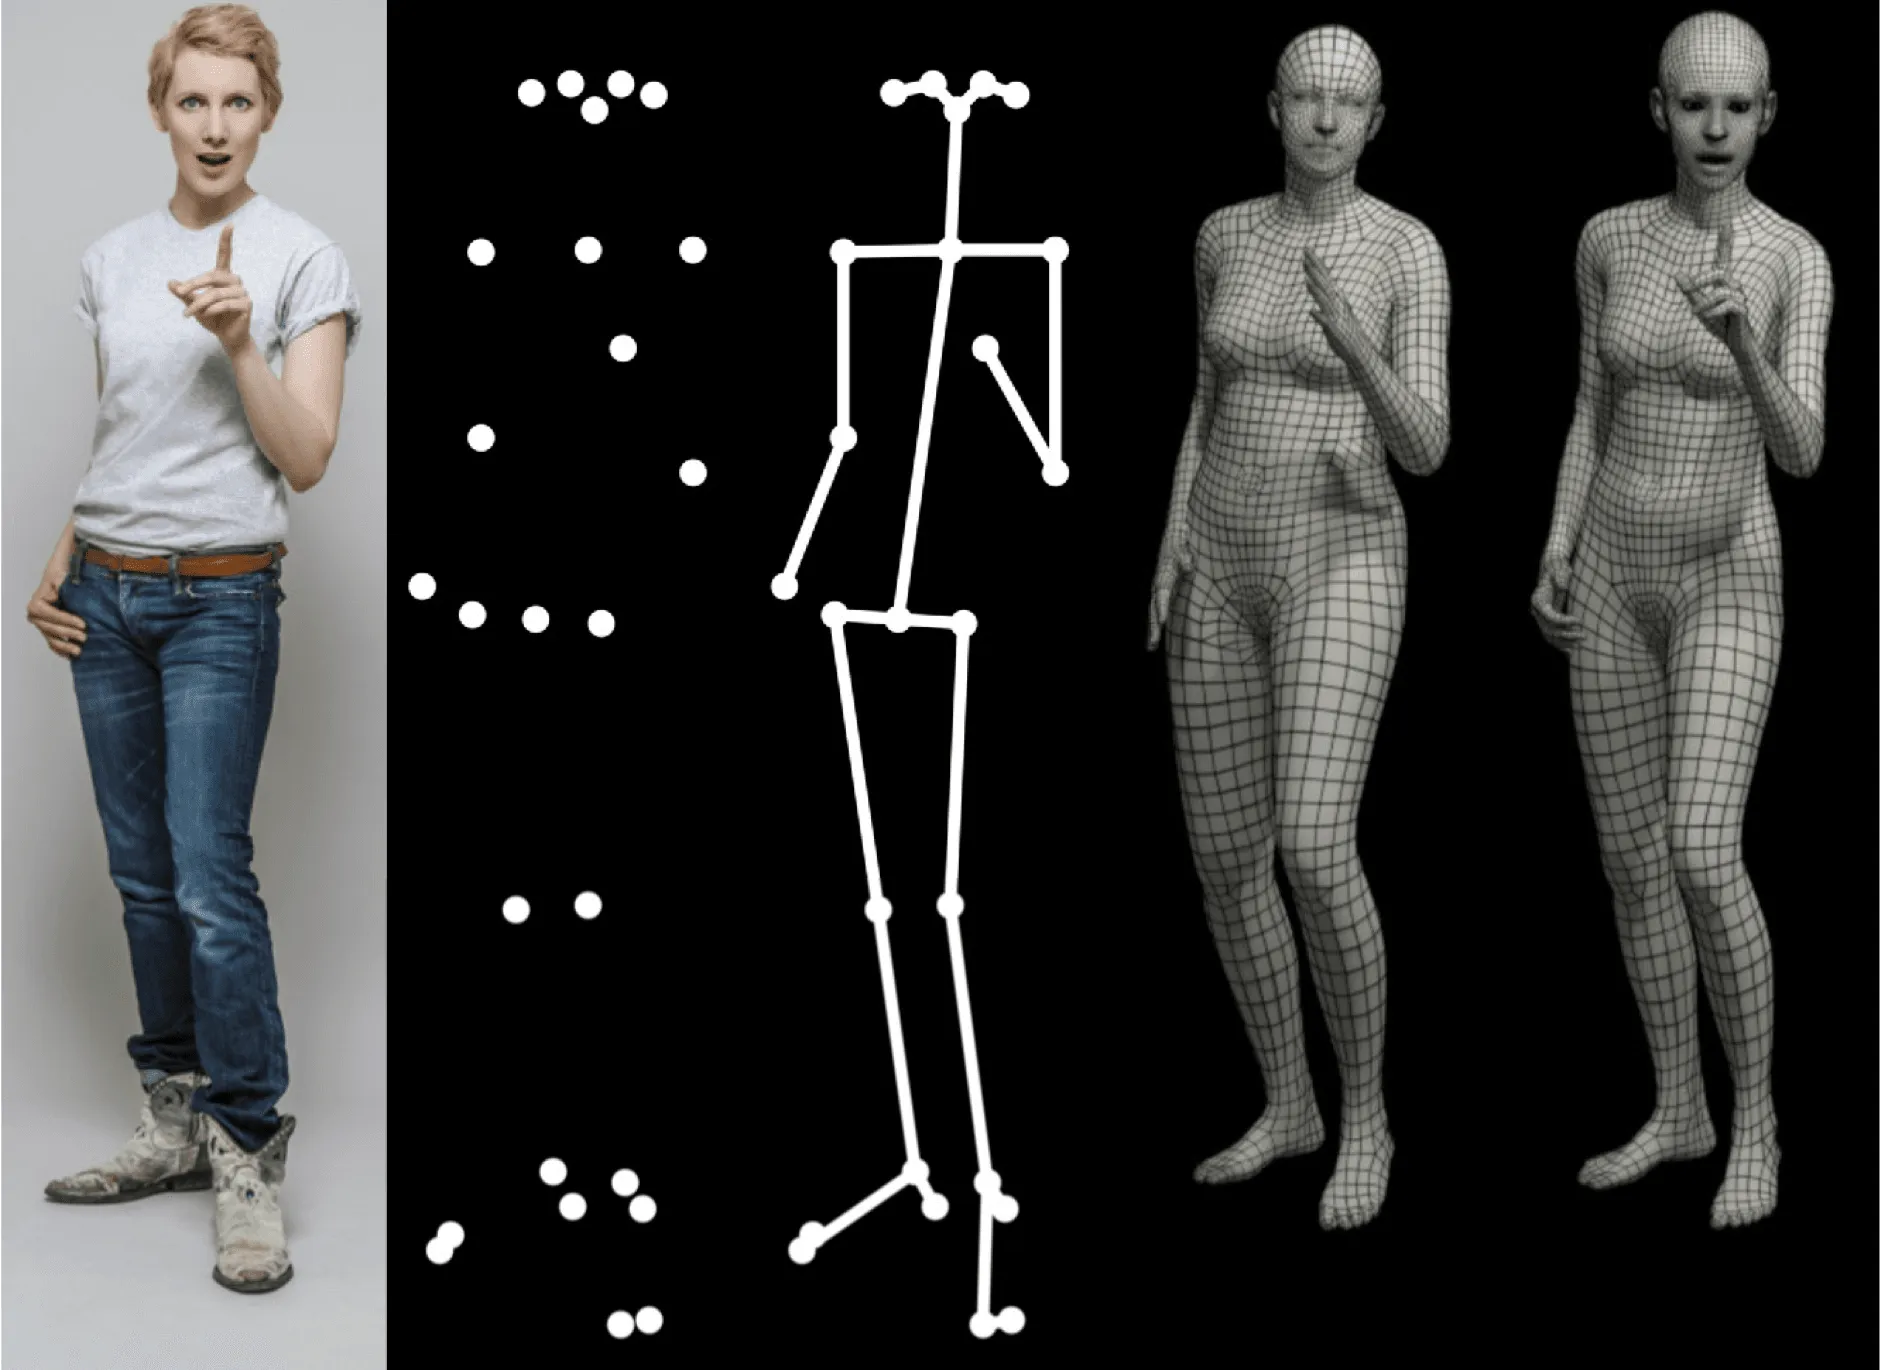
Векторные представления могут иметь крайне высокую разрешающую способность — например, когда нужно представить человека более точно.
На иллюстрации как раз изображено такое представление в порядке слева направо: картинка, опорные точки, скелетное представление, модель SMPL, модель SMPL-X.
Другой пример векторных представлений: упрощённые модели человека, которые применяются в роботах, предполагающих взаимодействие с людьми.
Там, где требуется знать текущую позу головы, рук или человека целиком, может быть достаточно представления человека в виде набора опорных точек, например, привязанных к основным суставам.
В задачах, требующих точную виртуальную модель человека, обычно используется специализированная модель SMPL или её расширения. Например, такие модели активно используются в гуманоидных роботах, копирующих действия людей.
Неструктурированные представления
Неструктурированные методы основываются на картах занятости (англ. occupancy map, occupancy grid).
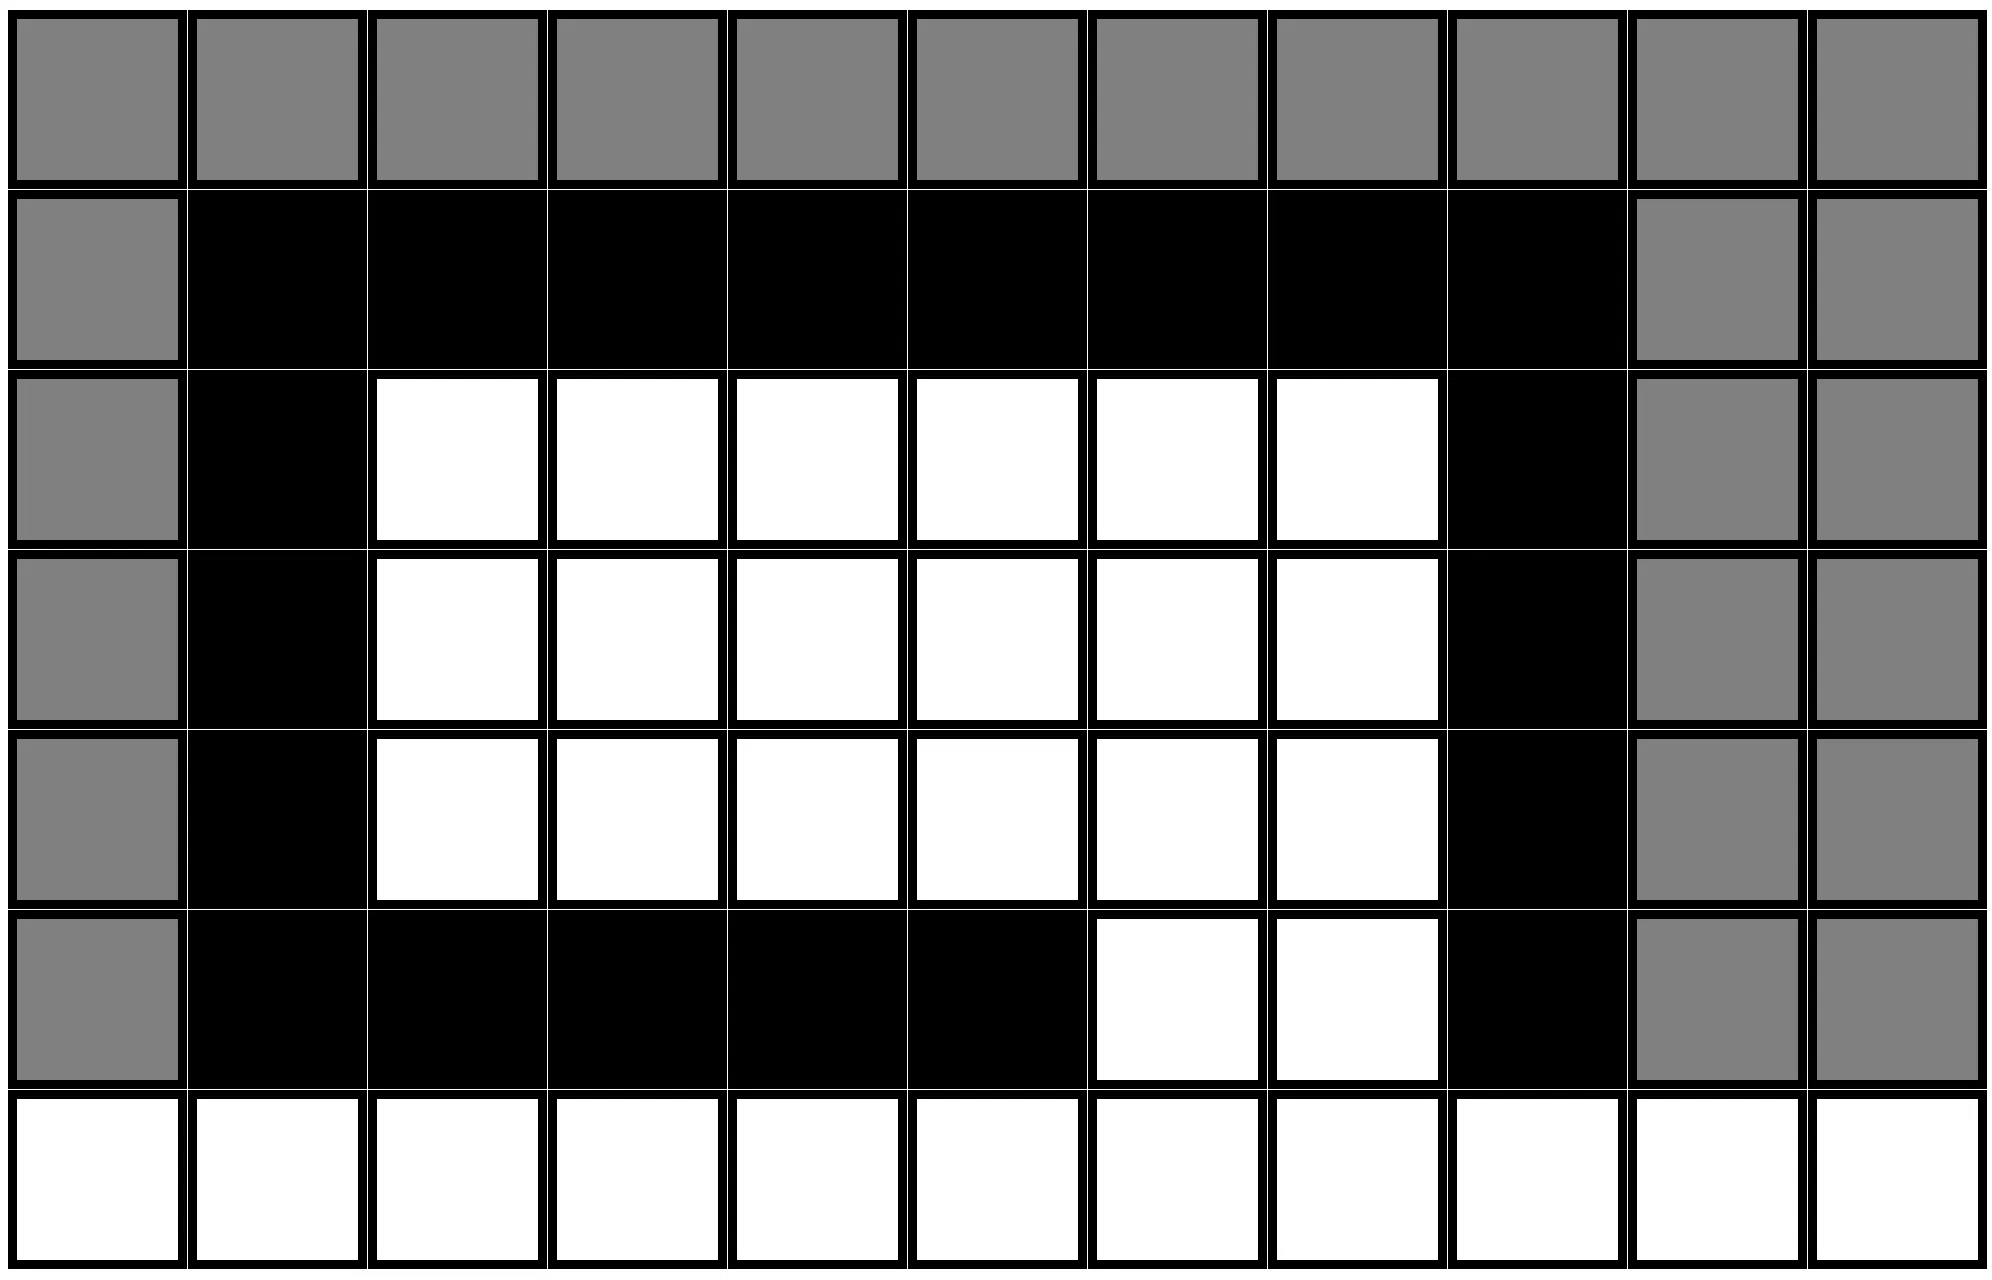
В этих методах 3D-пространство или 2D-плоскость (если робот выполняет операции на плоскости) нарезается на ячейки, обычно с равномерным шагом. В каждую ячейку записывается число от 0 до 1, которое соответствует уверенности робота в том, что ячейка занята. Значение 0.5 соответствует тому, что робот не имеет информации о занятости ячейки.
Таким образом у карт занятости появляется некоторая вероятностная интерпретация: каждую ячейку можно считать бинарной случайной величиной и работать с ней, используя аппарат теории вероятностей. В частности, можно с помощью простых формул агрегировать во времени информацию о занятости пространства и собирать карты занятости, покрывающие большую площадь.
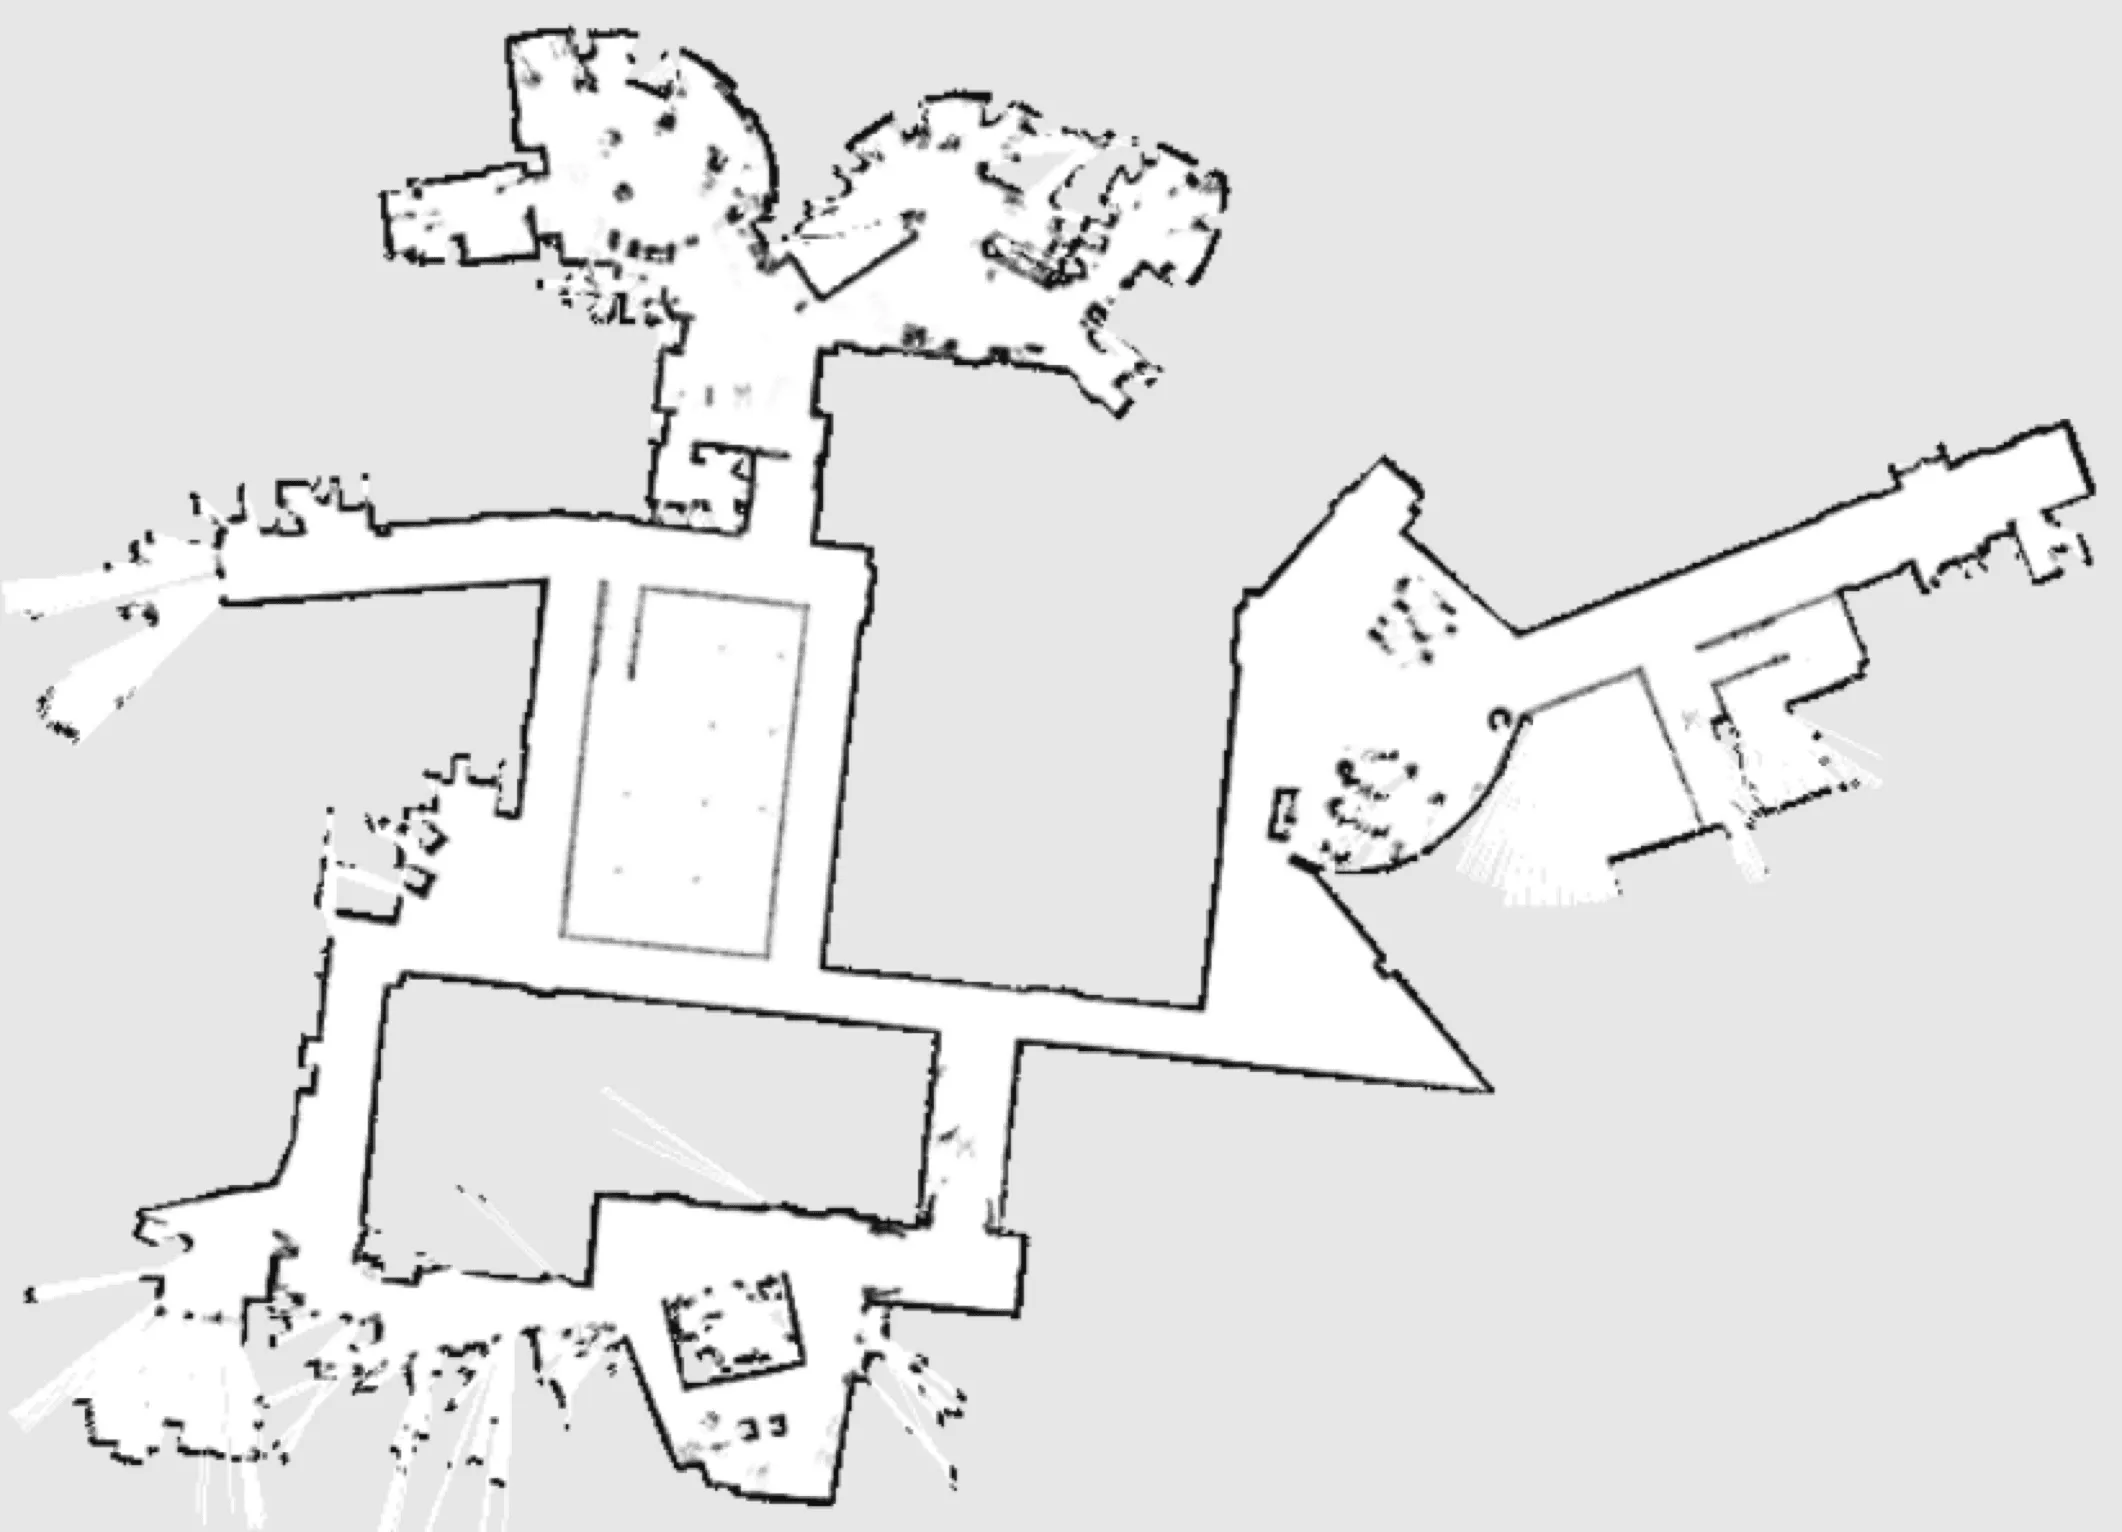
Для наглядности взглянем на несколько примеров таких карт. Слева — пример двумерной карты занятости. Белый цвет у ячейки означает, что она свободна, ячейки чёрного цвета содержат препятствия, состояние серых ячеек не определено. Справа — карта занятости, которую собрал робот, проехавший по третьему этажу здания лаборатории CSAIL MIT.
Обычно карты занятости используются для представления информации о статических препятствиях. Однако существует формат динамических карт занятости, когда в каждой ячейке записывают скорость и направление движения объекта в этой ячейке. Такой формат становится пригодным и для хранения информации о динамических объектах.
Рассмотренные выше подходы являются комплиментарными. Структурированное представление объектов позволяет детально описать объект, сохранив всю интересную для работы робота информацию. Но структурированные представления надо проектировать под каждый класс объектов адресно. Не существует универсального структурного представления, в котором можно было бы сохранить всю информацию про любой объект.
Представление объектов в виде карты занятости же, наоборот, является универсальным и применимым к любому статическому или динамическому объекту. Однако карты занятости ограничены и в точности хранения информации, и в том, какую именно дополнительную информацию про объекты можно в ней сохранить.
Связь представления объектов с дилеммой смещения-дисперсии
Разница между структурированным и неструктурированным представлением объектов — это хороший пример дилеммы смещения-дисперсии. В общем случае дилемма говорит нам, что у нас ограниченная информация об объектах, поэтому вместе с представлением мы выбираем и сопутствующую ошибку.
В структурированных методах доминирует ошибка неправильного угадывания класса. Из-за неё мы получаем параметры объектов со смещением. В неструктурированных же на оценку каждой из ячеек карты занятости обычно приходится сильно меньше точек, чем в структурированных методах. Это приводит к большой дисперсии в оценке занятости ячеек.
В случае работы со статическими объектами на выходе модуля персепшена мы получаем готовую модель мира, на которую будет опираться модуль планирования. Для динамических объектов необходимо предсказать траектории в будущее.
Предсказание поведения
Модуль предсказания поведения, так же как и модуль восприятия, входит в цепочку построения модели мира. Он обогащает модель новым свойством — временной составляющей.
Модули локализации и восприятия отвечали за описание положения робота и состояния окружающего мира на момент прихода данных с сенсоров. Модуль предсказания поведения расширяет это понимание на ближайшее будущее. Работа модуля имеет смысл только для динамических объектов, так как предсказание будущего для статических объектов тривиально.
Так как будущее обычно не определено однозначно, в этом модуле широко применяются вероятностные методы. В частности, обычно требуется предсказать не единственное решение, а либо некоторые вероятностные распределения на возможных исходах, либо несколько наиболее вероятных исходов с оценкой их вероятности.
Как и в случае модуля восприятия, существует два подхода к описанию результатов модуля предсказания поведения: моделирование результатов в виде векторных объектов или использование карт занятости пространства.
Наиболее частый формат результата — предсказать одну или несколько траекторий для каждого динамического объекта на сцене. Рассмотрим пример на рисунке слева.
По тротуару идёт пешеход, у него есть две разумные опции: продолжить движение вдоль тротуара или перейти дорогу через пешеходный переход.
Каждая из траекторий представляет собой последовательность точек с положениями объекта во времени.
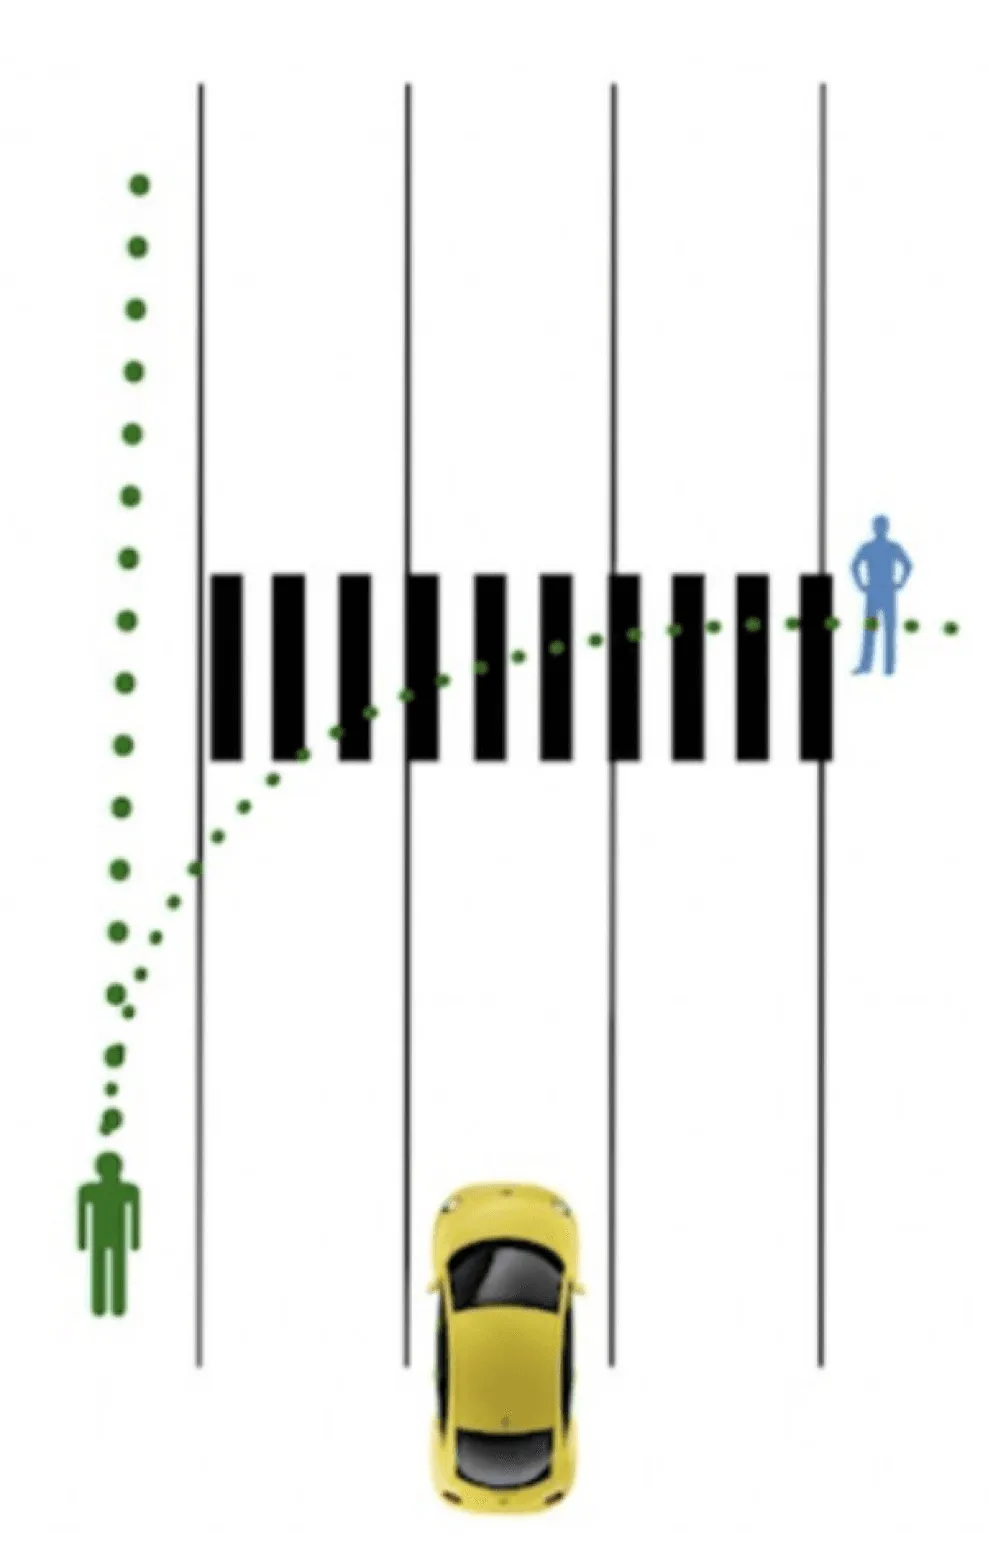
А что предскажет автомобиль для человека, которому лень идти до пешеходного перехода?
Данный подход считает такие сценарии низковероятными и не строит прогнозов. В реальных системах в этих случаях подключается модуль обеспечения безопасности. Именно он должен реагировать на все непрогнозируемые ситуации.
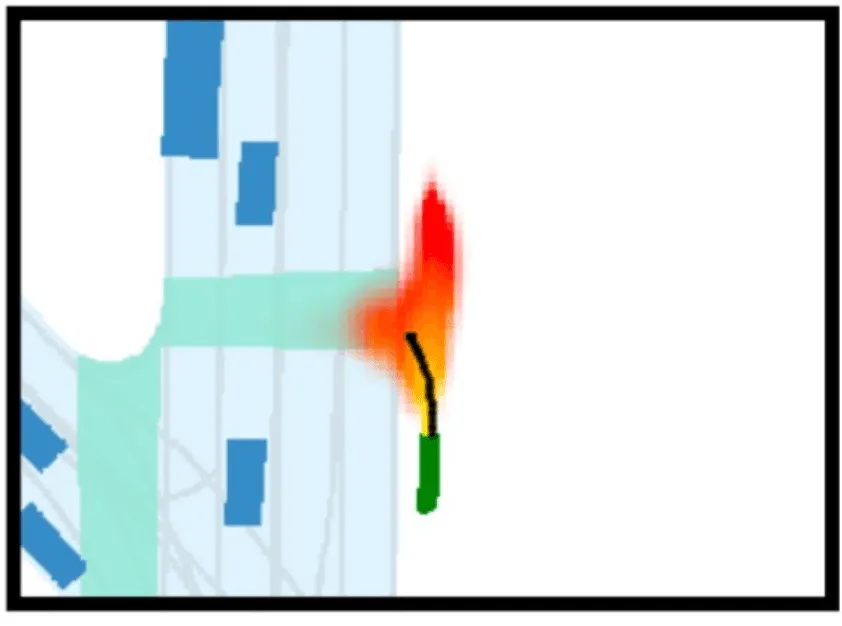
Альтернативное представление результата модуля предсказания поведения — это набор карт занятости зоны вокруг робота на некоторые зафиксированные моменты времени в будущем. На рисунке выше справа приведён пример такой карты занятости для пешеходного перехода (зона красно-оранжевого цвета). Разная яркость ячейки соответствует разной вероятности того, что ячейка будет занята. В зависимости от того, с какой скоростью пойдёт пешеход и какое направление он выберет, он сможет оказаться в том или ином месте на карте.
Модуль предсказания поведения даёт нашей модели мира новую ось — время. Теперь мы знаем не только про окружение, но и про его эволюцию в будущее.
Причём запуск перечисленных модулей происходит не один раз. Модель мира эволюционирует после получения и обработки новых данных с сенсоров.
На этом модуле заканчивается цепочка построения модели мира. Все последующие модули пайплайна будут опираться на эту модель.
Планирование
Модуль планирования — первый модуль из цепочки данных, работающих только на модели мира.
У этого модуля нет явного сигнала о том, что нужно начинать работу. Вместо этого модуль регулярно получает свежую модель мира с положением себя и своих частей, описанием окружения и его изменений во времени.
Также входным параметром является некоторая целевая точка или набор из нескольких возможных целевых точек, где робот должен оказаться. На выходе модуль планирования выдаёт траекторию, по которой робот должен перемещаться, чтобы оказаться в одной из таких целевых точек.
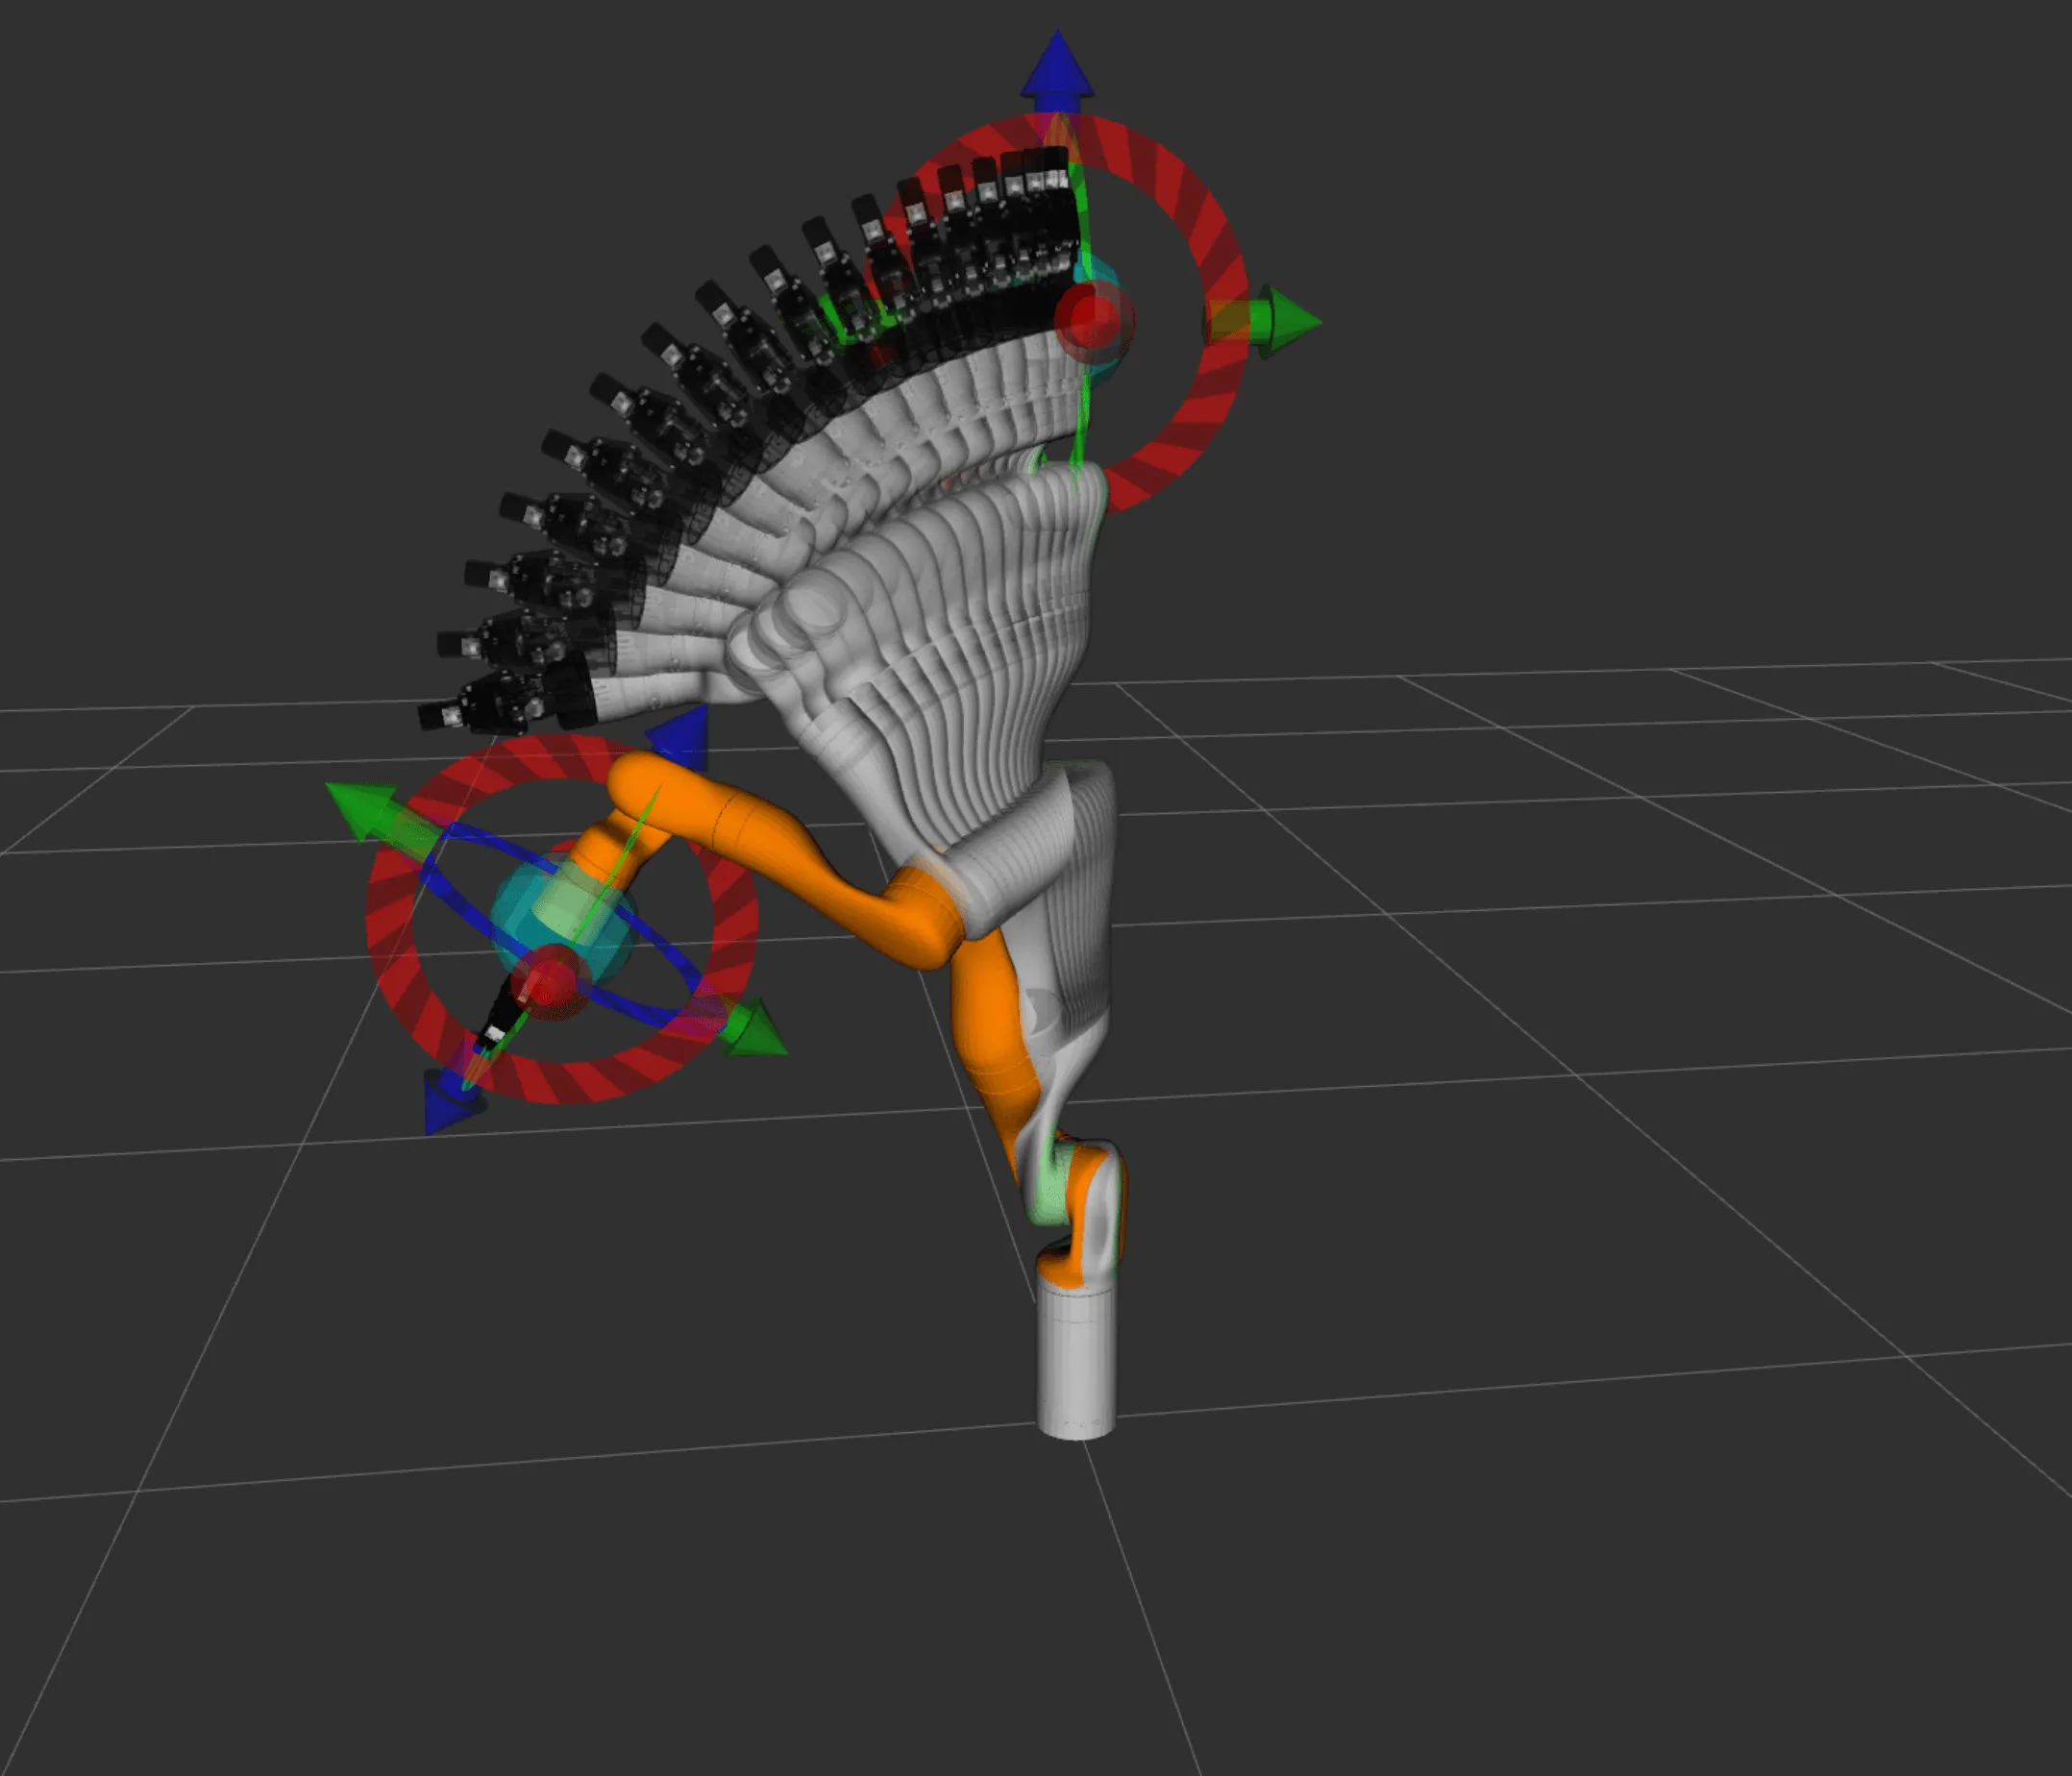
Обычно траектория, которую выдаёт модуль планирования, — это набор точек или состояний робота, в которых тот должен оказаться, чтобы попасть из начального положения в целевое.
В зависимости от робота может использоваться разный формат описания состояния робота. Например, в случае роборук можно взять в качестве состояния ориентацию и положение исполнительного механизма руки (англ. end effector). В случае роботакси обычно берут ориентацию и положение автомобиля, а также линейные и угловые скорости и ускорения.
Два самых распространённых классических подхода в планировании — графовый и вероятностный. Один из них ориентируется на поиск в регулярной структуре. Второй же последовательно перебирает случайные варианты.
К графовому подходу относится класс методов, строящий все возможные состояния, в которых может оказаться робот, приписывает каждому из переходов (ребру графа с состояниями) вес, а затем ищет в этом графе кратчайшее расстояние до целевой вершины. На практике для поиска используются алгоритмы Дейкстры или A*.
Чаще всего вероятностные подходы строятся на базе алгоритма RRT (англ. Rapidly-Exploring Random Tree) или его разновидностей. Поиск пути чем-то похож на графовый алгоритм, но его ключевая особенность смещена от того, как найти путь в графе, к построению самого графа. На каждом шаге алгоритм, как в компьютерной стратегии, пытается расширить понимание, куда можно добраться из уже открытой территории.
Путь, полученный любым из подходов, содержит изъяны, поэтому его сглаживают за счёт численной оптимизации: меньше резких изменений маршрута, скачков скорости и т. д. Только после сглаживания результат можно безбоязненно отдавать в модуль управления.
В модуле планирования мы наконец-то получили маршрут к цели, по которому может проехать робот. Осталось только отправить его на исполнение.
Управление
Последним модулем классического пайплайна является модуль управления роботом (англ. control). Модуль принимает на вход траекторию из планировщика и превращает её в низкоуровневые команды управления роботом.
Например, в автономном транспорте это команды поворота руля и управления газом и тормозом, в колёсных роботах это команды скорости колёс, в роборуках — команды поворота отдельных суставов руки.
Алгоритмы, используемые в модуле управления, — это разного рода регуляторы и контроллеры, разработанные и развиваемые в рамках теории автоматического управления (ТАУ). Примерами алгоритмов являются PID-регуляторы, Model Predictive Control (MPC) и линейно-квадратичный регуляторы (LQR).
В большом коммерческом пайплайне обычно сложно провести границу между модулем планирования и управления, особенно когда весь код собран не в паре модулей, а распилен на большее количество независимых частей.
Взять тот же модуль сглаживания, про который мы говорили в разделе планировщика. Его также можно перенести из планирования в управление. Ведь уже есть траектория, а мы делаем сглаживание лишь для того, чтобы она лучше выполнилась на устройстве.
Второй дуализм между модулями планирования и управления завязан на балансе сложности. От того, насколько хорошо планировщик построит траекторию, зависит объём работы, который должен проделать модуль управления, чтобы свести план с реальностью. Умное управление способно убрать огрехи планирования: например, уметь работать без ограничений на скоростях в точках либо додумывать выходные сигналы на коротких промежутках.
Наконец-то в этом модуле мы добрались до влияния на окружающий мир. Именно здесь мы видим первые результаты от работы всех модулей пайплайна.
Итак, мы рассмотрели модули двух главных цепочек данных: получения модели мира и навигации в пространстве с учётом этой модели. Всё вместе складывается в слаженное движение робота, который учитывает изменения в мире, подстраивая своё движение.
Гибкость классического пайплайна
Выше мы рассмотрели основные модули, которые входят в классический пайплайн. Но важно понимать, что предложенный вариант классического пайплайна — это лишь ориентир при создании будущей системы: компоненты можно менять, комбинировать произвольным образом и т. д.
Да и вообще количество возможных комбинаций того, как можно сделать, просто зашкаливает. Конкретный вид пайплайна на роботе будет сильно зависеть от задачи, которую должен решать робот, и от окружения, в котором он будет работать.
В частности, на реальном роботе часть модулей может отсутствовать или быть объединена. Например, выше мы уже сказали, что модуль предсказания поведения работает только с динамическими объектами. Это означает, что его нет смысла закладывать в пайплайне робота, который будет работать в статической среде.
Другой пример. Существуют нейронные сети, которые одновременно осуществляют и детекцию динамических объектов, и предсказание их будущих траекторий. В случае использования таких нейронных сетей в пайплайне робота модули восприятия и предсказания поведения будут объединены в единый модуль.
Также не все связи между модулями, изображённые на картинке в начале параграфа, могут присутствовать в реальном пайплайне на роботе. Например, результат модуля локализации может не использоваться в модуле восприятия, если модуль восприятия не учитывает историю показаний сенсоров и свои предыдущие результаты. Модуль локализации, в свою очередь, также может не иметь зависимости на результаты модуля восприятия, если внутри него нет никаких алгоритмов, использующих информацию о распознанных объектах.
В параграфе 3.2 мы вернёмся к наполнению пайплайна и посмотрим, как можно подойти к проектированию с опорой на системные свойства.
Итеративное развитие пайплайна
Другой особенностью классического пайплайна управления роботом является то, что можно последовательно наращивать его сложность, собирая его как по кирпичикам. И как люди могут жить годами в доме без картины или даже двери, так и робот может начать двигаться и даже приносить ценность без полного комплекта модулей.
Первым шагом можно взять задачу повторения некоторой референсной траектории. Такую траекторию можно предзаписать через ручное управление роботом. Для того чтобы решить задачу проезда по траектории, достаточно будет отладить модули управления и локализации.
Следующим шагом можно добавить в систему модуль планирования. Можем считать, что вокруг нет препятствий вообще или есть только статические препятствия, которые меняются очень и очень редко. Информацию о таких препятствиях можно сохранить в некоторой базе данных и переиспользовать вместо явного распознавания по сенсорам. Таким образом мы откладываем появление модулей восприятия и предсказания поведения в системе.
Далее можно добавлять распознавание статических препятствий как часть модуля восприятия. Это будет следующим шагом на пути к созданию полноценного пайплайна. При этом не обязательно отказываться от использования базы данных со статическими препятствиями, которая появилась на предыдущем шаге.
Следующий шаг — добавление знаний про динамические препятствия в систему. Это разблокирует добавление модуля предсказания поведения, а также потребует доработки планировщика под новый тип объектов.
По мере развития каждый модуль усложняется, добавляется поддержка большего числа краевых случаев. Процесс усложнения заканчивается, когда робот начинает достигать целевых метрик, подтверждающих его эффективность.
Возникновение потребности в симуляторе
Пайплайн робота — это не просто программа на компьютере, которая может жить собственной жизнью. Через модуль управления робот взаимодействует с окружающим миром. А этот мир влияет на робота. Робот чувствует воздействия мира через сенсоры и меняет своё поведение. Поэтому события снаружи не менее важны для робота, чем то, что выполняется в каждом модуле.
Важность того, что происходит за пределами, сказывается на процессах разработки: запустить тест в изоляции также недостаточно. Важна реакция окружающего мира на действия робота. Для продуктового успеха нужно уметь тестировать все модули, оценивая успешность работы по влиянию на окружающий мир.
Начнём с самого простого и очевидного решения: будем тестировать пайплайн на реальном роботе в типичной среде обитания. Но не всегда простое — значит эффективное. Несмотря на высокую достоверность, такие тесты дорогие и опасные: ошибка в пайплайне может привести к ущербу окружению и непредвиденным поломкам. Рассказы многих стартапов про то, как у них было всего лишь два робота, которые большую часть времени проводили в ремонте, — не редкость.
Можно обратиться в другую крайность: забыть про связь с внешней средой. Для этого можно использовать записанные данные с сенсоров во время ручного управления в качестве входа для пайплайна, сделать вид, что все отправленные команды будут выполнены идеально, и на этом построить тесты системы.
Такой режим работы пайплайна называется open loop. Таким тестам не всегда можно доверять. Особенно тяжко приходится модулю управления. Его ключевая функция — сводить разницу между отправленным поведением и реальностью. А как протестировать возложенную ответственность, если в open loop-симуляции разницы нет?
Самый современный подход, позволяющий решить всплывшие проблемы, заключается в построении программной модели окружающий среды, симулятора. Режим работы пайплайна вместе с симулятором, моделирующим среду, называется closed loop.
Это решение тоже не лишено минусов. Closed loop повышает достоверность тестов ценой потребления дополнительных ресурсов. Причём иногда объём ресурсов на симуляцию соизмерим со стоимостью работы пайплайна.
Современные методы симуляции на базе нейронных сетей работают в десятки, а то и сотни раз медленней, чем поступают реальные данные с сенсоров, при этом потребляя значительный объём вычислительных ресурсов. Кроме того, достоверность результатов тестирования будет напрямую зависеть от качества симуляции. Хоть оба минуса являются устранимыми в перспективе, на данный момент они не позволяют использовать полную симуляцию на 100%.
Построить универсальный симулятор, который умеет симулировать сенсоры робота с высокой достоверностью, — сложная задача. Можно ввязаться в разработку ключевого инструмента на технологиях, которые ещё не проверены временем. В этом случае вся разработка становится подвешенной, а результат — не прогнозируемым.
К счастью, пайплайновая организация кода помогает выходить из подобных проблем. Можно скомбинировать тестирование в режиме open и closed loop. Например, симулировать работу модулей восприятия и локализации тривиальным способом, либо выдавая «идеальные» предсказания, либо полагаясь на историю. Основная часть пайплайна будет тестироваться в closed loop, а модули восприятия и локализации — в open loop.
Такой подход к тестированию гораздо проще, чем закопаться в симуляцию сенсоров. Это компромисс между достоверностью запуска и возможностью тестировать пайплайн не на реальном роботе в принципе. Такое большое изменение влияет на выбор интерфейсов между модулями, используемые подходы внутри каждого модуля, да и на всю систему в целом.
Помните, мы обсуждали структурированные и неструктурированые представления в модуле восприятии? Представить, как изменит своё положение коробочка-предсказание для автомобиля, гораздо проще, чем нарисовать эволюцию карты занятости.
Возможно, вы подумали, что симуляция — это что-то про качество жизни разработки. И всегда можно сделать жизнь разработчика интересней, приятней и комфортней. На самом деле вопрос тестирования в симуляции становится ключевой активностью для многих робототехнических команд.
Что делать, если робот опасный и нет хорошей системы страховки? Для первых запусков симуляция — спасение. Разработка практически полезных роботов задаёт высокую планку для многих требований, большое количество физических устройств и компонентов порождает длинный хвост ситуаций, когда что-то может пойти не так.
Всё вместе настолько удлиняет практический цикл разработки фичи, что ставит под сомнение существование проекта. И с этим тоже помогает симуляция.
Подведём итоги
Пайплайн робота — вещь сложная. Поэтому у нас и получился такой долгий и сложный разговор. Давайте попробуем собрать вместе всё, что мы узнали.
Мы поговорили про то, как выглядит классический пайплайн настоящего робота. Он всегда состоит из модулей, чтобы обуздать возникающую сложность.
Модули выстроены в две основные цепочки: построение модели мира и управление роботом, опираясь на эту модель. Обе должны регулярно обновлять результаты: робот должен узнавать, как меняется мир, а цепочка управления должна на лету менять маршруты и действия.
Дальше мы погрузились в стратегию построения пайплайна. Оказывается, удачного робота можно построить кучей разных способов, и ценность от пайплайна возникает ещё до того, как мы закончили разрабатывать последний модуль.
Наконец, мы осознали влияние связи «робот — среда» на разработку. Взаимодействие со средой разнообразное, требований много, и без симуляции среды разработка каждой фичи превращается в построение пирамиды Хеопса: много сил потрачено, результат не пропорционален вложениям, а до значимого увеличения ценности — годы работы.
Смотря на компоненты, сложно почувствовать полную картину, поэтому в следующем параграфе мы осознанно будем смотреть на наш пайплайн только с высоты птичьего полёта, со стороны системных свойств. Только так рождается интуитивное понимание про «долго, дорого и сложно» в разработке полезного робота.